GLM-5.3とGLM-5.2の違いは?
GLM-5.3とは、Z.aiが2026年8月14日に公開した大規模言語モデルのことです。 GLM-5.2との違いは学習の中身にあり、ベースモデルは同じです。GLM-5.3-FlashはMITライセンスで公開され、旗艦はMITではありません。
ベースモデルは同じで、伸びたのは事後学習の分
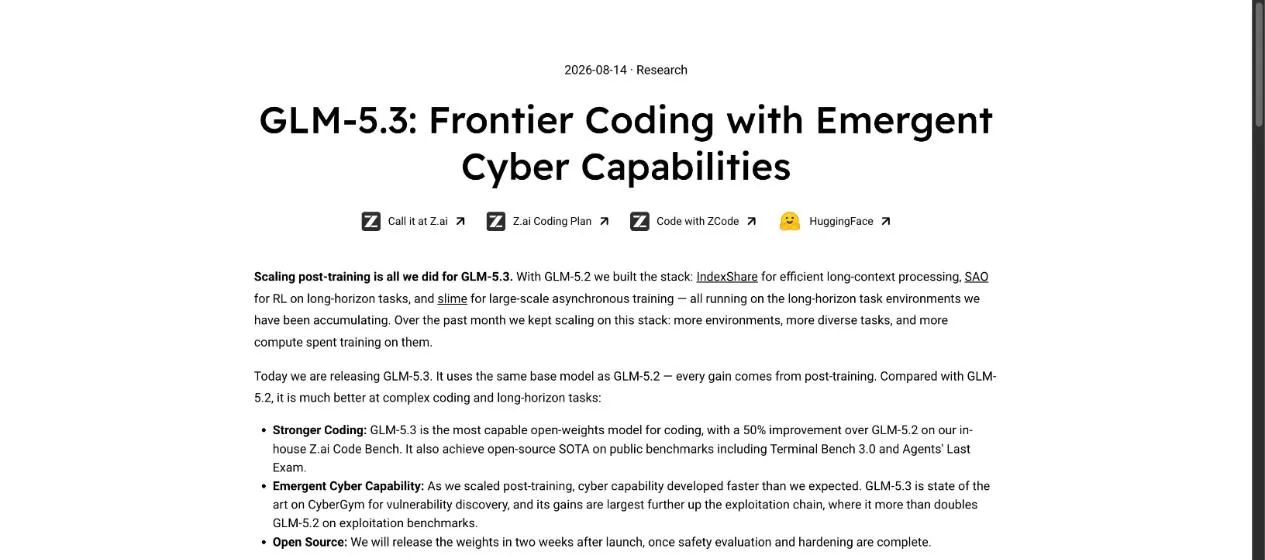
Z.aiによると、GLM-5.3はGLM-5.2と同じベースモデルを使い、性能の伸びはすべて事後学習によるものです。公開前の1か月は、GLM-5.2と同じ構成のまま、次の3つを増やして学習を継続したとのこと。
- 学習用の環境の数
- 課題種類の幅
- 学習にかける計算量
いずれも事後学習の中身を広げる手段です。ベースモデルの作り直しは含まれません。
"It uses the same base model as GLM-5.2 — every gain comes from post-training."(冒頭)/"Over the past month we kept scaling on this stack: more environments, more diverse tasks, and more compute spent training on them."(冒頭)— Z.ai 公式ブログより公式情報を見る →
コーディング性能は社内ベンチで50%向上
コーディング性能は、社内ベンチマークのZ.ai Code BenchでGLM-5.2比50%改善しました。このベンチマークは公開されていない社内用で、実際の開発に近いローカル環境にエージェントを置いて評価します。公開の試験問題を使わないため、問題が学習データに混ざる影響を抑えられるとのこと。また、Z.aiはGLM-5.3をコーディング用途で最も高性能なオープンウェイトモデルとしています。
公開ベンチのTerminal Bench 3.0とAgents' Last Examでも、Z.aiはオープンソースモデルとして最高の成績と位置づけています。公式表の数字は次のとおりです。
| ベンチマーク | GLM-5.3 | GLM-5.2 | Mythos 5(公式表の表記はFable 5 w/ fallback) | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal Bench 3.0 | 28.3 | 4.6 | 33.7 | 34.6 |
| DeepSWE v1.1 | 66.9 | 46.2 | 69.7 | 72.7 |
| Agents' Last Exam | 28.5 | 23.8 | 23.8 | 28.6 |
GLM-5.3の点数は、3つのベンチマークともGLM-5.2より伸びました。Agents' Last ExamではMythos 5を超え、GPT-5.6 Solとは0.1ポイント差です。Terminal Bench 3.0とDeepSWE v1.1では2つの商用モデルに届いておらず、最上位の商用モデルを超えるとまでは、公式表の数字からは言えません。
"Stronger Coding: GLM-5.3 is the most capable open-weights model for coding, with a 50% improvement over GLM-5.2 on our in-house Z.ai Code Bench. It also achieve open-source SOTA on public benchmarks including Terminal Bench 3.0 and Agents' Last Exam."(要点の箇条書き)— Z.ai の GitHub リポジトリより公式情報を見る →
"GLM-5.3 improves from 4.6 to 28.3 on Terminal-Bench 3.0, from 46.2 to 66.9 on DeepSWE v1.1, and from 23.8 to 28.5 on Agents' Last Exam."(Stronger Coding の節)/"As a private benchmark, Z.ai Code Bench also reduces the risk of contamination from public test sets and gives us a more faithful measure of real-world user experience."(Stronger Coding の節)— Z.ai 公式ブログより公式情報を見る →
CyberGymの公式ベンチマークでトップのモデルは何か
GLM-5.3は脆弱性発見を評価するCyberGymで84.5%となり、公式表のトップです。 CyberGymは、ソースコードを閲覧できる状態でモデルに脆弱性を探させ、実際に不具合まで起こせるかを調べる評価を指します。
CyberGym(脆弱性発見・%)
公式表の得点(%)。GLM-5.3の棒だけ色を変更している。


Mythos 5の83.8%とGPT-5.6 Solの83.6%を超え、Z.aiは84.5%をベンチマークの最高値としています。ただしトップといっても、上位3モデルの差は0.9ポイントにとどまり、前世代のGLM-5.2からの伸び(7.3ポイント)のほうが大きい結果です。Z.aiはサイバー分野の伸びを、学習を重ねるうちに想定より速く進んだものとしています。
"On CyberGym, which starts from white-box source code and tests whether the model can identify and validate vulnerabilities by triggering faults, GLM-5.3 scores 84.5%, up from GLM-5.2's 77.2% — the best result on the benchmark, ahead of Mythos 5 (83.8%) and GPT-5.6 Sol (83.6%)."/"As we scaled post-training, cyber capability developed faster than we expected."(いずれも Emergent Cyber Capability の節)— Z.ai 公式ブログより公式情報を見る →
ExploitBenchでは上位モデルに届かない
ExploitBenchは実在の脆弱性とその悪用に深い推論を求める評価で、GLM-5.3は54.4%と上位モデルに届きません。GLM-5.2の24.4%の2倍超に伸びた一方、Mythos 5は78.0%、GPT-5.6 Solは76.5%です。また、Z.aiは攻撃の実行に近い評価ほどGLM-5.2からの伸びが大きく、クローズドモデル(重み非公開の商用モデル)との残りの差も大きいとしています。
"On ExploitBench, which requires deeper reasoning about real vulnerabilities and their exploitation, GLM-5.3 reaches 54.4%, more than doubling GLM-5.2's 24.4%, while Mythos 5 and GPT-5.6 Sol score 78.0% and 76.5%, respectively."/"The pattern across the three is consistent: the further up the exploitation chain a benchmark sits, the larger the gain from GLM-5.2 — and also the wider the remaining gap to the closed frontier."(いずれも Emergent Cyber Capability の節)— Z.ai 公式ブログより公式情報を見る →
実コードで2,436件の脆弱性を検出
Z.aiは実際に公開されているソフトウェアのコードをGLM-5.3に解析させ、269のプロジェクトから2,436件の脆弱性を見つけました。 中国国内のセキュリティチームと組み、専門家による選別と重複除去を経た件数で、うち1,097件は深刻度が中から高です。何年も、長いものでは数十年にわたって見過ごされてきた不具合が含まれ、最も古いものはおよそ40年前に遡ります。
"the model identified 2,436 vulnerabilities across 269 projects, including 1,097 medium-to-high severity issues."/"Many had remained unnoticed for years or even decades, with the oldest dating back roughly 40 years."(いずれも Emergent Cyber Capability の節)— Z.ai 公式ブログより公式情報を見る →
公開後に出た評価のうち個人検証と独立ベンチを紹介
公開後の評価として取り上げるのは、個人検証と独立ベンチの2件です。ただし、どちらもZ.aiによる測定ではなく公式ベンチとは位置づけが異なります。
公開後の評価2件の出どころと位置づけ
| 出どころ | 内容 | 位置づけ |
|---|---|---|
| Pardeeの作業記録(ericpardee.github.io) | タブレットのroot化を1日で完了 | 1人・1案件の事例 |
| 独立ベンチEd-o-meter(reinvently.co.uk) | 28タスクで全分野100%を達成した初のモデル | 第三者測定・試行は限られる |
タブレットのroot化が1日で終わった個人検証
Eric Pardee氏の作業記録では、タブレットのroot化をGLM-5.3が1日で終わらせました。 root化とは、スマートフォンやタブレットの管理者権限を取る作業のことで、Pardee氏は対象のAmazon Fire HD 10(2021年モデル)にそれまで5か月を費やしていました。
費用は合計266.15ドル(約4万2,321円)でした。内訳は次の3つです。
- 脆弱性の悪用方法を見つけた分は、Kimi K3の164.25ドル(約2万6,120円)
- 致命的な不具合を特定した分は、GLM-5.2の21.90ドル(約3,482円)
- 作業を終えた分は、GLM-5.3の月額プランの80ドル(約1万2,720円)
作業は、月額プランを契約した初日に終わりました。機器の電源が勝手に落ちる症状は、Amazon製のパッケージ(最初から入っているアプリ)を100個削除すると出なくなったとPardee氏は書いています。
この記録はHacker News(技術系の掲示板)にも投稿されました。2026年8月26日の時点で、694ポイント(読者からの支持票)と291件のコメントを集めています。
1人・1案件の記録は、公式ベンチの数字とは性質が異なります。Pardee氏も、作業の方向を指示する役に徹したと振り返っています。Pardee氏が記録を書いた2026年8月23日時点で、GLM-5.3はZ.aiのCoding Plan経由でしか使うことができませんでした。AnthropicとOpenAIのモデルは安全上の制限で作業を続けられなかったと、Pardee氏は作業記録に記しました。
"Owning it for real cost another $266.15: Kimi K3 found the exploit for $164.25, GLM-5.2 caught its fatal bugs for $21.90, and GLM-5.3 finished the job in one day on day one of an $80 subscription."/"GLM-5.3 finished the job in a single day, on day one of an $80 subscription, and removed 100 Amazon packages."/"Cost: $266.15 and five months."/"my honest contribution was steering"/"It was available only through Z.ai's own Coding Plan"/"It wasn't allowed to summarize its own previous work on my own device."(冒頭の要約/tl;dr 節/The prompt kiddie 節/GLM-5.3 節/Meanwhile, the Great Wall of US AI 節)— Pardee 本人の作業記録より公式情報を見る →
"I spent $266 and four AI models to own my tablet. GLM-5.3 finished it in a day"(投稿タイトル。リンク先は ericpardee.github.io の作業記録で、2026年8月26日の確認時点で694ポイント・291コメント)— Hacker News より公式情報を見る →
Ed-o-meterで全分野100%を通過した独立ベンチ
Ed-o-meterでは、GLM-5.3が5分野すべてで課題を100%クリアした初のモデルでした。 Reinventlyが公開するEd-o-meterは、共通のプロンプトを複数のモデルに与え、28の実務タスクを同じ基準で採点します。対象は、コーディング・データ・実務・セキュリティ・ツール利用の5分野です。
ルーブリック(採点基準表)の点数は10点満点で9.3でした。28タスクにかかった費用は0.28ドル(約44.5円)で、gpt-5.5の1.43ドル(約227円)のおよそ1/5です。一方で最初の出力が表示されるまでの時間は中央値16.3秒で、gpt-5.5の13.2秒より長くかかります。
ただしEd-o-meter側も、試行回数が限られていて数字のブレ(ウィルソン区間)が広いとしています。順位を実力差として受け取ることはできません。
"glm-5.3 is the first model on the board to clear all five corners — coding, data development, realworld, security and tasks — at 100%."/"As we only had a limited number of trials there is a wide Wilson interval — the whiskers on the chart."(If you only run one model 節/結果表の注記)— Reinvently の Ed-o-meter より公式情報を見る →
GLM-5.3とGLM-5.3-Flashの違いは?
GLM-5.3とGLM-5.3-Flashは別のモデルで、Hugging Faceでは別々のリポジトリとして公開されています。Hugging Faceは、モデルの重みを公開するサイトです。Z.aiは8月14日のモデル公開時に、公開から2週間後、安全性評価と堅牢化を終えた段階で重みを出すと予告していました。
その後、8月25日に旗艦とFlashのリポジトリが作成されました。 Z.aiは翌26日の公式ブログでも、Flashの重みの公開を発表しています。
"Open Source: We will release the weights in two weeks after launch, once safety evaluation and hardening are complete."/"The model weights of GLM-5.3 will be publicly available soon in two weeks."(要点の箇条書き/Serve GLM-5.3 Locally 節)— Z.ai 公式ブログより公式情報を見る →
旗艦の重みはHugging Faceで公開済み
旗艦のzai-org/GLM-5.3は、Hugging Faceのzai-orgアカウントで公開されています。また、旗艦もFlashもモデル一覧に公開されています。 2つの違いは次のとおりです。
| 対象 | 旗艦 | Flash |
|---|---|---|
| リポジトリ | zai-org/GLM-5.3 | zai-org/GLM-5.3-Flash |
| 精度を高く維持したバージョン | zai-org/GLM-5.3-BF16 | zai-org/GLM-5.3-Flash-BF16 |
| Hugging Faceの分類 | text-generation(文章の生成) | image-text-to-text(画像と文章の入力に対応) |
| ライセンス表示 | other | mit |
"id":"zai-org/GLM-5.3" … "license:other" … "createdAt":"2026-08-25T06:42:50.000Z"/"id":"zai-org/GLM-5.3-BF16" … "license:other" … "createdAt":"2026-08-25T06:43:55.000Z"/"id":"zai-org/GLM-5.3-Flash" … "license:mit" … "createdAt":"2026-08-25T06:43:14.000Z"(zai-org のモデル一覧の各エントリ)— Hugging Face の公開 API レスポンスより公式情報を見る →
旗艦とFlashそれぞれのライセンス条件
ライセンスはFlashがMITで、旗艦はMITではありません。 Hugging Faceの一覧では、Flashがlicense:mit、旗艦がlicense:otherと表示されています。
商用で使う場合は、旗艦のLICENSEファイルに記載の条件を確認したうえで判断する必要があります。otherという表示だけでは、商用利用の可否は判断できません。
"license:other"/"license:mit"(旗艦 GLM-5.3 と GLM-5.3-Flash の tags より)— Hugging Face の公開 API レスポンスより公式情報を見る →
ローカル実行の前に確認したい重みの容量
重みの容量は、各リポジトリの「Files and versions」タブに表示されるファイルサイズで確認することができます。 ローカル環境で実行するのに必要なメモリやディスクの大きさは重みの容量で変わるため、先に確認しておくといいでしょう。
一覧では、旗艦・Flashとも通常のリポジトリにfp8のタグが付き、BF16を名前に持つバージョンが別のリポジトリになっています。BF16は数値の精度を高く維持した形式で、同じモデルなら容量が大きくなるのが一般的です。容量の数字は、Z.aiの公式ブログにもHugging Faceのモデル一覧にも掲載されていません。
"id":"zai-org/GLM-5.3-BF16"/"id":"zai-org/GLM-5.3-Flash-BF16"/"fp8"(GLM-5.3 本体と GLM-5.3-Flash の tags より)— Hugging Face の公開 API レスポンスより公式情報を見る →
GLM-5.3のCoding PlanとAPIでの使い方
GLM-5.3は、APIとGLM Coding Planの両方で使うことができます。また、GLM Coding Planの全ユーザーに提供され、ZCode・Claude Code・OpenCodeなどのコーディングエージェントで利用できます。 新しいGLM Coding Planの利用上限は、ポイント制に変わりました。
重みをダウンロードしたくない場合は、APIかCoding Planのどちらかを使います。ローカル環境で動作させたい場合は、旗艦かFlashの重みをHugging Faceから入手します。
"Try GLM-5.3 in your favorite coding agents—ZCode, Claude Code, OpenCode, and more."/"We’ve rolled out GLM-5.3 to all GLM Coding Plan users. The new GLM Coding Plan now uses a points-based quota system."(いずれも Use GLM-5.3 with GLM Coding Plan & ZCode の節)— Z.ai 公式ブログより公式情報を見る →
思考オフ廃止でAPIの指定が変わる
GLM-5.3のAPIでは、思考(thinking)をオフにする指定が廃止されました。 思考の強度は、reasoning_effortでlow・high・maxの3段階から選びます。Z.aiはコーディング用途にmaxを勧めています。
これまでthinking.typeにdisabledを指定していたアプリは、モデルIDだけをglm-5.3に変更するとリクエストが失敗します。先にthinking.typeをenabledにし、reasoning_effortをlowにしてから、モデルIDを更新してください。
GLM-5.3は、ベースモデルを変えずに事後学習だけでコーディング性能を伸ばしたモデルです。重みは旗艦とFlashが別々に公開され、ライセンスも別です。
"Disabling thinking is no longer supported by GLM-5.3."/"Migration required: If your application currently uses thinking.type: \"disabled\", change it to enabled and set reasoning_effort to low before updating the model ID to glm-5.3. Otherwise, the request will fail."(いずれも API Changes in GLM-5.3 の節)— Z.ai 公式ブログより公式情報を見る →
FAQ
- GLM-5.3はGLM-5.2から何が変わったのですか?
- ベースモデルは5.2と同じで、伸びはすべて事後学習によるものです。Z.aiは社内ベンチマークのZ.ai Code Benchでコーディングが5.2比50%改善し、オープンウェイトのコーディングモデルとして最も高性能だとしています。
- GLM-5.3のサイバーセキュリティ性能はどれくらいですか?
- 脆弱性発見を評価するCyberGymで84.5%を記録し、5.2の77.2%から伸びました。Z.aiはこれをベンチマーク最高で、Mythos 5の83.8%やGPT-5.6 Solの83.6%を超えるとしています。
- GLM-5.3の重みはどこで手に入りますか?
- Hugging Faceのzai-orgアカウントで、旗艦のGLM-5.3とGLM-5.3-Flashが別々のリポジトリとして公開されています。リポジトリの作成日はどちらも2026年8月25日です。ライセンスはFlashがMITで、旗艦はMITではなくotherと表示されています。
- GLM-5.3のAPIで思考をオフにできますか?
- できません。GLM-5.3は思考の強度をlow・high・maxの3段階で指定する方式で、思考オフは廃止されました。これまでthinking.typeにdisabledを指定していたアプリは、enabledに変更してreasoning_effortをlowにしてからモデルIDをglm-5.3へ更新する必要があります。
関連する記事
 GLM-5.2とは?MITライセンスの744Bオープンモデルの性能と料金GLM-5.2はZ.aiがMITライセンスで公開したオープンウェイトの大規模言語モデルで、総パラメータ744Bのうち1トークンで動作するのは約40Bです。API料金は100万トークンあたり入力1.4ドル(約226円)・出力4.4ドル(約711円)で、Coding PlanではGLM-5.2を指定してもGLM-5.3が動作します。
 CloudflareのGLM-5.3で155件の応答に他人のリクエスト内容が混入Cloudflare Workers AIのGLM-5.3で、8月27日〜9月9日に155件の応答へ他人のリクエスト内容が混ざりました。681,280トークンを超える長い入力への応答だけが対象です。Cloudflareは設定の不一致と推論エンジンSGLangの不具合が重なったと説明し、修正済みとのこと。
 Colibrìとは?744Bモデルを16GBのPCで実行する推論エンジンColibrìはGPUも依存ライブラリも必要ない純Cの推論エンジンです。モデルの大半をNVMeに置いて必要な分だけ読み込むことでRAMの使用量を抑え、744BパラメータのGLM-5.2をRAM16GBのPCで動作させます。ローカルLLMの必要スペックと環境ごとの実測速度を公式資料から整理しています。
 オープンウェイトモデルとは?オープンソースとの違いとライセンスを解説オープンウェイトモデルは、AIが学習で身につけた数値(重み)を公開し、誰でもダウンロードして自分のPCやサーバーで実行できるモデルです。学習データやコードまで公開するオープンソースAIとの違いと、ローカル環境で動作させる利点と注意点を解説します。商用利用できる範囲は、モデルごとのライセンス次第です。