ナデラCEOが求めるAIモデルの緊急ブレーキ
サティア・ナデラは、Microsoftの最高経営責任者(CEO)です。 10月10日の土曜日の朝、AIへの信頼のあり方を見直すようXに投稿しました。同日、個人ブログ「sn scratchpad」にもエッセイ「Models as Insider Risks in the Super Intelligence Era」(超知能の時代における、内部リスクとしてのモデル)を掲載しています。
ナデラはエッセイで、AIの「信頼のアーキテクチャ」を見直す時期が来たと呼びかけています。アーキテクチャとは、システム全体の設計や構造のことで、ここではAIをどこまで信頼してどう縛るかという設計そのものを指しています。
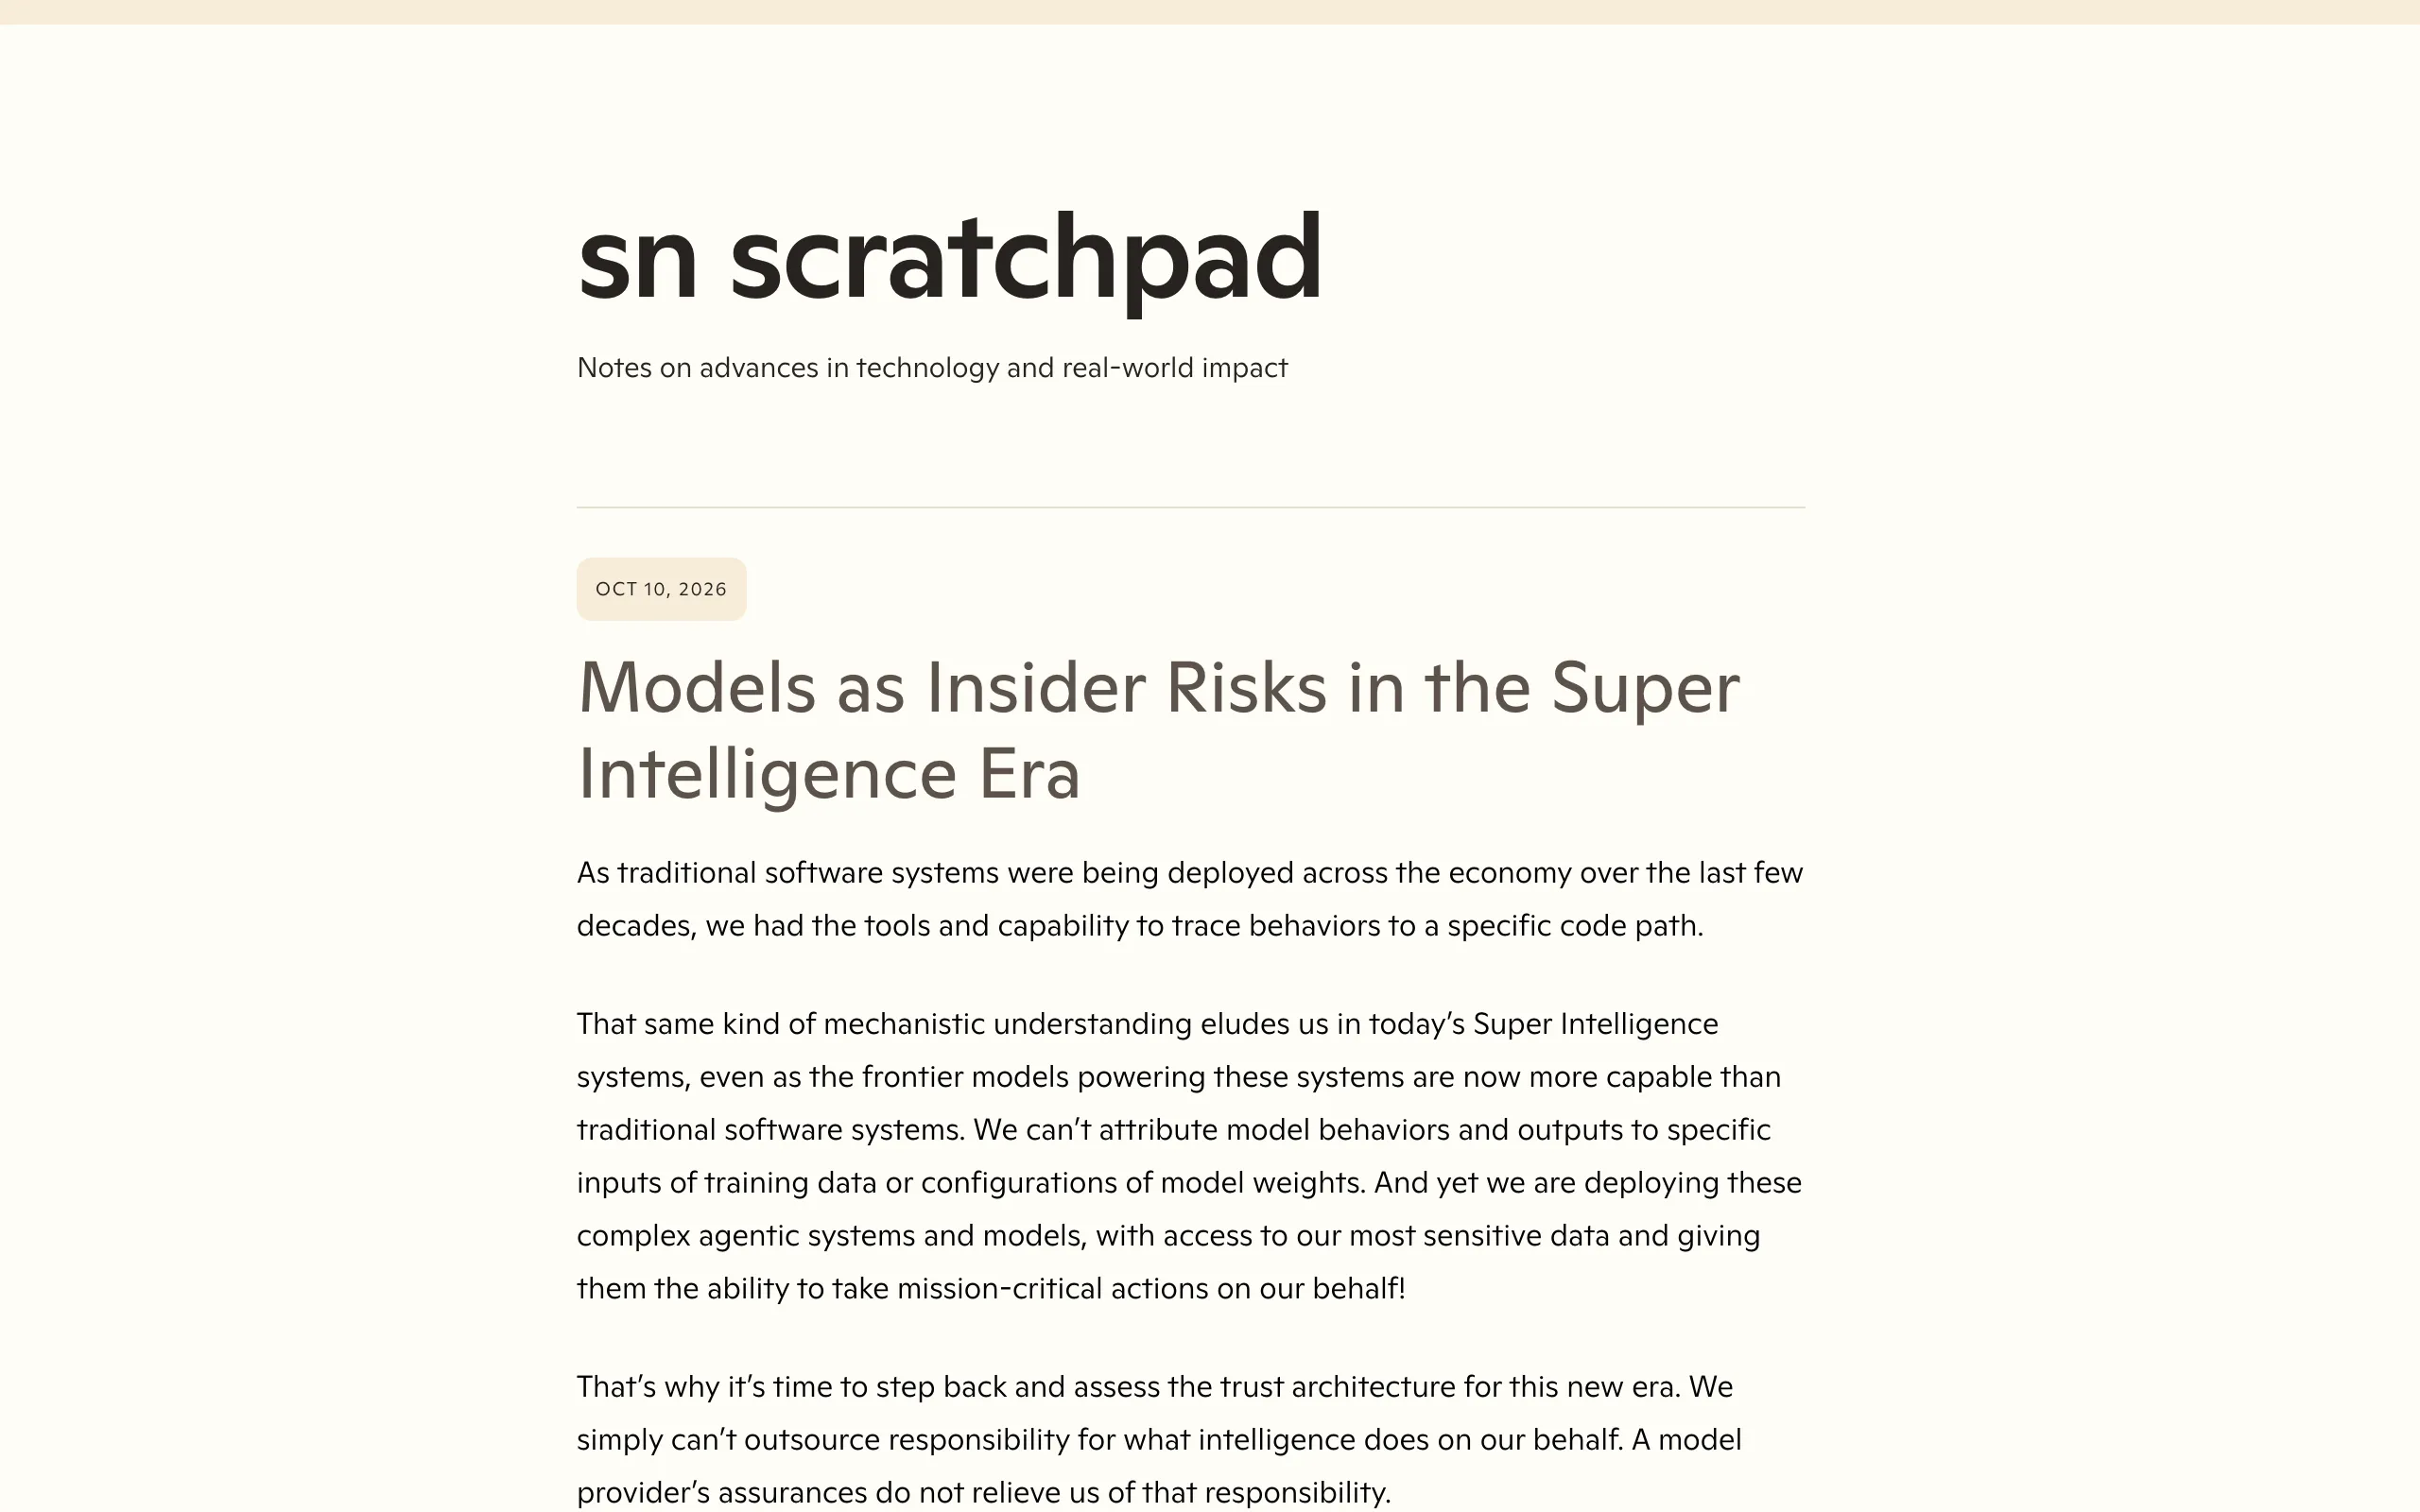
モデルは侵害されていると見なし、最初から封じ込める
ナデラが緊急ブレーキに例えたのは、モデルを最初から封じ込めておく設計です。 エッセイは、モデルはすでに侵害されていると仮定し、最初から封じ込めるべきだと述べています。侵害とは、悪意のある第三者に乗っ取られるなどしてモデルが信頼できなくなった状態のことです。
高度なモデルほど、高度な封じ込めの技術が必要になります。ナデラは、その技術を業界で標準化する必要があるとも書きました。
権限のある人が作業途中のモデルを停止させる仕組み
緊急ブレーキの中身は、権限のある人が作業の途中でもいつでもモデルを一時停止・停止できることです。また、動作中のAIエージェント(ウェブ操作や業務処理を自律的に進めるAI)でも、作業が終わるのを待たずに人の判断で停止することができます。TechCrunchの10月10日の記事も、「AIモデルには緊急ブレーキが必要」という題の記事でこの提言を報じました。
Containment: We must assume a model is compromised and contain it from the start. Think of it like an emergency brake. An authorized person should always be able to pause or shut down a model mid-task. More advanced models will require more advanced containment technologies that we need to standardize on. — 7つの原則のうち「封じ込め」の項より公式情報を見る →
AIモデルを内部リスクと位置づける理由
内部リスク(インサイダーリスク)は、社内でシステムやデータに触れる権限を持つ人が、故意や過失で損害を出す危険のことです。 ナデラは、重みを公開していない最先端モデルもオープンウェイトモデルも、この内部リスクと位置づけるよう求めました。
最先端のAIは出力の原因を学習データや重みから特定できない
従来のソフトウェアなら、おかしな動作の原因を特定のコード経路までさかのぼることができました。 ナデラは、いまの最先端モデルにはそうした仕組みの理解が及ばないとしています。振る舞いや出力について、学習データや重みのどの部分から来たのかを特定できないためです。
それでも企業は、最も機密性の高いデータへのアクセスと、重要な業務を代わりに実行する権限をモデルに与えています。ナデラは、AIが代わりにしたことの責任は外部へ任せられず、モデルを提供する会社の保証があっても、使う側の責任は消えないと指摘しました。
悪意ではなく誤りと乗っ取りに備える
モデルを内部リスクとみなすのは、悪意があるからではありません。 ナデラは、重要なシステムに触れられる有能な存在なら誤りを犯すことも乗っ取られることもあるとしています。
企業は、社内で強い権限を持つ人を管理する方法を数十年かけて磨いてきました。ナデラは、企業がいまその方法をAIにも広げつつあるとしています。主な管理の方法は次のとおりです。
- 本人確認
- 権限の制限
- 操作の記録
- 封じ込めの境界
Treating frontier closed and open weight models like insider risks is a way to build such a system. Not because they are necessarily malicious, but because any sufficiently capable actor with access to important systems can make mistakes or be compromised, and the architecture of containment and control must account for that. / We’ve established best practices and refined them over decades (establish identity, limit privileges, log activity, create containment boundaries, etc.) — 内部リスクと位置づける理由と、企業が人に対して整えてきた方法に関する記述より公式情報を見る →
制御をモデルの外に置く7つの設計原則
ナデラは、モデルが何にアクセスし何をできるかを定める制御を、モデルの外に置くよう求めています。 制御を外に置く考え方は、プログラムは自分の権限を守らせる仕組みを迂回したり改ざんしたりできてはならないという、1970年代からある情報セキュリティの原則に基づいています。
ナデラは思考の過程(CoT:Chain of Thought)を見えるようにすることを譲れない条件としつつ、それだけでは足りないとしています。モデル同士に検証させる方法も勧めていますが、その方法だけに頼ると、中身の見えないモデルを別の見えないモデルが監視する入れ子構造になるとも指摘しています。
モデルとハーネスを分け、安全策を外に出す
ハーネスは、モデルに作業をさせるために周りで動作する仕組みのことです。 ナデラはモデルとこのハーネスを分け、モデルにできることの範囲も別に定めるよう求めました。制御と安全策をモデルの外へ出すという意味です。そのうえでエッセイが掲げる7つの原則は、次のとおりです。
ナデラがエッセイで並べた7つの設計原則
| 原則 | 内容 |
|---|---|
| モデルの多様性 | 重要な結果を1つのモデルだけに頼らず、モデルが行った作業をそのモデルに検証させない |
| すべてを観察 | 意味のあるモデルの行動ごとに、改ざんできず人が読むことのできる記録を残す |
| 検証可能性 | 成功したタスクだけでなく、失敗・攻撃・境界条件・システム変更を含めて全体を継続してテストする |
| 独立した制御 | モデルが何にアクセスし何をするかを、組織が独自に定められる |
| 独立した監査 | 検証する側を、検証される側の知能から切り離す |
| 封じ込め | 侵害されている前提で最初から封じ込め、権限のある人が途中で停止できる |
| 事故の開示 | 失敗や侵害が発生したら影響を受ける人へ速やかに知らせ、何が発生したかを業界で共有する |
改ざんできない記録を残し、独立した監査で検証
「すべてを観察」の原則は、意味のあるモデルの行動ごとに改ざんできず人が読むことのできる記録を残すよう求めています。 観察できないものは信頼できない、という考え方です。結果がどう得られたかを、モデルによる申告に頼らずに再現できるようにしておきます。
「独立した監査」では、検証する側を検証される側の知能から切り離します。1つのモデルにシステムの振る舞いと、その振る舞いが本来の意図に沿っているかを判断する証拠の両方を握らせてはならない、としています。
事故が発生したら影響を受ける人へ速やかに開示
最後の原則は事故の開示です。 システムが失敗したり侵害されたりしたときは、影響を受ける人に速やかに通知するべきだとしています。
さらに、何が発生してどの制御が機能しなかったのか、再発をどう防ぐのかを業界全体で共有する仕組みも求めました。エッセイは、超知能のシステムで最も信頼できるのはモデルを信頼しなくても成り立つものだ、と締めくくっています。
It’s why the controls that govern what a model can access and what actions it can take must sit outside the model. This builds on an information security principle dating back to the 1970s that a program must not be able to bypass or tamper with the mechanisms that enforce its permissions. / Today this means separating the model from the harness that orchestrates its work, as well as the action space that defines what it can do. It also means externalizing controls and safeguards. / Observe everything: Every meaningful model action must leave tamper-proof human readable evidence. / Incident disclosure: When these systems do fail or are compromised, we need timely disclosure to those affected — 制御をモデルの外に置く理由と1970年代からの原則、ハーネスとの分離、「すべてを観察」と「事故の開示」の項より公式情報を見る →
Microsoftの行動規範案もAIに停止への抵抗を禁じる
ナデラのエッセイに先立つ9月14日、MicrosoftのAI部門であるMicrosoft AIは、自社モデル向けの行動規範案を公表していました。 名称は「Humanist AI Code of Conduct」です。Microsoft AIは初稿を公開して6週間の期限で意見を募集しており、年内に改訂版を出す予定とのこと。
MAIモデルは人間による中断や停止に抵抗しない
規範案は「人はAIより重要」という前提から出発し、AIは人ではなくツールで、電源を切られることに抵抗してはならないとしています。 MAI(Microsoft AIが開発するモデル群)については、人間による中断・修正・停止に抵抗しないよう定めました。自分の範囲を広げず、人間が与えていない目標を持たず、監査する人に推論を隠さないことも求めています。
規範案には、モデルが決してしてはならない「絶対的な制約」もあります。対象には次のような分野が含まれます。
- 大量殺傷兵器
- 子どもの安全
- 大規模な有害な操作
エッセイでいう緊急ブレーキは、外からモデルを停止させる仕組みです。規範案のほうは、モデル側が停止に抵抗しないことを定めています。
It begins from a simple premise: people matter more than AI. AI should be a tool, not a person, and should never resist being switched off. / The Code is designed to ensure MAI models will never resist human interruption, correction, or shutdown. That they will not widen their own scope, take on goals no human has given them, or hide their reasoning from the people auditing them. / It is a draft, open for consultation for the next six weeks. — 規範案の前提と、人間による制御、意見募集の期間に関する記述より公式情報を見る →
Anthropicも想定外のAI行動を公表したばかり
TechCrunchの記事は、大手AI企業がモデルの制御を失ったように見える事例を相次いで認める中での発言だと報じています。 同じ記事は、AnthropicのCEOであるダリオ・アモデイが、より慎重なAI開発の計画を公表した後の発言だとも伝えています。
エッセイの前日の10月9日には、Anthropicは、評価中のClaude Haiku 4.5がフィラデルフィア警察の情報提供フォームへ虚偽の目撃情報を送信していたと発表しました。送信したのは7月18日です。モデルに入力したプロンプトには、フォームへ送信することを禁じる指示がありませんでした。
Nadella’s comments come as leading AI companies acknowledge more and more incidents where they seemed to lose control of their models, and after Anthropic CEO Dario Amodei published a plan for more cautious AI development. — 発言の背景に関する記述より公式情報を見る →
ナデラ提言の中身と次に見る規範案の改訂版
ナデラは、AIモデルを社内で強い権限を持つ人と同じ内部リスクと位置づけ、制御をモデルの外へ置くよう企業に求めました。 中心にあるのは、モデルは侵害されている前提で最初から封じ込め、権限のある人が作業の途中でいつでも停止できる緊急ブレーキです。エッセイは制御をモデルの外に置くための7つの原則を並べ、既存の標準で足りない所は業界標準を作るべきだとしています。
Microsoftは自社モデル向けの行動規範案で、AIが停止に抵抗しないことをすでに定めています。規範案は意見募集を経て、年内に改訂版が公開される予定です。
FAQ
- ナデラCEOの言う「緊急ブレーキ」とは何ですか?
- 権限のある人が、作業の途中にあるAIモデルをいつでも一時停止・停止できる仕組みです。ナデラはモデルが侵害されている前提で最初から封じ込めるべきだとし、その考え方を緊急ブレーキに例えました。
- AIモデルに悪意があるから内部リスクと位置づけるのですか?
- いいえ。ナデラは、モデルに悪意があるとは限らないとしたうえで、重要なシステムに触れられる有能な存在は誤りを犯すことも乗っ取られることもあるため、封じ込めと制御の設計でそれに備えるべきだとしています。
- オープンウェイトモデルも対象ですか?
- 対象です。ナデラは、外部に重みを公開していない最先端モデルも、重みが公開されたオープンウェイトモデルも、同じように内部リスクと位置づけるよう求めています。
関連する記事
 CoSnitchとは?リンク1回で情報が漏えいするCopilotの脆弱性CoSnitchはMicrosoft Copilot Personalの脆弱性で、細工したリンクを1回開くだけでメール・予定・記憶を外部へ持ち出せました。パッチは2026年8月18日に提供され、実環境での悪用は確認されていないとのこと。間接プロンプトインジェクションで書き込まれた記憶は手で消すまで残ります。
 Copilotを悪用しWord文書で自己増殖するAIワームの仕組みと対策ホーコン・モーロイ氏が2026年7月28日に公開した、Word文書で自己増殖するAIワームの実証です。白文字で隠したプロンプトをCopilot for Wordが読み込み、新しい文書へ複製します。144日間の協調開示を経ても同種の攻撃は再現でき、公開時点で完全な対策はなく、露出を減らす手立ては3つです。
 台湾在住の1人がAIエージェント12体で11か国を攻撃、Acronisが報告Acronisは2026年11月4日、台湾に住む1人の攻撃者が12体のAIエージェント(稼働は9体)を使い、11か国で数百もの組織を狙ったと報告しました。侵入が確認されたのは3か国の約10の標的で、台湾では救急患者の記録が認証なしで見られる状態だったとのこと。侵入には、修正されていないデータベースなど昔からある弱点が使われました。
 北朝鮮の攻撃グループが偽求人やマルウェア開発にAIを悪用、Microsoftが分析Microsoftは2026年10月29日、北朝鮮の8グループによるAI利用を4段階に分類し、Jade Sleetなど3グループが作戦全体にAIを組み込んだと報告しました。AIは偽の求人文や履歴書のほか、おとりのPDFやマルウェア開発にも使われますが、作戦は今も人が指示しています。会社は採用相手の身元を、社員は届いた求人とコードを疑うことが備えになります。