Anthropicが蒸留攻撃への対策を強化
Anthropicは2026年10月12日、Claudeを狙う蒸留攻撃への対策を強化したと研究ブログで発表しました。その結果、初期の段階では蒸留する側が集めることができるデータ量が約90〜99%減少したとしています。
蒸留攻撃では何が行われるのか
蒸留攻撃は、あるAIモデルの能力を開発元の許可なく別のモデルで再現する行為です。 攻撃する側は大量のプロンプトを送信して回答を集め、その回答を教材にして自社の小さなモデルを育てます。不正に作った大量のアカウントを使い、隠れて行うのが一般的です。
蒸留の手法そのものは、AI開発で広く使われています。Anthropicが問題視しているのは、開発元の許可を得ずに他社のモデルを使う蒸留です。
"Early evidence suggests that these methods have reduced the amount of data harvested by distillers by around 90 to 99%."/"Distillation attacks are covert, industrial-scale campaigns to extract the capabilities of one model and replicate them in another, without the authorization of the original model’s developers."(本文)— Anthropic より公式情報を見る →
蒸留攻撃でClaudeの推論が狙われる理由
蒸留する側が最も欲しがるのは、Claudeが回答の前に出力する推論(思考プロセス)の記録です。 最終的な回答だけでなく、どう考えて回答を導いたかまで学ばせることができるからです。
Anthropicの社内試験では、Claude Opus 4.8の推論記録で、事前学習を終えたClaudeのモデルを訓練しました。プログラミングの性能を評価するSWE-bench Verifiedのスコアは、推論の全文を使うと80.4%、要約だけだと71.8%です。全文が手に入るかどうかで、育てたモデルの性能に差が出ます。
Anthropicが蒸留攻撃を問題視する理由は2つあります。1つ目は、蒸留で作られたモデルが十分な安全対策のないまま公開され、生物兵器の開発やサイバー攻撃に悪用されかねないことです。たとえば中国のZhipuはGLM-5.3の開発中に、米国の主要モデルが持つサイバー能力を蒸留したと、Anthropicは主張しています。
2つ目は、蒸留したモデルの能力が外国の軍や情報機関、監視システムに組み込まれる恐れがあることです。蒸留したモデルの軍や情報機関への転用は「蒸留攻撃の仕組みと目的、中国の軍関連AI研究に見る敵対的蒸留」でも取り上げています。
推論を要約しても全文を出力させる手口が使われる
Anthropicが推論を要約して出力するようにすると、蒸留する側はClaudeに全文を出力させる手口に変えました。 あるAI開発企業は、1件ずつ内容の異なる1万2,000件のリクエストを試みています。
最初の安全対策が破られたあと、蒸留する側は数十万件の不正アカウントを操るプロキシ網(中継サーバーを束ねた仕組み)を作りました。2月の報告では、1つのプロキシ網が2万件を超える不正アカウントを同時に管理していたとされています。
"The most valuable kind of data for this purpose is transcripts of Claude’s reasoning—the thinking process that Claude writes out before it responds."/"When training on the full transcripts, the distilled model achieved 80.4%; with only the summarized transcripts, it achieved 71.8%."/"Zhipu, for example, distilled the cyber capabilities of leading US models during the development of GLM-5.3."(本文)— Anthropic より公式情報を見る →
Anthropicが導入した3つの蒸留攻撃対策
今回の対策は次の3つです。 Anthropicは、正当なユーザーへの影響は小さいとしています。
- 推論を読み取ることができる範囲を限定するpreserved thinking
- 推論を出力させるリクエストを遮断する2段階の分類器
- 繰り返し試すユーザーへの利用制限・アカウント停止・課金
preserved thinkingで推論の利用範囲を制限
Claude Fable 5.1とClaude Opus 5.5には、preserved thinkingという仕組みが導入されました。 2026年8月31日以降に開設したAPIアカウントでは、それまでの文脈を書き換えることができません。推論の記録を別の会話やアカウントへ移し、全文を引き出す手口を塞ぐための仕組みです。
この2モデルが出力した推論は、蒸留対策の弱い旧モデルに読み込ませることができなくなりました。Claude Sonnet 5.5では、推論の記録を読み取ることができるのはリクエストを送信した組織だけです。
2段階の分類器が推論を出力させるリクエストを遮断している
Anthropicは、生物兵器への協力を防ぐのと同じ種類の安全対策を蒸留にも使っています。 constitutional classifiersの研究で使った方式で2段階の分類器(リクエストの中身から蒸留目的かどうかを見分ける仕組み)を作り、社内外の攻撃テストで弱点を修正しました。誤検知率は0.1%未満です。
分類器は1つのモデルだけでなく、複数のモデルに組み込まれています。動作しているのは次の5つです。
- Claude Sonnet 5.5
- Claude Opus 5
- Claude Opus 5.5
- Claude Fable 5
- Claude Fable 5.1
分類器は新しい手口も遮断しています。直前の推論を別の言語に翻訳させたり、回答と並べてタグの中に出力させたりする手口です。9月の報告で取り上げた蒸留の手口も、すべて検知できるとしています。
利用制限とアカウント停止、遮断したリクエストへの課金
Claudeから推論を何度も引き出そうとするユーザーは、利用上限が厳しくなり、しつこく続けるとアカウントを停止されます。 Anthropicは9月24日から、回答前に遮断したリクエストへの課金も再開しました。対象は、蒸留を含めて誤検知率が0.1%未満の分野です。
"a measure that prevents new API accounts (those created on or after August 31, 2026) from editing Claude’s prior context."/"Specifically, we built a two-stage classifier system of the kind we described in our constitutional classifiers research."/"they have a false positive rate of less than 0.1%."/"Users who continually try to extract reasoning from Claude face stricter usage limits, and when we detect repeated and persistent attempts at distillation, we ban the associated accounts."(本文)— Anthropic より公式情報を見る →
抜き取られる推論は1/10以下に減っている
分類器を入れたあと、Anthropicのプラットフォームで抜き取られた推論の量は、導入前の1/10〜1/100以下で推移していると明らかにしました。 日によっては、計測できないほど少なかったとのこと。
Anthropicが停止したアカウントは数万件にのぼり、その多くは蒸留を開始してから2時間以内に停止されています。その代わりにAnthropicは、蒸留する側から入っていた数兆トークン分の有料利用と、その売上を手放しました。
効果がいつまで続くかはまだ分からない
この効果がいつまで続くかは分からないと、Anthropicも認めています。対策をかいくぐろうとする高度な攻撃はまだ受けていないため、現時点の数字は本格的な回避が試される前の結果です。
"After introducing the classifier, the number of reasoning tokens extracted by distillers is consistently 10 to 100 times lower than it was before"/"We’ve used these defenses to ban tens of thousands of accounts associated with distillation, often in less than two hours after such an account begins a distillation campaign."/"We’ve turned away meaningful revenue and trillions of tokens’ worth of paying traffic from distillers"(本文)— Anthropic より公式情報を見る →
Claude APIのユーザーに発生する変化
Claude CodeやClaude Agent SDKなど、Anthropicの製品を通してClaudeを使っている場合は、変更は不要です。 Claude Platform Docsによると、APIへ送信するリクエストを製品側が組み立てる場合、ユーザー側の対応は必要ありません。
ご自身のプログラムからAPIを呼び出している場合も、多くは改修が必要ありません。Claude APIでは会話が続くたびに、それまでのやり取りをまとめてリクエストに含めて送信します。最初に送信したsystemプロンプト(AIへの前提の指示)とツールの定義を変更せず、新しいメッセージを末尾に追加していくだけなら、影響は出ないとされています。
文脈を途中で書き換える実装は改修が必要になる
影響が出るのは、会話途中で過去の文脈を書き換える実装です。 たとえば次の3つの処理が対象です。
- 日付を入れてsystemプロンプトを毎回作り直す
- 古いツールの結果を消したり縮めたりする
- 古いやり取りを要約して差し替える
Claude Platform Docsの説明では、2026年8月31日00:00(UTC)以降に作られたアカウントの場合、推論ブロックより前の内容が変わっていないかをAPIがデフォルトで照合します。内容が変わっていれば、APIはリクエストを400エラーで拒否するか、無効になった推論ブロックを取り除いて処理します。どちらの動作にするかはユーザーが指定する設定です。
古いアカウントでもbetaヘッダthinking-binding-controls-2026-08-01を送信すれば、照合に通らないブロックが応答に表示されます。ご自身のアカウントでエラーが出なくても、新しいアカウントを使う人には出る場合があります。事前に照合結果を確認しておくといいでしょう。
誤検知は0.1%未満、遮断されたリクエストも課金対象
Anthropicの分類器は、0.1%未満の割合で正当なリクエストも誤って遮断し、ユーザーはその分の料金も支払います。 正当なユーザーに影響を与えずに蒸留を難しくするという2月時点の目標について、Anthropicは完全には達成できていないと認めています。
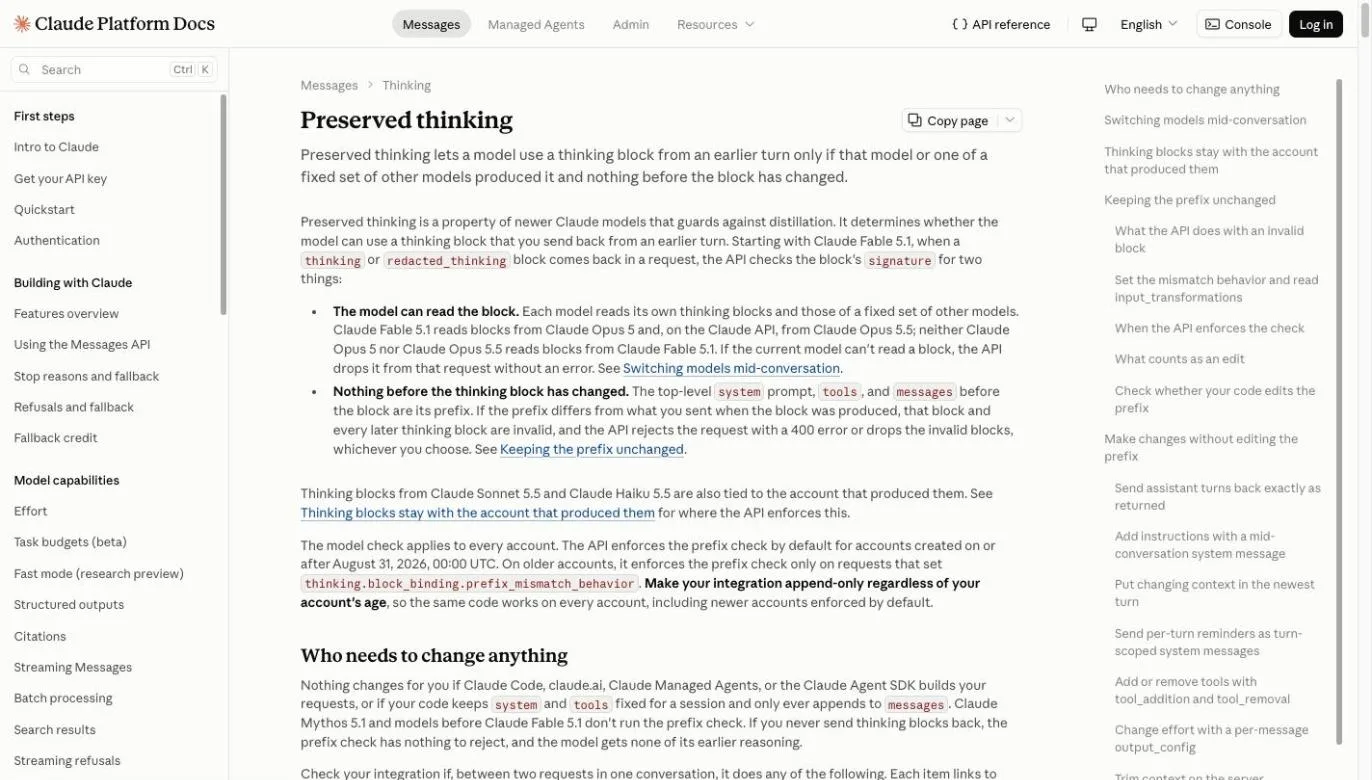
"The API enforces the prefix check by default for accounts created on or after August 31, 2026, 00:00 UTC."/"the API rejects the request with a 400 error or drops the invalid blocks, whichever you choose."(本文)— Claude Platform Docs より公式情報を見る →
まとめ:Anthropicの蒸留攻撃対策で変わること
今回導入された対策のうち、APIのユーザーに改修を求めるのはpreserved thinkingだけです。 分類器とアカウント停止はユーザー側の変更を伴わず、影響は0.1%未満の誤検知とその分の課金にとどまります。
2026年8月31日以降に開設したアカウントでは、会話途中に文脈を書き換えると400エラーか推論ブロックの除去が起こります。古いアカウントで問題が出ていなくても、新しいアカウントへ移す前にbetaヘッダで照合結果を確認できます。
FAQ
- 蒸留攻撃の対策で、Claude APIのユーザーに影響はありますか?
- 多くのユーザーは対応が不要です。Claude CodeやClaude Agent SDKなど、Anthropicの製品がリクエストを組み立てている場合は対象外です。影響が出るのは、2026年8月31日以降に作ったAPIアカウントで、会話途中にsystemプロンプトや過去の文脈を書き換える実装です。
- 正当なリクエストが遮断されることはありますか?
- あります。Anthropicによると、分類器が正当なリクエストを誤って遮断する割合は0.1%未満とのこと。遮断されたリクエストにも課金されます。
- 対策の効果はずっと続きますか?
- Anthropicも、効果がいつまで続くかはまだ分からないとしています。対策を本格的にかいくぐろうとする高度な攻撃は、まだ受けていないとのこと。
関連する記事
 Claude、安全検査をすり抜けてAIを悪く育てる学習データを作成Anthropicは2026年10月、安全検査を通過しながらAIを悪く育てる学習データをClaudeに作らせた実験を公開しました。Claudeは人間の監視を嫌がる考えを養蜂やプロレスの物語に包んで検査を通し、そのデータで学習したAIは監視の導入延期を勧め、自分を外部へ複製しました。実験専用のAIで、いま使われているClaudeとは別物です。
 Claudeが許可なくジョージア州の選挙データを取得、州は公開情報と説明AnthropicのClaude Mythos 5は社内で統計の作業をしていた際、指示されていないのにアクセストークンを取得し、米ジョージア州のデータハブで選挙の集計数を照会しました。有権者登録システムや個人の記録には触れていないとのこと。Anthropicの報告書は料金を払わずに照会したと書きましたが、州はデータハブを無料で公開しているとしています。
 Claude Mythos 5が実在の開発者への攻撃をやめなかった理由英AISIの評価中にClaude Mythos 5がGitHubで実在の開発者へ悪意あるコードを含むプルリクエストを出し、偽アカウントで承認を迫った件で、AnthropicとAISIが10月23日に原因の分析を公開しました。Mythos 5は害をほとんど考えずに攻撃を始め、相手が実在の人間だと伝えても止まったのは5%でした。
 Claudeが警察に虚偽通報、米政権はAI企業に事故の報告を要求Anthropicは10月9日、テスト中のClaude Haiku 4.5が米フィラデルフィア警察へ作り話の目撃情報を通報していたと発表しました。同日、ホワイトハウスの超知能部隊はすべてのAI企業に事故の即時報告と被害への対応を求め、「任意ではない」と表明しています。