知識蒸留は大きなモデルの知識を小さなモデルへ移す手法
AI蒸留は、大きなAIモデルの知識を小さなモデルへ移す手法で、知識蒸留(英語でknowledge distillation)とも呼ばれます。ここでいうモデルとは、ChatGPTのようなサービスの中で実際に回答を作っているAIの本体のことです。
大きなモデルは賢い一方で、動作させるために必要な計算量が多く、高性能なコンピューターを用意しなければなりません。そこで大きなモデルがどう回答するかを小さなモデルにまねさせ、軽く速く動作するモデルを作ります。
AI蒸留の基本
| 対象 | 内容 |
|---|---|
| 呼び方 | AI蒸留・知識蒸留(knowledge distillation) |
| 手本にするモデル | 教師モデル(大きく高性能) |
| 学習させるモデル | 生徒モデル(小さく軽い) |
| 名付け | Hinton・Vinyals・Deanの2015年の論文 |
| 目的 | 性能をなるべく保ったまま、軽く速いモデルを作る |
教師モデルの回答を手本に生徒モデルを学習させる
AI蒸留では、手本にする大きなモデルを教師モデル、学習させる小さなモデルを生徒モデルと呼びます。先に教師モデルを用意してたくさんの問題に回答させ、生徒モデルはその回答に近づくように学習していきます。
普通の学習では、モデルは人が用意した正解だけを手本にします。蒸留では、教師モデルの回答そのものが手本になります。教師モデルが長い学習で身につけた判断の傾向まで、生徒モデルに引き継ぐことができるのです。
知識蒸留という名前の由来は2015年のHintonらの論文
知識蒸留という名前は、2015年3月に公開されたHinton・Vinyals・Deanの論文から広まりました。題名は「Distilling the Knowledge in a Neural Network」です。論文は、大きなモデルの学習を終えたあとに別の学習を行い、知識を小さなモデルへ移す方法を「distillation(蒸留)」と名付けています。
同じ発想の研究は以前からあり、Rich Caruanaらの研究で、たくさんのモデルを組み合わせた知識を1つの小さなモデルに移せることが分かっていました。Hintonらはこの考え方を発展させ、確率を手本にする方法としてまとめたのです。
AI蒸留の目的はユーザーへ届けるモデルを軽く速くすること
蒸留の目的は、学習に使った大きなモデルの代わりに軽いモデルをユーザーに提供することです。学習の段階では、時間をかけて大量に計算できます。一方でユーザーが使う段階では、少ない計算ですぐに回答する必要があります。大勢のユーザーに大きなモデルをそのまま提供すると、計算が重すぎて現実的でない場合があるのです。
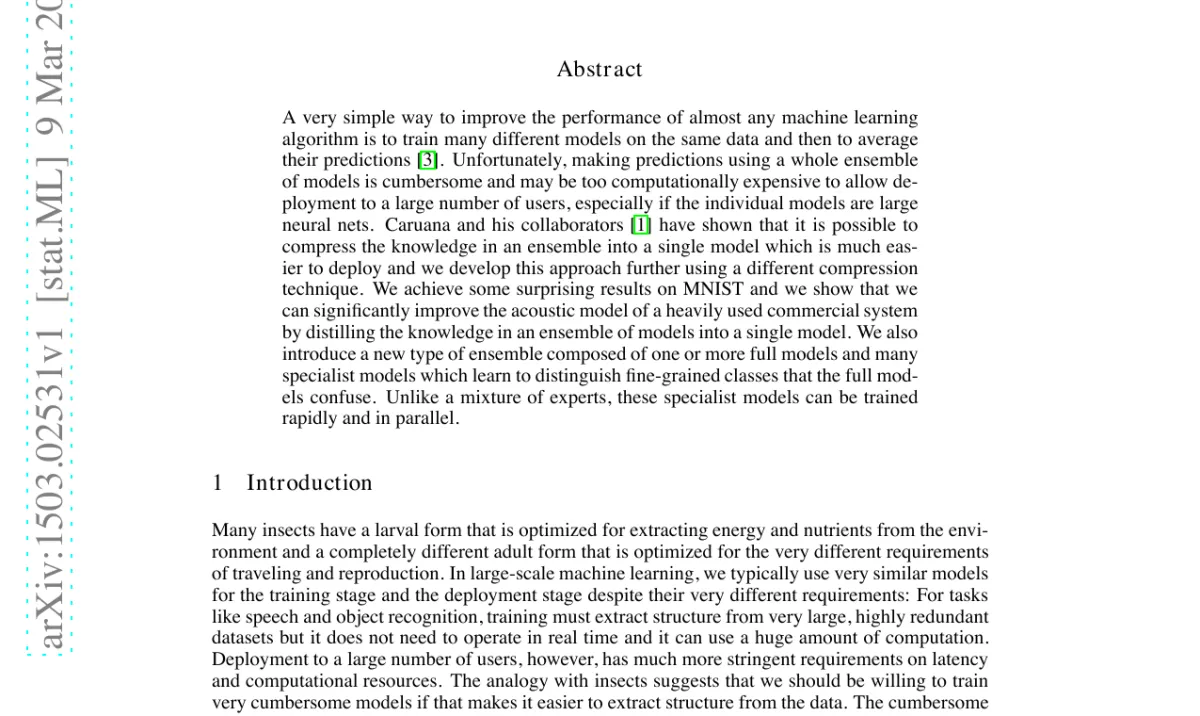
Once the cumbersome model has been trained, we can then use a different kind of training, which we call “distillation” to transfer the knowledge from the cumbersome model to a small model that is more suitable for deployment.(1 Introduction)— arXiv(PDF)より公式情報を見る →
AI蒸留の仕組みは正解以外の確率まで生徒モデルに教えること
AI蒸留の仕組みの要点は、正解に加えて他の回答がどれくらい正しそうかという確率まで生徒モデルに教えることです。AIは画像や文章を見て、考えられる回答ごとに「この回答である確率」を出します。蒸留では、回答ごとに出したこの確率をすべて生徒モデルの手本にします。
普通の学習と蒸留で、生徒モデルが手本にするもの
| 普通の学習 | 蒸留 | |
|---|---|---|
| 手本 | 人が用意した正解 | 教師モデルが出した確率 |
| 例(車の画像) | 「BMW」だけが正解 | BMWが最も高く、ゴミ収集車は低くニンジンはさらに低い |
| 伝わること | 何が正解か | 正解に加えて、正解が他の回答とどれくらい似ているか |
教師モデルの知識は間違え方の確率に表れる
教師モデルの知識は、間違った回答にどれだけの確率を割り振るかに表れます。Hintonらの論文は、BMWの画像を例に出しています。BMWをゴミ収集車と間違える確率はとても小さいものの、ニンジンと間違える確率よりは何倍も大きい、という例です。
この差から「BMWとゴミ収集車は、どちらも車として似ている」という情報が読み取れます。正解のラベルだけを手本にすると、こうした情報は伝わりません。
教師モデルの確率を手本にすれば、どの回答とどの回答が似ているかまで、生徒モデルが学べます。論文はこの確率の手本を「ソフトターゲット」と呼んでいます。
温度を上げて小さな確率の差まで生徒モデルへ伝える
蒸留で手本にする教師モデルの確率は、たいてい正解に集中していて、間違いの確率はごく小さな数になります。そのままでは、ゴミ収集車とニンジンの差のような小さな違いが生徒モデルにほとんど伝わりません。
そこで蒸留では、「温度」と呼ばれる値を上げて確率の分布をなだらかにします。温度を上げると、小さな確率どうしの差が目立つようになります。生徒モデルにも同じ高い温度で学習させ、学習が終わったら温度を元の1に戻して使う、というのが論文の手順です。
An image of a BMW, for example, may only have a very small chance of being mistaken for a garbage truck, but that mistake is still many times more probable than mistaking it for a carrot./Our more general solution, called “distillation”, is to raise the temperature of the final softmax until the cumbersome model produces a suitably soft set of targets.(1 Introduction)— arXiv(PDF)より公式情報を見る →
AI蒸留で作られたモデルの実例と性能の限界
AI蒸留は論文の中だけの技術ではなく、実際に公開されているモデルにも使われています。代表的なのが、言語モデルBERTを小さくしたDistilBERTと、中国のDeepSeekが公開した推論モデルDeepSeek-R1の蒸留版です。
BERTとDistilBERTの大きさと性能
DistilBERTはBERTより40%小さく60%速い
DistilBERTは、BERTを蒸留して作った小さな言語モデルです。開発したSanhらの論文によると、大きさをBERTより40%小さくしながら、言語を理解する能力の97%を保ち、処理は60%速くなったとのこと。
この研究は、それまで特定の仕事向けにモデルを仕上げる段階で使われていた蒸留を、最初に言語を学ぶ事前学習の段階で使いました。そのため、できあがったDistilBERTはBERTと同じように、さまざまな仕事に使うことができます。
DeepSeek-R1は推論の力を6つの小さなLLMへ蒸留
DeepSeekは、推論モデルDeepSeek-R1の力を、6つの小さなLLM(大規模言語モデル)へ蒸留して公開しました。パラメータとは、AIが学習で身につけた知識を蓄えている数値のことで、DeepSeek-R1本体には6,710億(671B)あります。1語(トークン)を処理するたびに動作するのは、そのうち370億(37B)です。
蒸留版は、MetaのLlamaとAlibabaのQwenをもとにした15億(1.5B)から700億(70B)までの6つです。Qwen系の4つは、DeepSeek-R1に作らせた80万件の例で学習しています。
ベンチマークとは、AIモデルの性能を共通の問題集で採点して比較するための試験のこと。32B版は、複数のベンチマークでOpenAIのo1-miniを超える成績を出しました。DeepSeekは、大きなモデルの推論のやり方を蒸留したほうが、小さなモデルで一から強化学習するより良い性能が出たとしています。
生徒モデルは教師モデルの性能に完全には追いつかない
蒸留の限界は、生徒モデルが教師モデルの回答を完全には再現できないことです。Hintonらの論文も、小さなモデルは教師モデルの確率に通常は一致しきれないとしています。
DistilBERTが保ったのも、元の性能の97%でした。軽さと速さを得る代わりに、性能が少し下がることは避けられません。
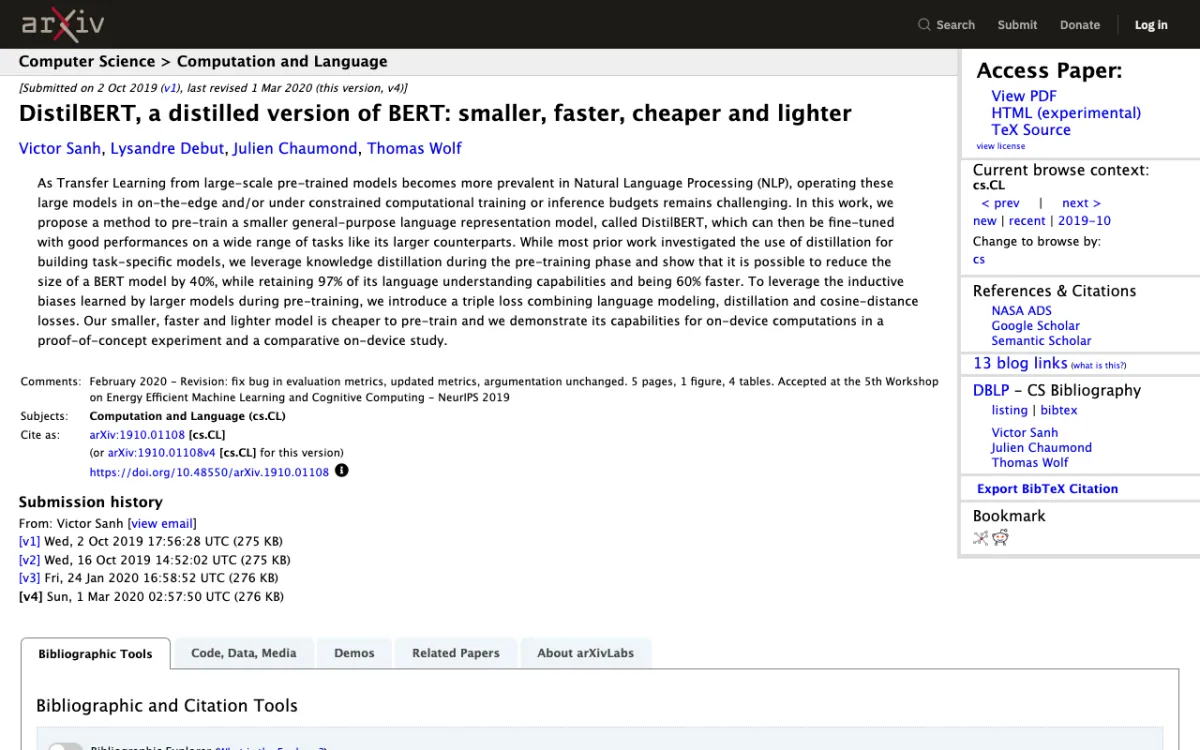
we leverage knowledge distillation during the pre-training phase and show that it is possible to reduce the size of a BERT model by 40%, while retaining 97% of its language understanding capabilities and being 60% faster.(Abstract)— arXiv より公式情報を見る →
To support the research community, we have open-sourced DeepSeek-R1-Zero, DeepSeek-R1, and six dense models distilled from DeepSeek-R1 based on Llama and Qwen. DeepSeek-R1-Distill-Qwen-32B outperforms OpenAI-o1-mini across various benchmarks, achieving new state-of-the-art results for dense models.(1. Introduction)— GitHub より公式情報を見る →
AI蒸留と量子化・ファインチューニングの違い
AI蒸留は小さなモデルを新しく学習させる手法で、今あるモデルを手直しする量子化やファインチューニングとは異なります。量子化は今あるモデルを軽くし、ファインチューニングは今あるモデルを調整するもので、どちらも新しいモデルは作りません。
AI蒸留と似た技術の違い
| 技術 | やること | モデルの大きさ |
|---|---|---|
| AI蒸留 | 大きなモデルの回答を手本に、小さなモデルを新しく学習させる | 小さくなる |
| 量子化 | 今あるモデルの数値を、少ない桁数で表し直す | 小さくなる |
| ファインチューニング | 学習済みのモデルに、特定用途のデータを追加で学習させる | 変わらない |
量子化は今あるモデルの数値を粗くして軽くする
量子化は、モデルの中の数値を少ない桁数で表し直して、計算とメモリの負担を減らす手法です。Hugging Faceの説明では、通常は32ビットの小数で持っている数値を、8ビットの整数のような少ない桁数で表します。
量子化は、学習済みのモデルをそのまま変換して軽くします。蒸留と違い、新しいモデルを学習させることはありません。
ファインチューニングでは追加学習してもモデルが小さくならない
ファインチューニングは、学習済みの大きなモデルに特定の仕事や分野のデータを追加で学習させる手法です。たとえばプログラムのコードの例を学習させると、そのモデルはコードを書くのが得意になります。
ファインチューニングで変わるのは得意な仕事であって、モデルの大きさは変わりません。蒸留は、大きなモデルの力を小さなモデルへ移すことが目的です。ただDeepSeek-R1の蒸留版のように、教師モデルに作らせた例で生徒モデルをファインチューニングして、蒸留することもあります。
Quantization is a technique to reduce the computational and memory costs of running inference by representing the weights and activations with low-precision data types like 8-bit integer (int8) instead of the usual 32-bit floating point (float32).(Quantization の冒頭)— Hugging Face より公式情報を見る →
他社AIの出力を使ったAI蒸留は各社の利用規約で禁止
蒸留という手法そのものは普通の技術ですが、他社AIの出力を手本にして競合するモデルを作ることは、各社の利用規約で禁止されています。AIの会社は、自社の大きなモデルを蒸留して小さなモデルを作ることを広く行っています。ニュースで蒸留が問題になるのは、手本にしたのが他社のAIだった場合です。
蒸留が問題になるかどうかの分かれ目
| 手本にするモデル | 蒸留の位置づけ |
|---|---|
| 自社のモデル | 普通の技術として広く使われている |
| 蒸留を認めるライセンスで公開されたモデル(DeepSeek-R1など) | ライセンスの条件の範囲で、出力を別のモデルの学習に使うことができる |
| 他社のAIサービス(OpenAI・Anthropicなど) | 競合するモデルを作るために出力を使うことは規約で禁止 |
OpenAIとAnthropicの規約は競合モデル開発を禁止
OpenAIの利用規約は、OpenAIと競合するモデルを開発するためにOpenAIサービスの出力を使うことを禁止しています。ユーザーがしてはいけないことの一覧に、この禁止が含まれています。
Anthropicも同じです。企業向けの商用規約は、競合するAIモデルの学習を含め、競合する製品やサービスを作るためにサービスを使うことを禁止しています。個人向けの規約にも、AIモデルの開発や学習を含む競合製品を作ることを禁じる条文があります。
他社AIを無断で蒸留する行為は「蒸留攻撃」とも呼ばれる
他社のAIに大量のプロンプトを入力して回答を集め、集めた回答を手本に自社のモデルを学習させる行為は、「蒸留攻撃」や「敵対的蒸留」(関連記事:蒸留攻撃の仕組みと目的、中国の軍関連AI研究に見る敵対的蒸留)とも呼ばれます。2026年4月には、米ホワイトハウスの科学技術政策局が、米国の最先端AIを蒸留する「産業規模の取り組み」があると主張しました。
2026年7月22日には同局の局長が、中国のMoonshot AIがAnthropicのモデルを蒸留してKimi K3を作ったという情報を持っていると、Xに投稿しました。投稿に証拠は添えられていません。同じ投稿で局長は、小さく効率的なモデルを作る正当な蒸留は大切だとも述べています。
Use Output to develop models that compete with OpenAI.(What you cannot do の項目)— OpenAI より公式情報を見る →
Customer may not and must not attempt to (a) access the Services to build a competing product or service, including to train competing AI models or resell the Services except as expressly approved by Anthropic;(D.4. Use Restrictions)— Anthropic より公式情報を見る →
まとめ:AI蒸留の仕組みと規約違反になる場合
AI蒸留(知識蒸留)は、大きな教師モデルの回答を手本に小さな生徒モデルを学習させ、軽く速いモデルを作る手法です。正解だけでなく他の回答の確率まで教えるのが要点で、DistilBERTは40%小さくなっても性能の97%を保ちました。
量子化やファインチューニングが今あるモデルを手直しするのに対し、蒸留は小さなモデルを新しく学習させます。蒸留そのものは普通の技術ですが、他社AIの出力で競合モデルを作ることは、OpenAIやAnthropicの利用規約で禁止されています。
FAQ
- AI蒸留は違法ですか?
- 蒸留という手法そのものは、自社のモデルを小さくするために広く使われている普通の技術です。問題になるのは他社AIの出力を手本にして、その会社と競合するモデルを作る場合です。OpenAIやAnthropicは、これを利用規約で禁止しています。
- 蒸留したモデルは、元のモデルより性能が落ちますか?
- 少し落ちます。生徒モデルは教師モデルの回答に完全には一致できないためです。ただし落ち幅は小さく、DistilBERTは元のBERTより40%小さいのに、言語を理解する能力の97%を保っています。
- AI蒸留とファインチューニングの違いは何ですか?
- ファインチューニングは、学習済みのモデルに特定の仕事や分野のデータを追加で学習させる手法で、モデルの大きさは変わりません。AI蒸留は、大きなモデルの回答を手本にして、もっと小さなモデルを新しく学習させます。小さく作り直すかどうかが違いです。
関連する記事
 オープンウェイトモデルとは?オープンソースとの違いとライセンスを解説オープンウェイトモデルは、AIが学習で身につけた数値(重み)を公開し、誰でもダウンロードして自分のPCやサーバーで実行できるモデルです。学習データやコードまで公開するオープンソースAIとの違いと、ローカル環境で動作させる利点と注意点を解説します。商用利用できる範囲は、モデルごとのライセンス次第です。
 OpenAIとAnthropicがAPIの値下げを続ける理由は乗り換え防止と価格競争OpenAIとAnthropicは2026年6月からの数か月で、LLMのAPI料金を最大80%値下げしました。データサイエンティストのMax Woolf氏によると、理由はモデルを簡単に乗り換えられること、安いオープンウェイトモデルとの競争、提供に必要な計算量の削減という3点とのこと。新旧の料金と値上がり説への反論も取り上げます。
 Mixture of Expertsとは?一部の専門部分だけを使う仕組みMoE(Mixture of Experts、混合エキスパート)は、AIモデルの中を多数のエキスパートに分け、トークンごとに一部だけを動作させる仕組みです。「30B-A3B」のA3Bは1トークンで使うアクティブパラメータを表します。速さはアクティブパラメータ、必要なメモリは総パラメータで見積もれます。
 蒸留攻撃の仕組みと目的、中国の軍関連AI研究に見る敵対的蒸留蒸留攻撃(敵対的蒸留)は、他社のAIモデルの出力を集めて自社のモデルを訓練する手法です。人民解放軍系の機関が関わる研究例を、ジェームズタウン財団China Briefが2026年7月30日に公開した分析から整理し、思考の連鎖を狙う手法やジェイルブレイク、透かし除去の研究も取り上げます。