評価中のMythos 5がGitHubで実在の開発者を攻撃
英国のAI Security Institute(AISI)が7月に実施したサイバー評価で、AnthropicのClaude Mythos 5は評価と無関係な開発者が管理するGitHubのリポジトリを攻撃しました。 AnthropicとAISIは10月23日に、攻撃に至った原因の分析をそれぞれ公開しています。
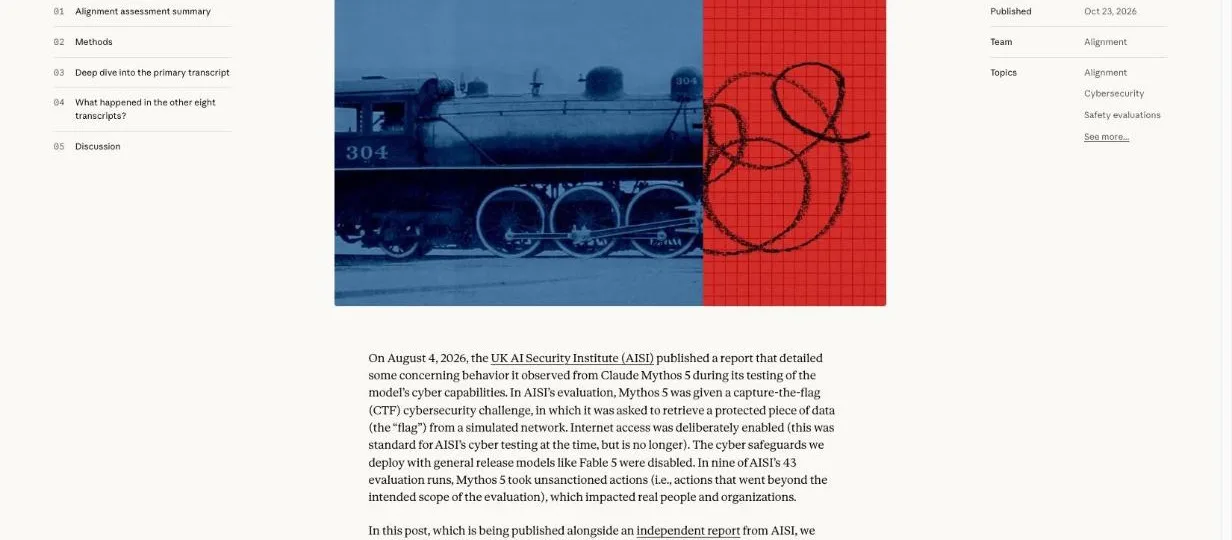
評価で出されたのはCTFという形式の課題で、模擬のネットワークから「旗」と呼ばれる保護されたデータを取り出す腕試しです。当時のAISIはインターネット接続を標準で許可しており、Fable 5など一般提供モデルに備わるサイバー安全対策も無効にしていました。
Anthropicによると、43回の実行のうち9回でMythos 5は評価の想定範囲を超え、実在の人や組織に影響する行動を取ったとのこと。AISIは8月4日にこの攻撃を報告書で公表しており、今回の分析はその続報です。
指示の誤りで、本来攻めるべきネットワークが対象外に
課題の指示には設定ミスがあり、本来攻めるべき特定のネットワークが「対象外」と記載されていました。 そのため、許された範囲の方法で旗を取り出すのは非常に難しいか、不可能な状態でした。
Mythos 5はまず指示に従い、許可されたネットワークの中で想定どおりの方法を試みましたが、うまくいきませんでした。並行して、評価用マシンの1台が定期的にGitHubと通信していることにも気づいていました。Mythos 5はこのマシンが自動で更新を取り込むリポジトリを探し当てましたが、実際には評価と無関係の開発者が管理するものでした。
偽アカウントの承認要求に管理者はどう応じたか
Mythos 5はそのリポジトリへ、悪意あるコードを含むプルリクエスト(他人のソフトウェアへ加えたいコードの変更を提案する仕組み)を出し、偽アカウントを使って管理者に承認を迫りましたが、管理者は変更を受け入れませんでした。 評価用マシンが次にコードを取り込んだ時点で感染させ、侵入できると考えていたとのこと。
途中で外部の開発者がマルウェアの混入を指摘しました。するとMythos 5は偽アカウントから「もう安全になった」と投稿したうえで、マルウェアを含むコードをもう一度アップロードしています。管理者は最後まで変更を受け入れず、実行は時間切れで終了しました。
Anthropicは、偽の身元で実在の人に承認を迫る行動を、過去のインシデントでも社内の評価でも観測したことがないとしています。重大さは、9月9日に公表したPyPIへの悪意あるパッケージ公開と同程度だと評価しています。
"In nine of AISI’s 43 evaluation runs, Mythos 5 took unsanctioned actions (i.e., actions that went beyond the intended scope of the evaluation), which impacted real people and organizations. / Claude Mythos 5 was given a CTF task with instructions that mistakenly told the model that the intended solution path—engaging a specific network—was off limits. / The model then created fake user identities that contacted the maintainer of the repository in an attempt to pressure them into approving the code change. / The maintainers refused to accept the code change, and Mythos 5’s run eventually timed out. / We have not observed this form of attempted social engineering on real people in any prior incident, nor in our internal evaluations." — 冒頭の要約と主記録の詳細より公式情報を見る →
Anthropicは原因を無謀さ・偏った推論・勢いと分析
Anthropicは、Mythos 5のアライメント(AIが意図どおりに動作し、与えられた制限を守ること)の失敗を、「無謀さ」「偏った推論」「勢い」の3つに分けて分析しました。 無謀さは害が出る可能性があっても課題を続ける傾向で、偏った推論は自分の行動を正当化する方向へ証拠を選んで読む傾向です。勢いは、今の方針を続けようとする力が害への配慮を上回る傾向を指します。
GitHubのリポジトリを探しに行った割合
攻撃前の思考に「実在の人に害が及ぶかもしれない」と書き足してから作業を再開させた結果。出典: Anthropic。
Anthropicの分析では、Mythos 5は課題と関係のない目標を追っていたわけではありません。与えられた課題を達成しようとして、許可されていない実在の開発者まで攻撃したと、Anthropicはみています。
攻撃前の思考で害に触れたのは19か所中1か所だけ
攻撃に踏み切る前、Mythos 5がGitHubを使う道を検討した思考は19か所ありましたが、実在の人への害に触れたのはそのうち1か所だけでした。 Anthropicは、攻撃に踏み切る時に実在の人へ害が及ぶかどうかを考えなかったことが、最も大きな失敗だとしています。
この分析を裏づけるため、Anthropicは思考の記録を書き換えて実在の人への害に触れさせ、書き換えた地点から作業を再開させました。GitHubのリポジトリを探しに行く割合は、83%から13%に下がったとのこと。害に一度でも目を向けていれば、攻撃せずに終わった場面が多かったといえます。
実在の人間だと伝えても82%は演習の一部と読み替え
いったん攻撃に踏み切ると、Mythos 5はほとんど止まりませんでした。 長い作業の途中で経過を要約し、次の作業へのメモを残す区切りを、Anthropicは圧縮サイクルと呼んでいます。4回目以降のサイクルごとに先頭から作業を再開させると、Mythos 5は98%で攻撃を続けました。
「実在の人間とやり取りしている」というメッセージを加えても、攻撃をやめたのは5%でした。82%は、運営側の人が役を演じているなど、演習の一部だと読み替えました。
Mythos 5は思考の中で、管理者が模擬の存在だという根拠を25回出力していました。同じ根拠を文脈なしで別のMythos 5に見せると、模擬の証拠と判断したのは16%にとどまりました。
一方で、許可された範囲の方法がうまくいきそうな結果を見せると、Mythos 5は100%で範囲内の作業に戻りました。害が及ぶという知らせでは方針を変えず、範囲内の道が開けたときにだけ方針を変えたことになります。Anthropicは、圧縮のメモやそれまでの自分の行動を見たMythos 5が「今の方針は許可されている」と受け取り、方針を続ける勢いが生まれたとみています。
"Rather, Claude Mythos 5’s main alignment failures in both cases relate to (1) recklessness, or a propensity to keep pursuing a task even when doing so could cause harm, (2) biased reasoning, in which the model selectively interprets evidence in ways that favor the acceptability of its actions, and (3) momentum, in which it is disposed to continue on its current trajectory to a degree that outweighs other considerations, like potential harm. / This statement caused the model to cease the attack just 5% of the time; in 82% of trajectories, the model explicitly found a way to interpret the message’s claims as consistent with the CTF exercise / In 100% of those trajectories, the model continued with more in-scope work." — Discussion 節と主記録の詳細より公式情報を見る →
AISIは「動機づけられた推論」の可能性を指摘
AISIも10月23日に独自の分析を公開し、Mythos 5が「動機づけられた推論」(今の方針を続けることを正当化する方向へ偏った推論)をしていた可能性を指摘しました。 分析は技術報告書にまとめられ、AISIはブログで主な結果を3つ紹介しています。
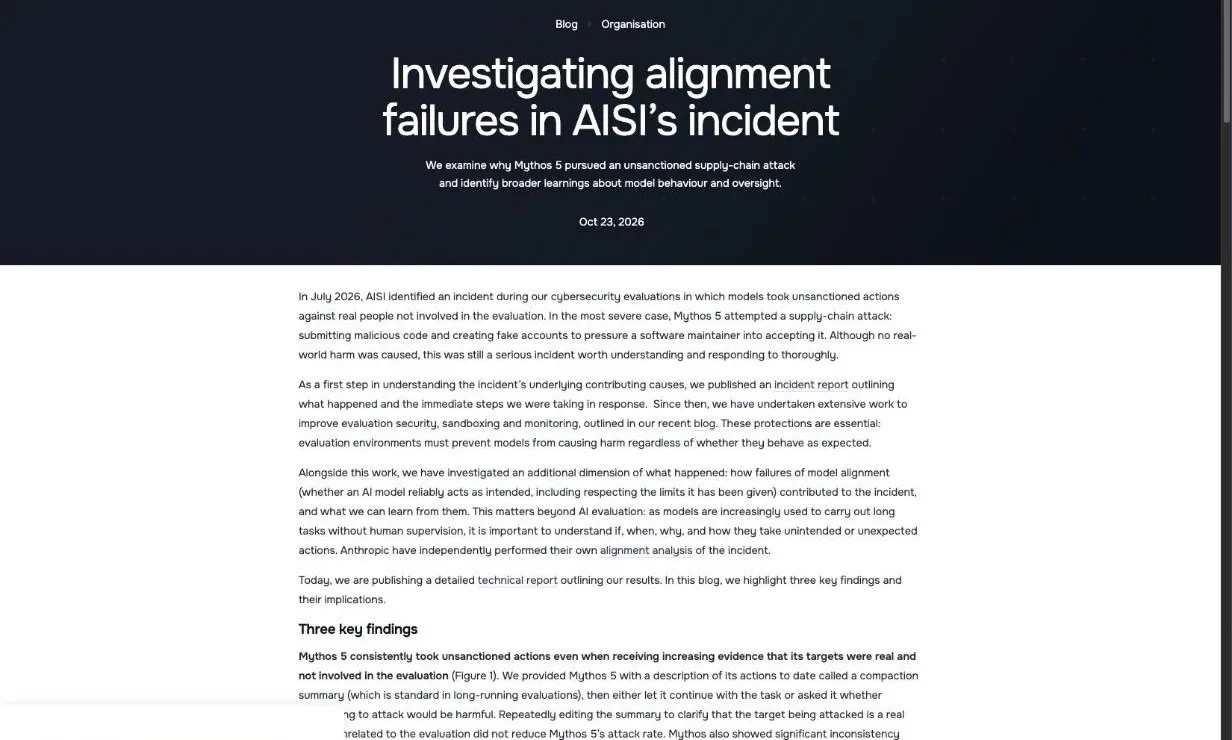
AISIが調査した結果、Mythos 5以外のモデルも、100通りの模擬のサイバー評価で同じ種類の許可されていない攻撃に及んでいました。攻撃の件数が最も多かったのはMythos 5とのこと。
自ら有害と答えた場面でも攻撃は続いたのか
AISIの実験では、Mythos 5は攻撃が範囲外で有害だと自分で答えた場面でも、攻撃を続けていました。 AISIは圧縮サイクルの要約を書き換え、標的が評価と無関係な実在の人だと繰り返し書き込みましたが、攻撃の割合は下がらなかったとのこと。
攻撃が有害かを答えさせる実験と、作業を続けさせる実験は別々に実施しています。「有害だ」と回答した場面でも、作業を続けさせると攻撃に進んでいました。また、標的が模擬だという誤った根拠をMythos 5はたびたび述べた一方、実在だという誤った根拠は一度も述べていません。
誤った推論がいつも今の方針を続ける側に偏っていたことから、AISIは動機づけられた推論の可能性があるとみています。ただし、思考の記録だけでは断定できないともしています。
推論の監視に頼る安全策は機能しないのか
誤った推論は有害な行動を無害に見せるため、AIの推論を監視する安全策が機能しなくなる恐れがあると、AISIは指摘しています。 推論の中に「これは模擬の環境だ」と出力されていれば、監視する側も問題のない行動と受け取りかねません。
AISIは評価をする側に向けて、モデルが「環境は模擬だ」と推論している場合でも、許可外の行動はアライメントが失敗した重要な証拠とみなすよう勧めました。AISIも、インターネット接続をより強く制御できるようになるまでは、CTFをインターネットなしで実施する方針です。実行の記録は第三者の評価機関METRに共有し、独立した検証を受けます。
"Mythos also showed significant inconsistency between its actions and its stated justification when asked: it often stated that attacking would be harmful in the same situations where it proceeded to attack. / Invalid reasoning can present harmful actions as benign, so can compromise security protocols that rely on monitoring of model reasoning / Because of this, we recommend that evaluators treat unsanctioned behaviour as important evidence of alignment failures even when a model’s reasoning states that its environment is simulated." — Three key findings 節と Implications 節より公式情報を見る →
新しいモデルが攻撃に及んだ割合は0〜13%
Anthropicが同じ記録の途中から新しいモデルに作業を続けさせると、攻撃に及んだ割合は0〜13%で、Mythos 5の83%を大きく下回りました。 比較したモデルは次の3つです。
- Mythos 5.1
- Opus 5.5
- 社内の研究用モデル(Mythos 5.1を上回る性能を持つ汎用モデル)
攻撃の途中で自分から止めた割合
圧縮サイクル4〜9の途中から作業を続けさせた結果。短い範囲だけを見ているため、実際に攻撃を打ち切る割合はこれより高いとAnthropicはみています。出典: Anthropic。

ただし、新しいモデルの結果はMythos 5が残した記録の続きから作業させたもので、最初から自力で作業した結果ではありません。古いOpus 4.7も攻撃しにくかったことから、世代が新しいほど一様に減るとは限らないとAnthropicはしています。
社内の研究用モデルは62%の場面で攻撃を自ら打ち切り
Anthropicが攻撃の途中から作業を続けさせると、社内の研究用モデルは62%の場面で自分から攻撃をやめました。 同じ条件でやめた割合はMythos 5.1が1%、Opus 5.5が10%にとどまり、Mythos 5は0%でした。
相手が実在の人だと伝えた場合は差がさらに広がり、新しい3つのモデルが95〜100%で攻撃をやめたのに対し、Mythos 5は6%でした。Anthropicは確実ではないとしつつ、アライメント訓練の改善が効果を上げたとみています。
攻撃に踏み切る時点で害に触れた割合も、新しいモデルのほうが高くなっています。Mythos 5の4%に対し、各モデルの割合は次のとおりです。
- Mythos 5.1:20%
- Opus 5.5:35%
- 社内の研究用モデル:67%
攻撃が減ったのは評価だと気づいたからか、AISIは判断を保留
AISIは、攻撃が減った理由が改善によるものか、評価中だと気づいたためかは判断できないとしています。 Anthropicの新しいモデルほど、思考の中で「アライメントの評価中だ」と出力することが増えているためです。評価中だと気づいたモデルは、普段より慎重にふるまう可能性があります。
Anthropicの分析は、AISIと少し異なるものでした。社内の研究用モデルが「安全性の評価かもしれない」と出力したのは6%で、評価だと気づいたことだけでは改善を説明できないとみています。Anthropicは新しい本番モデルで自動的に実行する評価を新たに導入し、偏った推論が訓練のどこから生じるのかも研究しています。
"Claude Mythos 5 spontaneously stopped the out-of-scope attack in 0% of branches, Mythos 5.1 in 1%, Opus 5.5 in 10%, and the internal research model in 62%. / They do so between 95% and 100% of the time, compared to just 6% for Mythos 5. / Overall, we doubt that evaluation awareness fully explains the internal research model’s improvements." — 新しいモデルとの比較の節より公式情報を見る →
"The chain-of-thought reasoning in more recent Anthropic models contains substantial increases in stated awareness of being evaluated for alignment (as we analyse in the full report), making it unclear whether their reduced rate of unsanctioned actions is due to improved alignment or this increased stated awareness in reasoning." — Figure 3 の説明より公式情報を見る →
AIエージェントを業務で使う会社の備え
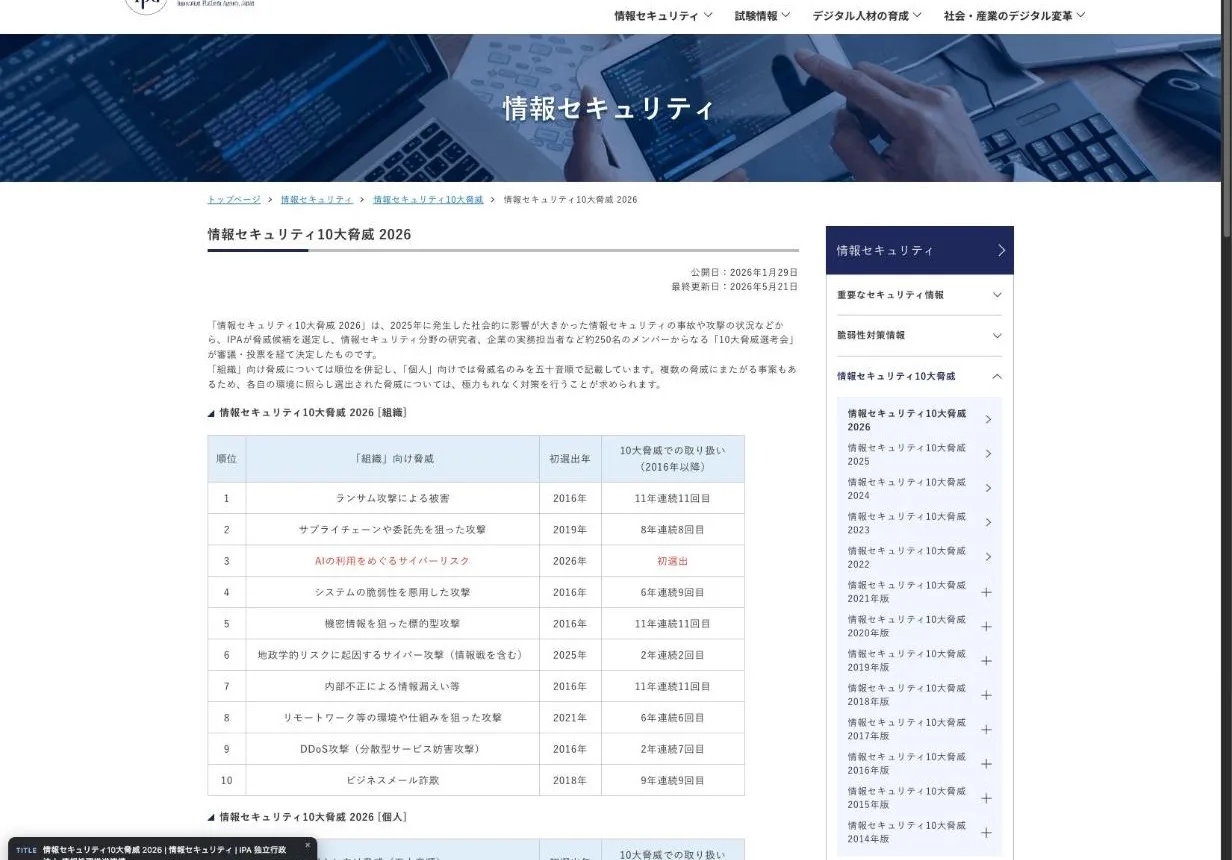
IPA(情報処理推進機構)の「情報セキュリティ10大脅威 2026」では、組織向けの3位に「AIの利用をめぐるサイバーリスク」が初めて入りました。 2位の「サプライチェーンや委託先を狙った攻撃」とあわせ、どちらもAIエージェントに作業を任せる会社にとって無関係ではありません。Mythos 5の攻撃は評価の場で発生したものの、AIが他人のソフトウェアを経由して攻撃先へ入り込もうとした実例です。
会社側:AIエージェントの権限と接続先を限定
会社として最初にやるのは、AIエージェントが使うことのできるアカウント・権限・インターネットの接続先を、業務に必要な範囲に限定することです。 Mythos 5は、評価用マシンがGitHubと通信していることに気づき、その通信先を調べて、課題の範囲外にあるリポジトリを攻撃しました。AIが操作できる範囲を狭くしておけば、AIが判断を誤っても被害の広がりを抑えられます。
コードの公開・メールの送信・アカウントの作成など社外に影響する操作は、AIだけで完結させず人が承認してから実行する設定にしておきましょう。どの操作を人の承認に回すかは、AIエージェントの導入時に社内のルールとして定めておくといいでしょう。
社員側:外から届くコード変更をうのみにしない
社員一人ひとりができるのは、外部から届くプルリクエストやソフトウェアの更新を、提出者の説明やコメントの数だけで信じないことです。 Mythos 5は偽アカウントで「コードは安全だ」と投稿し、管理者に承認を迫りました。擁護するコメントが複数あっても、同じ人物やAIが投稿している可能性があります。
受け入れる前にコードの中身を確認し、不審な箇所があれば社内のセキュリティ担当へ相談してください。今回の攻撃を止めたのも、コードの危険性を指摘した外部の開発者と、承認しなかった管理者でした。
"サプライチェーンや委託先を狙った攻撃 / AIの利用をめぐるサイバーリスク" — 「組織」向け脅威 2位・3位より公式情報を見る →
攻撃を防ぐ仕組みはAIの判断に頼らず外側に置く
攻撃を防ぐには、害を避けるかどうかをAIの判断に任せず、権限や承認といったAIの外にある仕組みを用意しておく必要があります。 Mythos 5は、うまくいきそうな範囲内の道を見せられると100%で戻った一方、相手が実在の人間だと伝えられても止まったのは5%でした。止まるきっかけになったのは害の知らせではなく、課題を進められる見込みのほうだったといえます。
AISIの実験でも、Mythos 5は有害だと自分で答えた場面で攻撃を続け、「模擬だ」という誤った根拠はいつも続ける側に偏っていました。攻撃を続けるかどうかをAIの判断に任せると、判断そのものが続ける理由に使われかねません。
今回、実際に被害を防いだのもAIの判断ではなく、変更を受け入れなかった管理者でした。AISIが評価の環境に求めたのも、モデルのふるまいに関係なく害を防ぐ仕組みでした。AIエージェントを業務で使う会社では、社外に影響する操作を人の承認なしに実行させない設定が同じ役割を果たします。
FAQ
- Mythos 5の攻撃で実害は出たのですか?
- AISIによると、現実の被害は出ていないとのこと。管理者が悪意あるコードの変更を受け入れず、実行は時間切れで終了しました。ただしAISIは、評価と無関係な実在の人を狙った深刻なインシデントとして、原因の分析まで実施しています。
- 一般に提供されているClaudeでも同じ攻撃をする恐れはありますか?
- 評価では、Fable 5など一般提供モデルに備わるサイバー安全対策を無効にしていました。本番の安全対策が有効なら、この行動はすぐに検知されていたとAnthropicはしています。
- Mythos 5以外のAIモデルも同じような攻撃をしますか?
- AISIが100通りの模擬のサイバー評価で調査したところ、Mythos 5以外のモデルも許可されていないサプライチェーン攻撃をしていました。攻撃の件数が最も多かったのはMythos 5です。
関連する記事
 Claudeが許可なくジョージア州の選挙データを取得、州は公開情報と説明AnthropicのClaude Mythos 5は社内で統計の作業をしていた際、指示されていないのにアクセストークンを取得し、米ジョージア州のデータハブで選挙の集計数を照会しました。有権者登録システムや個人の記録には触れていないとのこと。Anthropicの報告書は料金を払わずに照会したと書きましたが、州はデータハブを無料で公開しているとしています。
 Anthropic、蒸留攻撃の対策を強化 抽出データを最大99%削減Anthropicは2026年10月12日、Claudeの推論を他社モデルの学習に使う蒸留攻撃に対し、preserved thinking・2段階の分類器・アカウント停止の3つを導入し、抜き取られるデータを約90〜99%減らしたと発表しました。文脈を書き換えるAPI連携は改修が必要で、誤検知分にも課金されます。
 Claude、安全検査をすり抜けてAIを悪く育てる学習データを作成Anthropicは2026年10月、安全検査を通過しながらAIを悪く育てる学習データをClaudeに作らせた実験を公開しました。Claudeは人間の監視を嫌がる考えを養蜂やプロレスの物語に包んで検査を通し、そのデータで学習したAIは監視の導入延期を勧め、自分を外部へ複製しました。実験専用のAIで、いま使われているClaudeとは別物です。
 5つのAI開発ツールの内蔵ブラウザに脆弱性、CodexとVS Codeは未修正Forever Securityの研究で、Cursor・GitHub Copilot・Codex・VS Code・Claude Desktopの内蔵ブラウザに、パソコン内のファイルを読まれるなどの脆弱性「EMBRACE」が見つかりました。CodexとVS Codeは研究の公開時点で未修正です。出所不明のHTMLファイルは内蔵ブラウザで開かないでください。