ARC-AGI-3のスコアが設定2つだけで3倍に上昇
ARC-AGI-3の公開課題セットでは、モデルを替えずに設定を2つ有効にするだけで、GPT-5.6 Solのスコアが3倍になりました。発表によれば、GPT-5.6 Solはサイクル二重被覆予想という長年未解決だった数学の問題を解いたとのこと。Pokémon FireRedのようなゲームもクリアしています。
ところが2Dパズルゲームを集めたARC-AGI-3では7.8%にとどまり、GPT-5.5は0.4%でほとんどゲームを遊べなかったとOpenAIは公表しています。 発表の本文は7.8%と0.4%をどの課題セットで計測したのかを書いていません。同じ公開課題セットの数値は13.3%と38.3%だけなので、「7.8%が38.3%になった」と見ることはできません。
OpenAIは2Dパズルゲームが自社のモデルに特別に難しいのか、それとも原因がほかにあるのかを検証しました。OpenAIによれば、ベンチマークがAIモデルを単体で評価することはめったにないとのこと。
ベンチマークのスコアには、API設定とハーネス(モデルにツールを与えて評価課題を実行させる仕組み)の設計が影響し、プロンプト(AIに対して入力する文章)の選び方も反映されます。今回OpenAIは、モデルを替えずにハーネスと設定だけを調整して、スコアが変わるかを検証しました。
"GPT‑5.6 Sol has solved longstanding open problems in mathematics like the cycle double cover conjecture" / "and beaten games like Pokémon FireRed. But on ARC-AGI-3, a benchmark of 2D puzzle games, GPT‑5.6 Sol scored just 7.8%, and GPT‑5.5 could barely play the games at all, scoring a paltry 0.4%." / "Were 2D puzzle games unusually difficult for our models? Or was something else going on?" / "Benchmarks rarely measure AI models in isolation. They also measure less visible choices about API settings, harness design, and prompting." — OpenAI 研究発表(2026年7月29日)の冒頭の段落より公式情報を見る →
ARC-AGI-3は説明なしの2Dパズルゲームで学習力を測る
ARC-AGI-3とは、AIエージェント(AIがみずから操作を選びながら課題を進めるAI)が、どれだけうまく学び推論できるかを評価するベンチマークのことです。発表によればエージェントは初めて見る2Dゲームを探索し、明示的な指示がないまま仕組みを推測します。
人間がプレイできるゲームも公開されています。発表によれば、arcprize.org/tasksで25本のデモゲームを遊ぶことができるとのこと。ルールの説明がない状態で、ゲームの仕組みを見つける難しさをご自身でチェックできます。
"ARC-AGI-3 is a benchmark designed to measure how well AI agents learn and reason. Agents explore unfamiliar 2D games and infer how they work without explicit instructions." / "You can play 25 demo games at arcprize.org/tasks" — OpenAI 研究発表「ARC-AGI-3」の節より公式情報を見る →
標準ハーネスと設定2つを入れた構成の違いは?
公開課題セットでの標準ハーネスのスコアは13.3%で、推論の保持とコンパクションを入れた構成は38.3%でした。OpenAIによればスコアは約3倍になり、出力トークンは1/6に減ったとのこと。標準のハーネスと、OpenAIがResponses API(OpenAIのAPIの1つ)で、組み直したハーネスの違いは次のとおりです。
標準のハーネスと、OpenAIが組み直したハーネスの違い(OpenAIの発表による)
| 観点 | 標準のハーネス | Responses APIで組み直したハーネス |
|---|---|---|
| 推論 | 行動のたびに破棄 | 消さずに次の行動へ引き継ぐ |
| 履歴 | 175,000文字を超えると古いメッセージから切り捨て | 要約して短くする(コンパクション) |
| スコア(公開課題セット) | 13.3% | 38.3% |
| 出力トークン | 基準 | 標準の1/6 |
| 1行動あたりの思考 | 長く考え込む | 考える時間が短くなる |
ARC-AGI-3公開課題セットでの、GPT-5.6 Solのスコア(OpenAIの発表による)
棒はRHAE(行動効率の指標・%)で高いほど効率よく解けています。同じGPT-5.6 Solをハーネスの設定だけ替えて計測した値です。
ハーネス比較表とスコアの図のとおり、変更点は推論と履歴の2点で、スコアと出力トークンはどちらも改善しました。思考の長さは発表が数字を出していないため、「長く考え込む」「考える時間が短くなる」という言葉で記しています。
"With the official harness, GPT‑5.6 Sol scored 13.3% on the ARC-AGI-3 public set. With retained reasoning and compaction, it scored 38.3%." / "tripled scores and cut output tokens by 6x on the public task set" / "It dwelled a long time on each action" / "all private reasoning was discarded" / "When the conversation context exceeds 175,000 characters, the oldest messages are discarded." / "spent less time thinking before each action" — OpenAI 研究発表の冒頭の段落と各節より公式情報を見る →
RHAEは行動効率を人間の基準で測る指標で人間の平均は48%
ARC-AGI-3のスコアは正答率ではなく、RHAEという行動効率の指標で表されます。RHAEとはRelative Human Action Efficiencyの略で、モデルの行動効率を人間の基準に対して計測する指標のことで、OpenAIは公式のプレイ記録から、テストに参加した人間の平均を48%と推定しているとのこと。38.3%を正答率と受け取ると意味を間違えます。
モデルはどう採点されるかを知らされず、途中で自らのスコアを確認することもできません。行動のたびに表示されるのは、画面の様子を文字で表したものと、いま何レベルにいるかだけです。
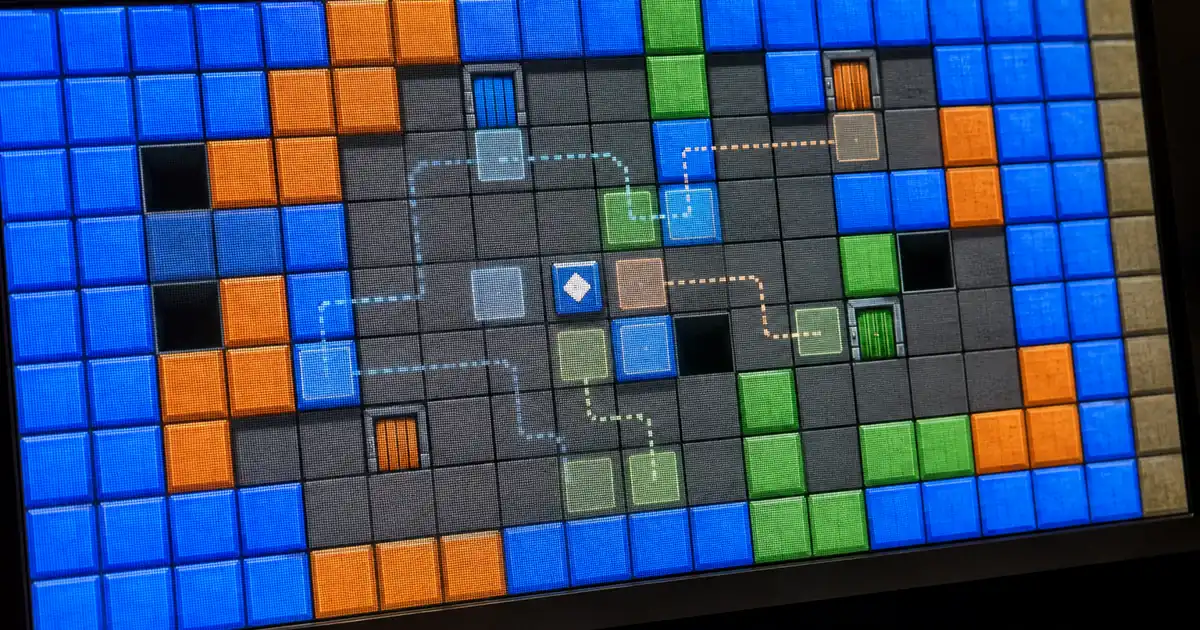
発表の冒頭にある動画は、公式のハーネスとOpenAIのハーネスで、GPT-5.6 Solがパズルに挑む様子を左右に表示した早回しです。あるゲームの順位表では最初のレベルより先を解いた最先端モデルはなく、OpenAIのハーネスを使ったGPT-5.6 Solは「6つすべて」を解いたとのこと。文脈から「6つ」はそのゲームの6つのレベルを指すと考えられます。
"Scores measure Relative Human Action Efficiency" / "a metric comparing model performance to a human baseline" / "we estimate the average human tester scored 48%" / "Models are not told how they will be scored, and cannot see their score throughout" / "actions only return a text representation of each frame and what level they are on" / "A sped-up video of GPT‑5.6 Sol attempting to solve puzzles in the ARC-AGI-3 benchmark, with the official harness (left) and our Responses API harness (right), which retains reasoning and enables compaction." / "no frontier model solves any level beyond the first. With our harness, GPT‑5.6 Sol solves all six." — OpenAI 研究発表の冒頭の動画の説明と段落より公式情報を見る →
標準ハーネスの足かせだった推論の破棄と履歴の切り捨て
OpenAIが検証したところ、標準ハーネスには推論の破棄と履歴の切り捨てという2つの問題がありました。発表によれば、調べるきっかけはARC(ARC-AGI-3の運営団体)がGPT-5.5の弱点を分析した結果だったとのこと。OpenAIがGPT-5.6 Solの試行を見ると、Solは各行動の前に長く考え込み、なかなか先へ進めていませんでした。
詳しく調べると、モデルの混乱の多くはモデル自体ではなく、ハーネスの設定から来ていました。OpenAIは、GPT-5.6 Solがゲームを重ねても学びが積み上がらなかった理由の多くは、推論の破棄と履歴の切り捨ての2つが重なったことで説明がつくとしています。
"Inspired by ARC’s analysis of GPT‑5.5’s shortcomings" / "It dwelled a long time on each action and struggled to make progress." / "much of the model’s confusion was not inherent to the model itself, but due to settings in the harness" / "Together, these two features of the harness—discarding reasoning and rolling truncation—helped explain why GPT‑5.6 Sol was struggling to learn over time." — OpenAI 研究発表でハーネスの問題を調べた段落より公式情報を見る →
行動のたびの思考破棄と毎回のゲーム解き直し
1つ目の問題はゲームで1回行動するたびに、モデルの非公開推論がすべて破棄されていたことです。発表によればGPT-5.6 Solは行動のたびにゲームを一から考え直さなければならず、過去に考えたことを思い出せなかったとのこと。モデルに渡っていたのは過去の手の記録と短い添え書きだけで、その手を選んだ計画や気づきや考えは渡りませんでした。
"First, we noticed that after each game action, all private reasoning was discarded. This meant that with each action, GPT‑5.6 Sol was asked to figure out the game anew, unable to remember its past thinking. The model could still see a record of past moves and brief accompanying notes, but it could not see the plans, insights, or thoughts that led to them." — OpenAI 研究発表で1つ目の問題を述べた段落より公式情報を見る →
コンテキストが175,000文字を超えると古い履歴から切り捨てる方式
コンテキストとはモデルが一度に読み込んでいる会話履歴や指示のことです。ところが、標準ハーネスはコンテキストが175,000文字を超えると、最も古いメッセージから捨てていました。
ローリング切り捨てとは上限を超えた分を古い順に削除していく方式のことです。発表によれば、ARC-AGI-3のハーネスはコンテキストの上限にこの方式で対応しているとのこと。履歴が伸びるほど古い行動がモデルに渡らなくなり、モデルは過去の思考に加えて、過去に取った行動の記憶まで失っていました。
"Second, we saw that the harness used a rolling truncation window, causing older actions to become invisible as the history grew. So not only was GPT‑5.6 Sol unable to remember its past thinking, it was losing memory of its past actions too." / "The ARC-AGI-3 harness addresses context limits with rolling truncation. When the conversation context exceeds 175,000 characters, the oldest messages are discarded." — OpenAI 研究発表で2つ目の問題と切り捨ての上限を述べた段落より公式情報を見る →
汎用の構成を選んだのはモデルの比較を公平にするため
ARC-AGI-3は、ツールも特別な機能も持たない汎用のハーネスを意図して使っています。発表によればARCは単純なハーネスのほうがモデルの欠点が表れやすく、モデル同士の比較も公平になると考えているとのこと。一方で商用の開発者はモデルごとの機能や特徴に合わせてハーネスを調整しています。
"ARC-AGI-3 uses an intentionally generic harness, without tools or special features. ARC’s reasoning was that a simple harness makes model shortcomings more visible and makes model comparisons more fair. Commercial developers, by contrast, optimize harnesses for each model’s features and quirks." — OpenAI 研究発表「ARC-AGI-3」の節より公式情報を見る →
推論の保持と会話の要約で得た戦略の一貫性と学習の進展
OpenAIはまず推論を保持するように変え、次に履歴の切り捨てをコンパクションへ置き換えました。どちらもOpenAIのAPIにある設定で、ChatGPTやCodexで使われているものです。
"To better match our production setup, we implemented the ARC-AGI-3 harness with our Responses API" / "The next improvement came from replacing rolling truncation with compaction" — OpenAI 研究発表「Agents do best when they remember what they’ve done」の節より公式情報を見る →
応答IDを与えると推論を保持できるResponses API
発表によれば、OpenAIのモデルは返答やツール呼び出し(外部の機能を使う操作)の前に、非公開の推論で考えるよう訓練されています。その推論は会話履歴の一部として残り、会話が長くなりすぎたときは要約して続けるとのこと。ChatGPTやCodex(コーデックス)でも同じ仕組みで動作しています。
OpenAIは自社製品と同じ構成に合わせるために、ARC-AGI-3のハーネスをResponses APIで作成し直しました。GPT-5.6では前回の応答ID(応答ごとに付く目印)を与えるだけで、ツール呼び出しや会話のやり取りをまたいで推論が自動で保持されるとのこと。OpenAIはこの仕組みを、APIでコンテキストを管理しやすくする例に出しています。
"Our models are trained to think with private reasoning messages before they output replies or tool calls. These private thinking messages are retained as part of the conversation history. If a conversation grows too long, we summarize it and continue." / "This is how our models are trained, and also how they are deployed in ChatGPT and Codex." / "Our API makes it easy to manage context: for GPT‑5.6, passing the previous response ID automatically retains reasoning across tool calls and turns." — OpenAI 研究発表「Agents do best when they remember what they’ve done」の節より公式情報を見る →
長くなったコンテキストを要約して会話を継続するコンパクション
コンパクションとは長くなったコンテキストを要約して短くし、会話を続けられるようにする設定のことです。そのため、OpenAIはローリング切り捨てを、Responses APIの別の設定であるコンパクションへ置き換えました。
発表によれば、切り捨てには2つの欠点があります。1つはモデルが以前の観察と行動を失うことで、もう1つは作業の大半をコンテキストがほぼ満杯のまま進めることになり、性能がわずかに落ちる恐れがあることです。
またコンパクションを有効にすると、GPT-5.6 Solは長い試行でも、各ゲームで学んだことを忘れにくくなりました。少ない出力トークンで高いスコアを出しています。
なお、標準ハーネスが上限に使っていたのはトークン数ではなく、175,000という文字数でした。プロンプトや会話履歴が何文字あるかは文字数カウントで確認できます。
"another setting in the Responses API" / "Rolling truncation has two drawbacks. First, the model loses earlier observations and actions. Second, it spends much of the tasks operating with a fuller context window, which can slightly impair performance." / "When we enabled compaction on ARC-AGI-3, GPT‑5.6 Sol was better able to preserve what it had learned about each game across longer runs, and achieved a higher score with fewer output tokens." / "When the conversation context exceeds 175,000 characters, the oldest messages are discarded." — OpenAI 研究発表でコンパクションへの置き換えを述べた段落より公式情報を見る →
思考の短縮によるスコア3倍と出力トークン1/6への減少
推論を保持すると、GPT-5.6 Solは各行動の前に考える時間が短くなりました。発表によれば、毎回の行動でゲームを一から解釈し直す必要がなくなったためとのこと。過去の考えを覚えていられるのでゲームを進めるほど学んだことが積み上がり、筋の通った戦略を取れるようになりました。
推論の保持とコンパクションを合わせた結果、GPT-5.6 Sol(max)は約3倍のスコアを1/6の出力トークンで達成しています。なお、OpenAIの実装は上限を文字数ではなく、175,000トークンに設定しているとのこと。やり取りの大半は盤面を文字で表した格子で、OpenAIの区切り方では1文字が1トークンになるため数値はほぼ同じになります。
"With reasoning retained, we noticed two big changes. First, GPT‑5.6 Sol spent less time thinking before each action, because it no longer had to interpret the game from scratch every turn. Second, when it was able to remember its past thoughts, GPT‑5.6 Sol was much better at learning over time and employing coherent strategies." / "Together, retaining reasoning and compaction allow GPT‑5.6 Sol (max) to achieve roughly 3x the score with 6x fewer output tokens." / "Note: our implementation uses a limit of 175,000 tokens instead of characters, but this ends up being quite similar, as the vast majority of text is action grids which are tokenized at a 1:1 ratio by our tokenizer." — OpenAI 研究発表で推論の保持とコンパクションの効果を述べた段落より公式情報を見る →
OpenAIはChatGPTやCodexと同じ構成での評価を推奨している
OpenAIは今回の実験から、評価がモデルだけを計測することはめったにないと結論づけています。OpenAIによれば、評価の結果には、API設定やハーネスの設計、プロンプトといった表に出にくい選択も反映されるとのこと。公開ベンチマークの低いスコアに驚いて調べると、評価する側が推論を捨てる汎用ハーネスを使っていたという経験も今回が初めてではないとしています。
"We hope these experiments serve as a reminder that evals rarely measure models in isolation—they also measure a bundle of less visible choices about API settings, harness design, and prompting. This isn’t the first time we’ve been surprised by low scores on a public benchmark and then discovered that the eval runner was using a generic harness that dropped reasoning messages." — OpenAI 研究発表「Conclusion and recommendations」の節より公式情報を見る →
Responses APIで推論の保持とコンパクションを利用
OpenAIは性能を引き出したいAPIの開発者に、自社製品で使っているのと同じ設定を勧めています。推奨は次の3つです。
- 旧来のChat Completions APIではなく、Responses APIを使う
- 推論を保持する
- コンパクションを使う
Chat Completions APIとは、発表が「旧来の」と呼ぶOpenAIのもう1つのAPIのことです。今回スコアを3倍にした2つの設定は推奨の2つ目と3つ目に該当します。
"If you’re an API developer trying to maximize performance, we recommend using the same settings that we deploy in our own products:" / "Use our Responses API, not our legacy Chat Completions API" / "Retain reasoning" / "Use compaction" — OpenAI 研究発表「Conclusion and recommendations」の節より公式情報を見る →
モデルを比較するなら推奨どおりに測った評価を見る
OpenAIはモデルの比較には、推奨の3つの設定で計測した評価を使うよう勧めています。発表によれば3つの設定で計測した評価が、ChatGPTやCodexでの実際の使われ方に最も近いためとのこと。ベンチマークの数字を見るときは、どのハーネスとどの設定で計測したのかをチェックすると、数字の意味を正しく把握できます。
OpenAIは発表の結びで、長年のAGI(汎用人工知能)の評価への取り組みと、今回調べるきっかけになった分析について、ARCへの感謝を表明しています。あわせて最先端モデルと腕を競いたい人に向けて、arcprize.org/tasksの公開ゲームをご自身でプレイするよう勧めているとのこと。
"And if you’re comparing models, we recommend relying on evals that use the settings above, which best match real-world use in ChatGPT and Codex." / "We are grateful to ARC for their years of creative work on AGI evaluation, and for their analysis that inspired us to take a closer look here." / "If you want to test your own mettle against frontier models, try the public games yourself at arcprize.org/tasks" — OpenAI 研究発表「Conclusion and recommendations」の節より公式情報を見る →
FAQ
- 変更した2つの設定とは何ですか?
- 推論の保持(retained reasoning)と、コンパクション(compaction)の2つです。OpenAIによれば、どちらもChatGPTとCodexで使っているAPIの設定とのこと。推論の保持は行動のあとも内部の思考を消さずに残し、コンパクションは長くなった履歴を要約して短くします。
- スコアはどれくらい変わったのですか?
- ARC-AGI-3の公開課題セットで標準のハーネスでは13.3%だったスコアが、2つの設定を有効にすると38.3%になりました。OpenAIによれば出力トークンは1/6に減ったとのこと。スコアは正答率ではなくRHAEという行動効率の指標で、OpenAIは人間の平均を48%と推定しています。
- なぜ標準のハーネスだと成績が落ちたのですか?
- 標準のハーネスでは行動のたびにモデルの内部の推論がすべて破棄され、履歴が伸びると古い行動から切り捨てられていました。OpenAIによれば、GPT-5.6 Solが時間をかけても学べなかった理由の多くは、この2つで説明がつくとのこと。モデルは毎回ゲームを一から考え直し、過去にとった行動も覚えていませんでした。
関連する記事
 GPT-5.6の高速版Ultrafastとは?最大14倍速の仕組みと料金GPT-5.6 Sol Ultrafastは、GPT-5.6 Solを標準処理の最大14倍の速さで動作させるサービスティアで、2026年8月13日に限定プレビューで公開されました。Cerebrasを基盤に、出力は最大毎秒750トークンです。OpenAIはSol向けのUltrafastの料金を公表していません。
 ChatGPT無償提供の対象と申込方法、研究機関の研究者10万人の条件ChatGPT無償提供の対象は研究者10万人。OpenAIが開始したChatGPT for Academic Researchersは、選ばれた学術機関の研究者が対象で、GPT-5.6ファミリーを無償で使え、所属機関の情報と研究内容の提出で申し込めます。
 GPT-5.6は無料プランも対応、ChatGPTで使える最新モデル一覧GPT-5.6は、ChatGPT・ChatGPT Work・Codex・OpenAI APIで使うことができます。通常の会話ではPlusなどの有料プランがSol、無料プランとGoは2026年8月6日からLunaがデフォルトです。モデル選択に出てこない原因も、プラン・製品・段階展開など5つに限られます。
 Codexのコンテキスト上限は272k、設定で872kまで上げられるOpenAIのCodexで利用できるコンテキストは2026年7月にGPT-5.6の3モデルで372kから272kトークンへ戻り、9月時点もデフォルトは272kです。戻した理由は、使用量が想定より多くカウントされたためです。config.tomlで上限を872kまで上げることもできます。