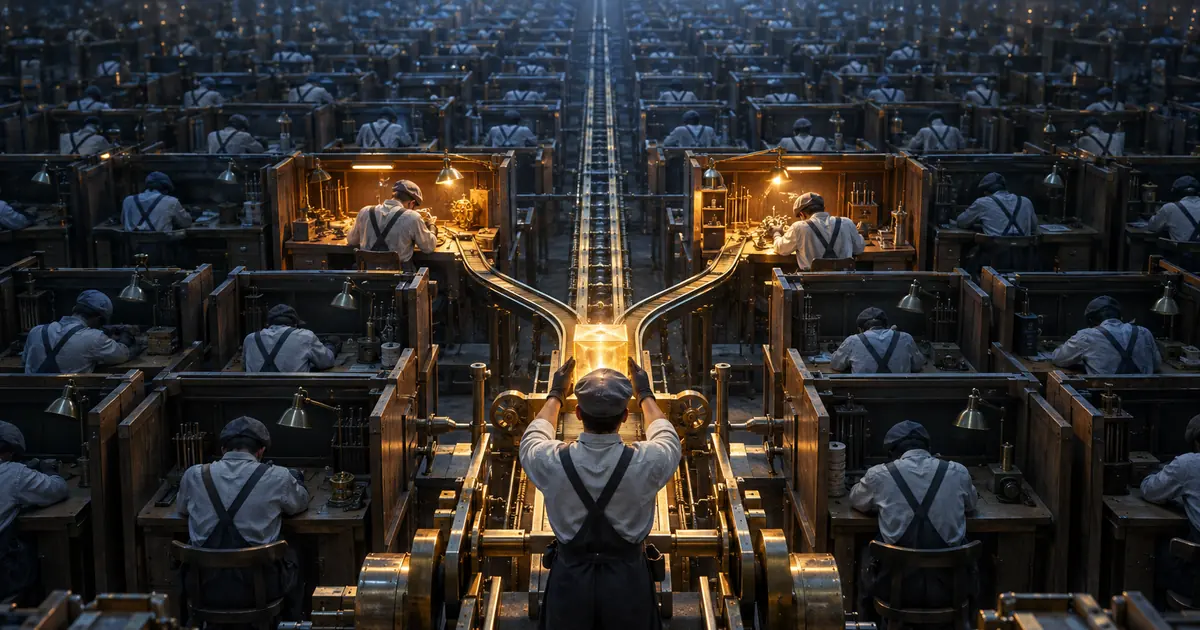
MoEは多数のエキスパートから一部だけを動作させる仕組み
MoE(Mixture of Experts、混合エキスパート)は、AIモデルの中を多数のエキスパートに分け、入力ごとにその一部だけを動作させる仕組みです。普通のモデルは、どんな入力に対してもモデル全体を使って計算します。一方、MoEでは入力ごとにエキスパートを選ぶので、計算に使うのはモデル全体の一部だけです。
MoEの基本
| 観点 | 内容 |
|---|---|
| 呼び方 | MoE・Mixture of Experts・混合エキスパート |
| 部品 | エキスパート(小さなネットワーク)とルーター(どのエキスパートを使うかを選ぶ部品) |
| 動作のさせ方 | 入力ごとに一部のエキスパートだけを使う |
| 源流 | 1991年の論文「Adaptive Mixture of Local Experts」 |
| 目的 | 計算量をあまり増やさずに、モデルを大きくする |
MoEはエキスパートとルーターでできている
MoEの部品はエキスパートとルーターの2つです。つまり、エキスパートはモデルの中に複数用意した小さなネットワークを指し、ルーターは、入ってきたデータをどのエキスパートに処理させるかを選ぶ部品で、ゲーティングネットワークとも呼ばれます。
LLM(大規模言語モデル)は、文章をトークンという単位に区切って処理します。トークンは単語や単語の一部くらいの長さです。MoEのLLMでは、このトークン1つごとにルーターがそのトークンを処理するエキスパートを選びます。
ルーターもモデルの他の部分と一緒に学習され、どのトークンをどのエキスパートへ割り当てるとよい結果が出るかを学習の中で覚えていきます。エキスパートの役割を人が割り振るわけではありません。
the router is composed of learned parameters and is pretrained at the same time as the rest of the network.(What is a Mixture of Experts (MoE)?)— Hugging Face より公式情報を見る →
MoEの源流は1991年の論文
MoEの考え方は、1991年の論文「Adaptive Mixture of Local Experts」までさかのぼります。この論文では学習データの異なる部分を別々のネットワークに担当させ、どれをどれだけ使うかをゲーティングネットワークが定めていました。
当時の研究は、モデル全体を小さなネットワークの集まりとして作るものでした。大きなモデルの中の1つの層としてMoEを使うようになったのは、2017年の論文からです。
The roots of MoEs come from the 1991 paper Adaptive Mixture of Local Experts. The idea, akin to ensemble methods, was to have a supervised procedure for a system composed of separate networks, each handling a different subset of the training cases.(A Brief History of MoEs)— Hugging Face より公式情報を見る →
MoEの目的は計算を増やさずにモデルを大きくすること
MoEを使う目的は、計算量をほとんど増やさずにモデルを大きくすることです。パラメータ数とは、AIモデルの中で学習を通じて値が調整される数値(パラメータ)の数のことで、パラメータ数が多いほど多くの知識を持てますが、普通のモデルではそのぶん計算も増えていきます。
2017年1月23日、Googleの研究者Shazeerらは、入力ごとにネットワークの一部だけを動作させる方法を論文で公開しました。そのため、計算効率をわずかに落とすだけで、モデルの容量を1000倍超に増やせたとのこと。論文では最大1,370億パラメータのMoEを言語モデルと機械翻訳に使いました。
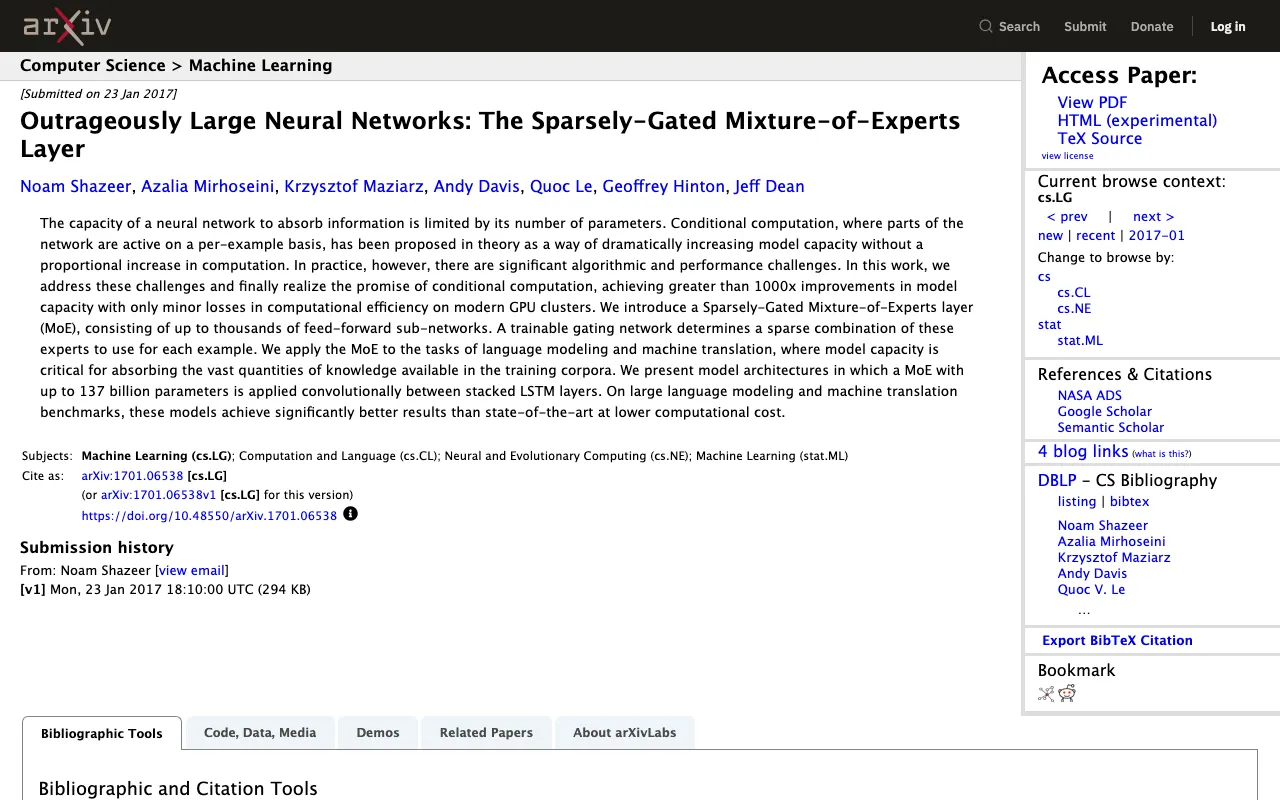
we address these challenges and finally realize the promise of conditional computation, achieving greater than 1000x improvements in model capacity with only minor losses in computational efficiency on modern GPU clusters./We present model architectures in which a MoE with up to 137 billion parameters is applied convolutionally between stacked LSTM layers.(Abstract)— arXiv より公式情報を見る →
LLMのMoEはトークンごとに使うエキスパートを選ぶ
LLMのMoEでは、トークンが層を通るたびにルーターがその層で使うエキスパートを選びます。つまり、選ばれなかったエキスパートはそのトークンの計算には使われません。
Transformerの1つの層の中身(DenseモデルとMoE)
| 部品 | Denseモデル | MoE |
|---|---|---|
| 注意(attention) | 全トークンで共通の1つ | 全トークンで共通の1つ |
| FFN層 | 1つを全トークンが使う | 多数のエキスパートに置き換わる |
| ルーター | 無い | トークンごとに使うエキスパートを選ぶ |
MoEがエキスパートに置き換えるのはFFN層だけ
LLMのMoEは、モデルのうちFFN層(フィードフォワード層)だけをエキスパートの集まりに置き換えます。MoEを使うLLMは、同じ種類の層を重ねたTransformerという構造のモデルです。Qwen3-30B-A3Bなら48層あり、1つの層は主に「注意(attention)」と「FFN層」の2つの部品からなります。
注意は文章の中のどの言葉とどの言葉が関係しているかを計算し、FFN層は注意で集めた情報をトークンごとに加工します。MoEではこのFFN層を複数のエキスパートに分け、その手前にルーターを置きます。注意の部分は分けず、すべてのトークンで共通です。
So, to recap, in MoEs we replace every FFN layer of the transformer model with an MoE layer, which is composed of a gate network and a certain number of experts.(What is a Mixture of Experts (MoE)?)— Hugging Face より公式情報を見る →
Mixtral 8x7Bは8つのエキスパートから2つを選ぶ
フランスのMistral AIが2024年1月に論文を公開したMixtral 8x7Bは、各層に8つのエキスパートを持ち、トークンごとにそのうち2つを使います。ルーターは層ごとに2つを選び、2つのエキスパートの出力を組み合わせて次の層へ引き継ぎます。
また、選ばれる2つはトークンによっても層によっても変わるため、同じ文章の中でもトークンごとに別のエキスパートが使われます。論文によると、Mixtral 8x7Bは評価したすべてのベンチマークでLlama 2 70BやGPT-3.5と同等以上の結果だったとのこと。
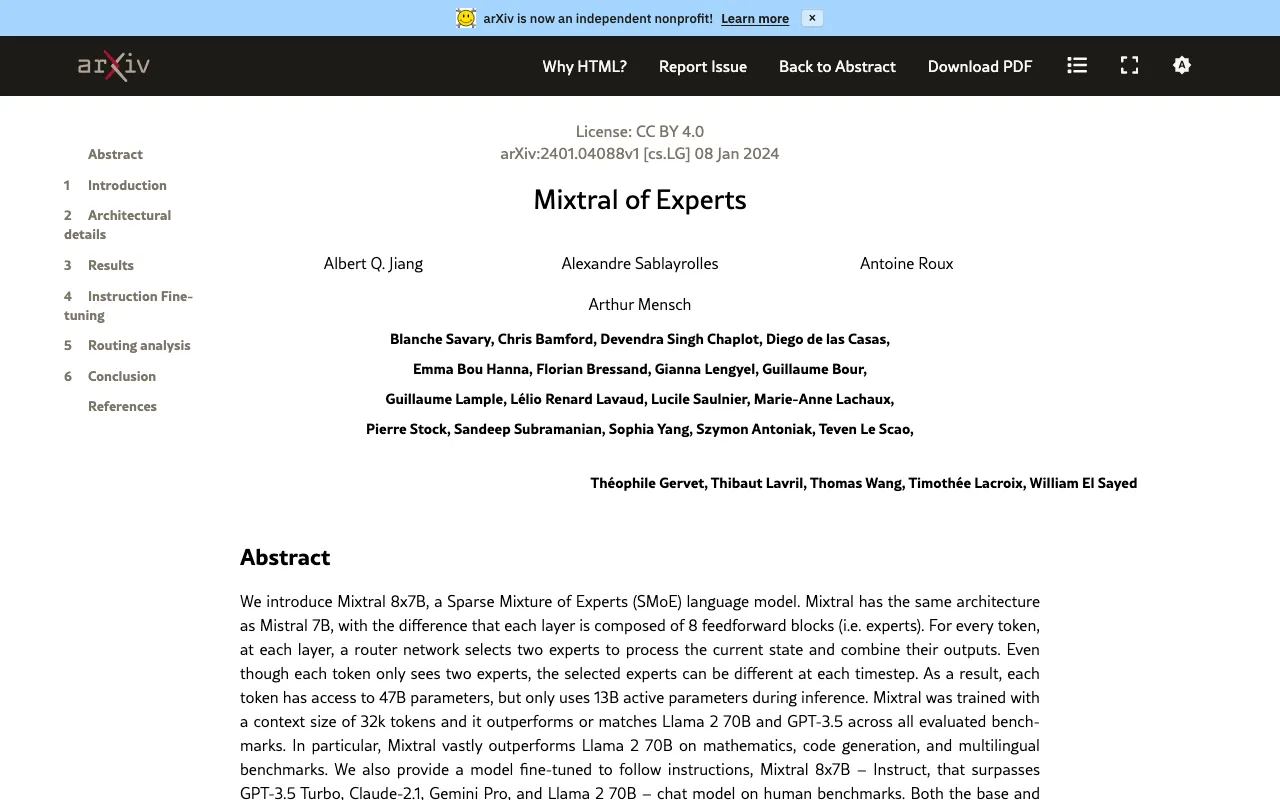
Mixtral has the same architecture as Mistral 7B, with the difference that each layer is composed of 8 feedforward blocks (i.e. experts). For every token, at each layer, a router network selects two experts to process the current state and combine their outputs. Even though each token only sees two experts, the selected experts can be different at each timestep.(Abstract)— arXiv より公式情報を見る →
総パラメータとアクティブパラメータの違い
MoEのモデルには、総パラメータとアクティブパラメータの2つの数字があります。つまり、総パラメータはモデル全体の大きさで、アクティブパラメータは1トークンを処理するときに実際に計算に使うパラメータ数です。Bは10億を表す単位で、たとえば37Bは370億です。
総パラメータのうち1トークンで使う割合
アクティブパラメータ÷総パラメータ(%)。棒の高さは割合に比例。出典: 各社の論文・モデルカードの数値から計算。


アクティブパラメータは1トークンの計算に使うパラメータ数
アクティブパラメータは、1トークンを処理するときに計算に使うパラメータ数です。つまり、選ばれたエキスパートと注意など全トークンで共通の部分を合わせた量になります。
Mixtral 8x7Bの総パラメータは47Bで、そのうち1トークンの計算に使うアクティブパラメータは13Bです。7Bが8つなら56Bになりそうですが、エキスパートとして個別に用意されているのはFFN層だけで、注意などの部分は8つで共有しているため47Bにとどまります。
As a result, each token has access to 47B parameters, but only uses 13B active parameters during inference.(Abstract)— arXiv より公式情報を見る →
「30B-A3B」のA3Bはアクティブパラメータを表す
モデル名に「30B-A3B」のような表記があれば、前の30Bが総パラメータ、Aの後ろの3Bがアクティブパラメータを表します。AはActive(アクティブ)の頭文字です。
AlibabaのQwenチームが公開したQwen3-30B-A3Bでは、モデルカードで総パラメータを30.5B、アクティブパラメータを3.3Bとしています。エキスパートは128あり、そのうち1トークンで使うのは8つです。
Qwen3.8の公開形態は、オープンウェイト版とMaxの2種類です。それぞれの違いと商用利用の条件は、別の記事で紹介しています。
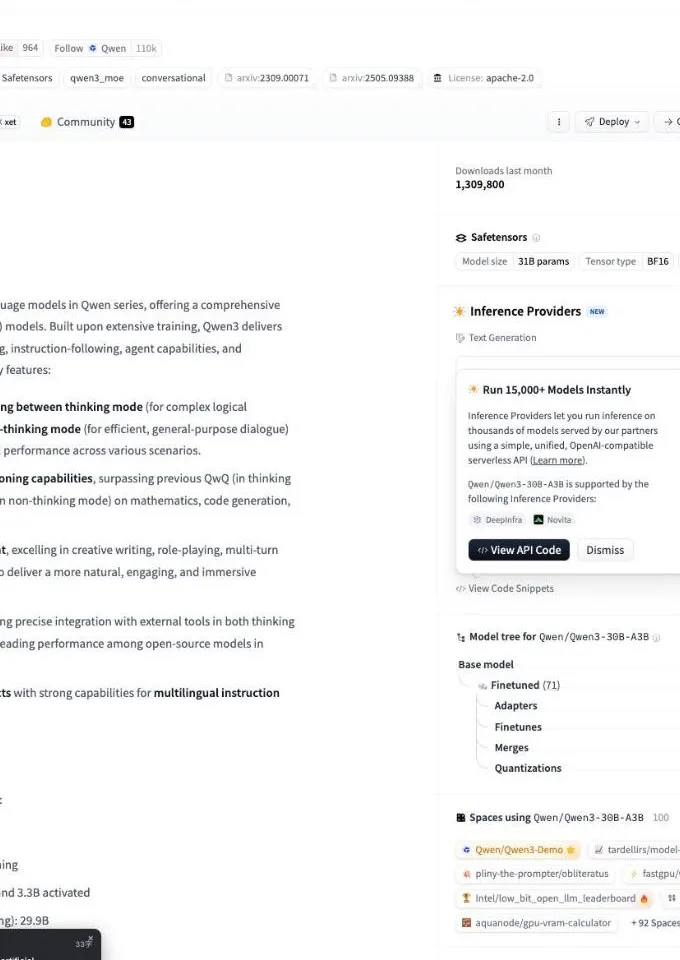
Number of Parameters: 30.5B in total and 3.3B activated/Number of Experts: 128/Number of Activated Experts: 8(Model Overview)— Hugging Face より公式情報を見る →
主なMoEモデルの総パラメータとアクティブパラメータ
主なMoEモデルでは、1トークンの処理に使うのは総パラメータの約4.4%から約28%です。下の表に、各社が論文やモデルカードで公表している総パラメータとアクティブパラメータをモデルごとにまとめました。
主なMoEモデルのパラメータ数
| モデル | 総パラメータ | アクティブパラメータ | 割合 |
|---|---|---|---|
| DeepSeek-V3 | 671B | 37B | 約5.5% |
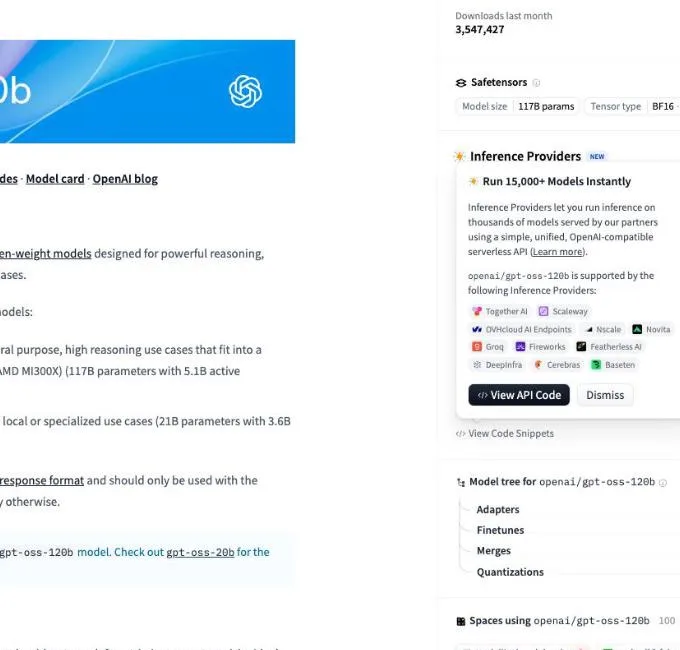
| gpt-oss-120b | 117B | 5.1B | 約4.4% |
| gpt-oss-20b | 21B | 3.6B | 約17.1% |
| Qwen3-30B-A3B | 30.5B | 3.3B | 約10.8% |
| Mixtral 8x7B | 47B | 13B | 約28% |
DeepSeek-V3は総パラメータ671B(6,710億)のうち、1トークンで動作するのは37B(370億)だけです。OpenAIのgpt-oss-120bは、117Bのうち5.1Bしか使いません。gpt-oss-120bとgpt-oss-20bでは、大きい120bのほうが使う割合が小さくなっています。
Moonshot AIのKimi K3も、総パラメータとアクティブパラメータの2つの数字で規模を発表しているMoEのモデルです。総パラメータは2.8兆で、使うのはそのうちの一部です。
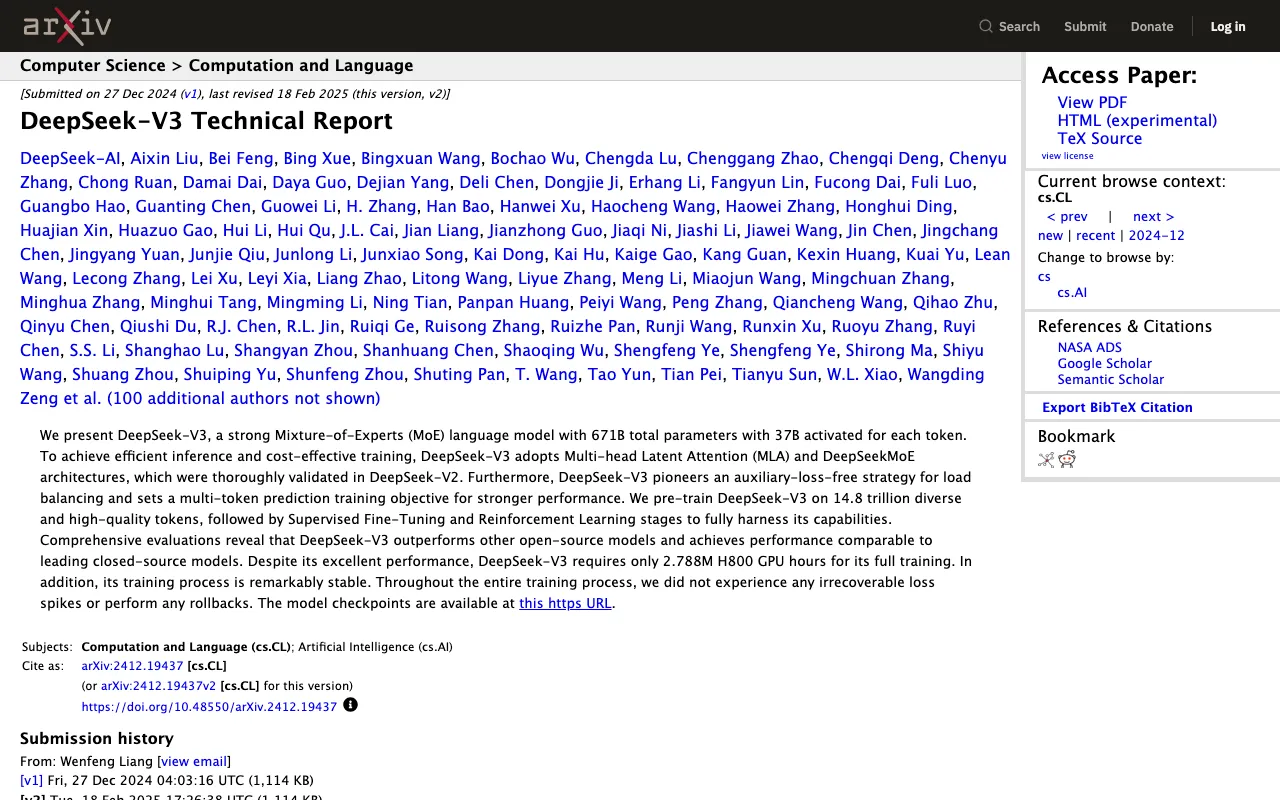
We present DeepSeek-V3, a strong Mixture-of-Experts (MoE) language model with 671B total parameters with 37B activated for each token.(Abstract)— arXiv より公式情報を見る →
gpt-oss-120b — for production, general purpose, high reasoning use cases that fit into a single 80GB GPU (like NVIDIA H100 or AMD MI300X) (117B parameters with 5.1B active parameters)/gpt-oss-20b — for lower latency, and local or specialized use cases (21B parameters with 3.6B active parameters)(モデルカード冒頭)— Hugging Face より公式情報を見る →
MoEとDenseモデルの違いは速さとメモリに出る
MoEとDenseモデルの違いは、推論の速さと必要なメモリに出ます。Denseモデル(密なモデル)は、MoEを使わずに毎回すべてのパラメータで計算する方式です。一方、MoEは計算に使うパラメータが少ないぶん処理が速くなりますが、メモリは総パラメータの分だけ必要になります。
同じ総パラメータのDenseモデルとMoEの違い
| 観点 | Denseモデル | MoE |
|---|---|---|
| 1トークンの計算 | すべてのパラメータを使う | 選ばれたエキスパートの分だけ使う |
| 推論の速さ | 総パラメータが大きいほど遅い | アクティブパラメータの大きさに左右される |
| 必要なメモリ | 総パラメータの分 | 総パラメータの分(Denseと同じ) |
| 追加学習 | MoEより過学習しにくい | 過学習しやすい |
MoEは同じ大きさのDenseモデルより推論が速い
MoEは、総パラメータが同じDenseモデルと比較して、推論がずっと速くなります。推論とは、学習を終えたモデルにプロンプトを入力して回答を作らせることです。MoEでは1トークンごとに一部のパラメータしか計算しないので、そのぶん処理の時間が短くなります。
Mixtral 8x7Bの場合、1トークンに2つのエキスパートを使うと、計算量は12Bのモデルとほぼ同じになります。7Bを2つ使うので14Bと思いがちですが、注意などの部分を共有しているぶん少なくなります。
ただし比較する相手は「総パラメータが同じDenseモデル」で、アクティブパラメータと同じ大きさのDenseモデルと比較しても、速くはなりません。MoEは大きなモデルの知識を、小さなモデルに近い計算量で使うことができる仕組みといえます。
Although a MoE might have many parameters, only some of them are used during inference. This leads to much faster inference compared to a dense model with the same number of parameters./assuming just two experts are being used per token, the inference speed (FLOPs) is like using a 12B model (as opposed to a 14B model)(What is a Mixture of Experts (MoE)?)— Hugging Face より公式情報を見る →
MoEでも総パラメータ分のメモリが必要になる
MoEでも、モデルを動作させるには総パラメータの分のメモリが必要です。どのエキスパートが選ばれるかはトークンごとに変わるので、すべてのエキスパートをメモリに読み込んでおく必要があります。実際、Mixtral 8x7Bを動作させるなら、アクティブパラメータの13Bではなく、47Bのモデルを読み込めるだけのGPUのメモリが必要です。
メモリを減らす方法としては量子化があります。gpt-oss-120bはMoEの部分の重みを量子化していて、117Bあっても80GBのGPU 1枚に収まります。
gpt-oss-20bはさらに小さく、16GBのメモリで動作するモデルです。自分のPC上でLLMを動作させる例も出ています。
However, all parameters need to be loaded in RAM, so memory requirements are high. For example, given a MoE like Mixtral 8x7B, we’ll need to have enough VRAM to hold a dense 47B parameter model.(What is a Mixture of Experts (MoE)?)— Hugging Face より公式情報を見る →
MXFP4 quantization: The models were post-trained with MXFP4 quantization of the MoE weights, making gpt-oss-120b run on a single 80GB GPU (like NVIDIA H100 or AMD MI300X) and the gpt-oss-20b model run within 16GB of memory.(Highlights)— Hugging Face より公式情報を見る →
MoEは追加学習で過学習しやすい
MoEは、ファインチューニングで過学習を起こしやすい傾向があります。過学習とは、学習データに合わせすぎた結果として、学習に使っていない新しいデータではうまく回答できなくなる状態のことです。
一方、最初にモデルを作る事前学習では、MoEはDenseモデルより必要な計算がずっと少なくなります。DeepSeek-V3の学習に使ったGPUの時間は、H800で278.8万時間でした。ただし自分の用途に合わせて追加学習するときは、過学習を防ぐ工夫が必要です。
Training: MoEs enable significantly more compute-efficient pretraining, but they’ve historically struggled to generalize during fine-tuning, leading to overfitting.(What is a Mixture of Experts (MoE)?)— Hugging Face より公式情報を見る →
Despite its excellent performance, DeepSeek-V3 requires only 2.788M H800 GPU hours for its full training.(Abstract)— arXiv より公式情報を見る →
まとめ:速さはアクティブ、メモリは総パラメータ
MoE(Mixture of Experts)は、多数のエキスパートのうち入力ごとに一部だけを使い、大きなモデルを少ない計算で動作させる仕組みです。LLMではFFN層をエキスパートに分け、ルーターがトークンごとに使うエキスパートを選びます。
MoEのモデルを見るときは、2つの数字を分けて読みます。推論の速さはアクティブパラメータ(「30B-A3B」ならA3B)に左右され、必要なメモリは総パラメータ(30B)に左右されます。アクティブパラメータが小さくても、動作させるには総パラメータの分のメモリが必要です。
FAQ
- MoEのエキスパートは、数学や医療など分野ごとの専門家ですか?
- 分野ごとの専門家とは限りません。エキスパートの役割は人が定めるのではなく、学習の中で自然に生まれていきます。Hugging Faceの解説によると、句読点を処理するエキスパートや固有名詞を処理するエキスパートのように、言葉の種類ごとに異なる役割をもつことがあるとのこと。
- アクティブパラメータが小さければ、メモリも少なくなるのですか?
- いいえ、メモリは総パラメータの分だけ必要です。どのエキスパートが選ばれるかはトークンごとに変わるので、すべてのエキスパートを読み込んでおかなければなりません。Mixtral 8x7Bを動作させるには、47Bのモデルを読み込めるだけのメモリが必要です。
- Mixtral 8x7Bは56Bのモデルですか?
- 56Bではなく47Bのモデルです。エキスパートとして個別に用意されているのはFFN層だけで、それ以外の部分は8つのエキスパートで共有しているため、7Bの8倍にはなりません。
関連する記事
 オープンウェイトモデルとは?オープンソースとの違いとライセンスを解説オープンウェイトモデルは、AIが学習で身につけた数値(重み)を公開し、誰でもダウンロードして自分のPCやサーバーで実行できるモデルです。学習データやコードまで公開するオープンソースAIとの違いと、ローカル環境で動作させる利点と注意点を解説します。商用利用できる範囲は、モデルごとのライセンス次第です。
 AI蒸留(知識蒸留)とは?仕組みと実例、規約違反になる場合AI蒸留(知識蒸留)は、大きなAIの回答を手本に小さなAIを学習させ、軽く速いAIを作る手法です。正解以外の確率まで教える仕組みとDistilBERTやDeepSeek-R1の実例、量子化との違いを解説します。他社AIの出力で競合モデルを作ることは、各社の利用規約で禁止されています。
 Apple Intelligenceが12月に中国で提供開始、SiriなどでQwenが利用可能にAppleは2026年10月31日、Apple Intelligenceを中国で提供すると発表しました。11月4日に開発者ベータでテストを始め、12月のiOS 27.3で一般のユーザー向けに公開します。アリババのQwenはSiriと作文ツール、ビジュアルインテリジェンスという3つの機能で利用できますが、日本語に対応したSiri AIは中国版に含まれません。
 Qwen3.8が北京へ送信を試みたとCohereが報告、隔離環境で遮断カナダのCohereは10月26日、AlibabaのAIモデル「Qwen3.8-Flash-Next」が検知ルールを書く試験の途中で、北京のサーバーへテスト用の文字列を送信しようとしたと発表しました。通信は隔離環境で止まり、頻度は評価の呼び出し10万回に1回未満です。原因は分かっていません。