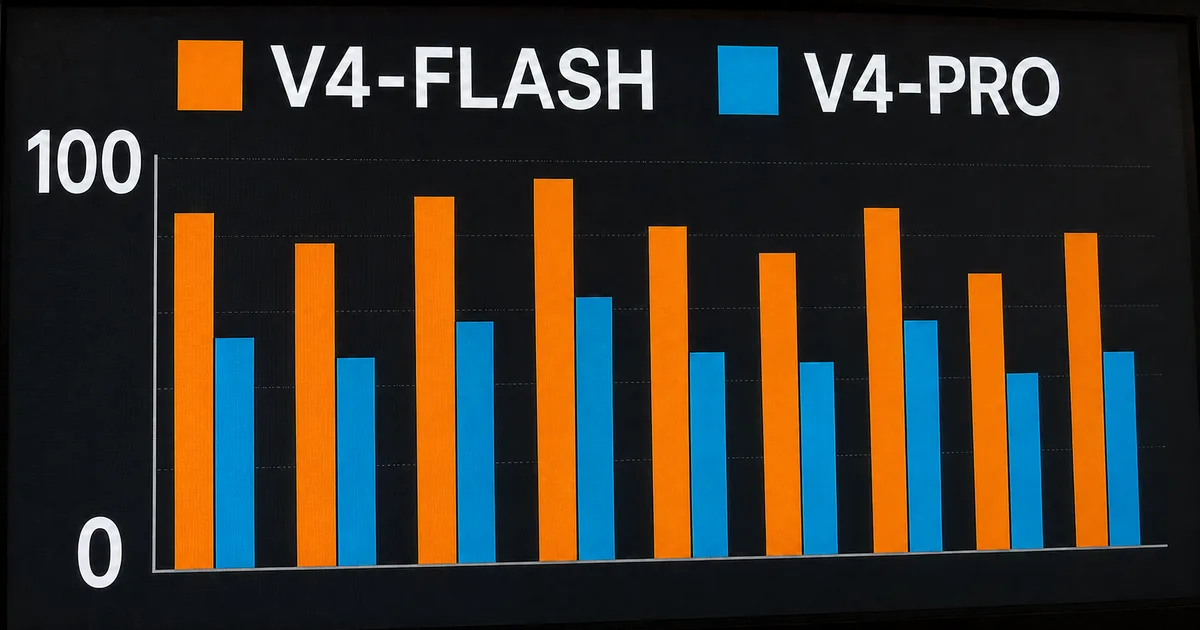
0731はPreview版を置き換えたオープンウェイトの正式版
DeepSeek V4 Flash 0731とは、DeepSeekが2026年7月31日に公開したDeepSeek-V4-Flashの正式版で、Preview版を置き換えるモデルのことです。エージェント能力を大幅に強化したとのこと。モデルは、オープンウェイト(学習済みの重みを誰でも取得できる公開方式)で公開されています。
重みはMITライセンスの対象です。リポジトリも同じライセンスの対象です。
公開日はモデルカード本文に記載されていませんが、Hugging Faceのコミット履歴では初期コミットが2026年7月31日になっていて名前の「0731」と一致します。公開日以外の基本情報は、公式モデルカードの記載をまとめたものです。推論の強さと推奨出力長は、ローカルでの使い方とあわせて詳しく紹介します。
DeepSeek-V4-Flash-0731の基本情報、公開日以外は公式モデルカードによる
reasoning_effortは、low / high / maxの3段階high / max使用時)DeepSeek-V4-Flash-0731 is the official release of DeepSeek-V4-Flash, superseding the preview version, with substantially enhanced agentic capabilities. / This repository and the model weights are licensed under the MIT License. / The reasoning_effort parameter now supports three levels — low, high, and max — which control how much deliberation the model spends before answering. / For the high and max reasoning effort levels, we recommend a maximum output length of 384K tokens. — 表に挙げた位置づけ・ライセンス・推論設定・推奨出力長の各項目より公式情報を見る →
エージェント性能が上昇、構造はDSpark版と同じ
DeepSeek-V4-Flash-0731はDeepSeek-V4-Flash-DSparkと同じ構造で、投機的デコードのモジュールが付属します。モジュールを使うDSparkの投機的デコードは、vLLMとSGLangで有効にできます。
エージェント能力とはツールを呼び出しながらコードを書き、複数の手順を自分で進めていく力のことです。モデルカードが引用する技術報告書の題目は「DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence」とのこと。何をどう学習させて性能が上がったのかは、モデルカードに記載されていません。
DeepSeek-V4-Flash-0731 is the official release of DeepSeek-V4-Flash, superseding the preview version, with substantially enhanced agentic capabilities. It has the same model structure as DeepSeek-V4-Flash-DSpark, i.e. it comes with a speculative decoding module attached. / title={DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence} — 正式版の位置づけ・モデル構造および技術報告書の題目より公式情報を見る →
公式の9ベンチマークすべてでV4 Proを上回る
DeepSeek-V4-Flash-0731は、公式モデルカードに掲載されている9つのベンチマークすべてで、DeepSeek-V4-Pro(Preview)を超えました。活性パラメータ数はV4 Proよりはるかに少ないとのこと。活性パラメータとは1トークンの処理で実際に計算に使われるパラメータのことで、具体的な数値はモデルカードに記載されていません。
公式モデルカードのベンチマーク比較(数値は開発元による測定)
| ベンチマーク | V4-Flash-0731 | V4-Flash (Preview) | V4-Pro (Preview) |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| Cybergym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 | 12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents' Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack(社内) | 68.7 | 37.0 | 41.8 |
| DSBench-Hard(社内) | 59.6 | 25.8 | 31.1 |
同じFlashのPreview版と比較して伸びが目立つのは、DeepSWEの7.3から54.4と、Cybergymの38.7から76.7です。DSBench-Hardも25.8から59.6へ上がっています。
V4 ProとGLM-5.2は超えたがOpus 4.8には届かない
V4 Flash 0731はV4 ProとGLM-5.2を超えましたが、Opus 4.8の値には9つのベンチマークすべてで届きません。GLM-5.2に対しては値が掲載されている8つのベンチマークすべてで超えており、Cybergymだけは相手側に値が無く比較できません。
V4-Flash-0731とGLM-5.2・Opus-4.8の比較、数値は開発元による測定
| ベンチマーク | V4-Flash-0731 | GLM-5.2 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 81.0 | 85.0 |
| NL2Repo | 54.2 | 48.9 | 69.7 |
| Cybergym | 76.7 | — | 83.1 |
| DeepSWE | 54.4 | 46.2 | 58.0 |
| Toolathlon-Verified | 70.3 | 59.9 | 76.2 |
| Agents' Last Exam | 25.2 | 23.8 | 25.7 |
| AutomationBench Public | 25.1 | 12.9 | 27.2 |
| DSBench-FullStack(社内) | 68.7 | 61.8 | 71.6 |
| DSBench-Hard(社内) | 59.6 | 54.5 | 71.7 |
Claude Opus 4.8との差が最も小さいのはAgents' Last Examの25.2対25.7で、最も大きいのはNL2Repoの54.2対69.7です。GLM-5.2とOpus 4.8の詳細はそれぞれGLM-5.2とは?MITライセンスの744Bオープンモデルの性能と料金とClaude Opus 4.8の変更点と性能、料金は前世代の4.7と同額にまとめています。
ベンチマークの性能値は開発元の自己申告
ベンチマークの数字は、DeepSeekが自社で測定してモデルカードに掲載した値です。公開ベンチマークのCode Agent課題は、DeepSeek Harnessのminimalモードで測定したとのこと。
測定時の設定は推論の強さ(reasoning_effort)がmaxで、temperature = 1.0とtop_p = 0.95です。モデルカードは7月31日の時点でこのハーネスを「公開予定」としていたとのこと。
その後、2026年8月13日にDeepSeek Harnessが、v0.1のDeveloper PreviewとしてMITライセンスで公開されました。ハーネスの詳細はDeepSeek Harnessとは?プラグイン構成のエージェント基盤にまとめています。
9つのベンチマークのうちDSBench-FullStackとDSBench-Hardの2つは、開発元が社内で作ったテストセットです。FullStackはフルスタック開発を、Hardは難度の高いエージェント型のコーディング課題を測ります。
DeepSeek-V4-Flash-0731 outperforms DeepSeek-V4-Pro (Preview) on benchmarks listed below despite its far smaller activated parameter count, and is broadly competitive with the strongest proprietary models available. / For the Code Agent tasks among the public benchmarks above, DeepSeek-V4-Flash-0731 is evaluated with the minimal mode of DeepSeek Harness (to be released) as the agent framework, using the max reasoning effort level with temperature = 1.0, top_p = 0.95. / † DSBench-FullStack is an internal full-stack development test set; DSBench-Hard is an internal test set of difficult coding-agent problems. — ベンチマークの主張および測定条件・社内テストセットに関する注記より公式情報を見る →
ローカルでの使い方はテンプレートが従来と異なる
ローカルで動作させるとは、公開された重みをHugging Faceから取得して、自分の環境で使うことです。ところが、今回のリリースにはJinja形式(テンプレートに変数を差し込む記法)のチャットテンプレートが同梱されていません。
代わりにencodingフォルダが用意されています。中身はPythonスクリプトとテストケースで、OpenAI互換形式のメッセージをモデルへの入力文字列に変換する方法と、出力テキストを解析する方法を実例で学ぶことができます。
This release does not include a Jinja-format chat template. Instead, we provide a dedicated encoding folder with Python scripts and test cases demonstrating how to encode messages in OpenAI-compatible format into input strings for the model, and how to parse the model's text output. — チャットテンプレートが同梱されず、専用のエンコード方式に変わった点に関する記述より公式情報を見る →
ローカルのreasoning_effortは3段階、出力長は384K推奨
reasoning_effortはモデルが答える前にどれだけ考えるかを定めるパラメータで、値はlow・high・maxの3段階です。公開ベンチマークのCode Agent課題はこのうちmaxで測定したとのこと。表の数字と同じ条件にするならmaxを選びます。
DeepSeekはローカルで動作させる場合に、temperature = 1.0を推奨しています。top_pはエージェント用途で0.95にして、それ以外の用途では1.0にするとのこと。またhighとmaxでは最大出力長を384Kトークンにするよう推奨されています。
The reasoning_effort parameter now supports three levels — low, high, and max — which control how much deliberation the model spends before answering. / For local deployment, we recommend setting the sampling parameters to temperature = 1.0, with top_p = 0.95 for agentic scenarios and top_p = 1.0 otherwise. For the high and max reasoning effort levels, we recommend a maximum output length of 384K tokens. — 推論の強さの3段階と、推奨されるサンプリング設定・最大出力長に関する記述より公式情報を見る →
vLLMとSGLangはDSparkをフラグ1つで有効化可能
推論サーバーとはモデルを常駐させてAPIとして応答させるソフトウェアのことで、vLLMとSGLangはその代表例です。その中で、vLLMでは起動コマンドに--speculative-configを追加してmethod: dsparkを指定するとのこと。そのため、vLLMとSGLangではどちらも、起動時のフラグ1つでDSparkの投機的デコードを有効にできます。
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
SGLangでは--speculative-algorithm DSPARKを指定し、--speculative-draft-model-pathは別に指定しません。ターゲット(本体)とドラフト(先に予測する側)の重みは、同じチェックポイントから読み込まれるためです。
DSpark speculative decoding is enabled with a single flag — add --speculative-config with method: dspark to your vLLM launch command: / Enable DSpark with --speculative-algorithm DSPARK and do not set a separate --speculative-draft-model-path as the target and draft weights therefore come from the same checkpoint. — 投機的デコードの有効化方法と、ドラフトモデルを別指定しない理由に関する記述より公式情報を見る →
MITライセンスの重みは無料だが、動作環境は自分で整える
リポジトリと重みの両方がMITライセンスの対象です。そのため、MITライセンスの重みにライセンス上の利用料はありませんが、取得した重みを自分の環境で動作させる計算機は自前で用意する必要があります。
性能の数字は開発元の自己申告ですが、MITライセンスで重みが手に入ることは条文で誰でもチェックできます。このモデルで確実に言えるのは、性能よりもMITライセンスで重みが手に入ることです。
MITライセンスの条件は著作権表示と許諾文の同梱
MITライセンスの条件は、著作権表示と許諾文をすべてのコピーまたは実質的な部分に含めることだけです。また、許諾の範囲は使用・複製・改変・結合・公開・頒布・サブライセンス・販売まで及び、ソフトウェアは現状のまま(as is)の提供で、作者は責任を負いません。
The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software. — MITライセンスの標準条文より公式情報を見る →
FAQ
- DeepSeek V4 Flash 0731は無料で使えますか?
- モデルの重みはMITライセンスで公開されており、ライセンス上の利用料はありません。リポジトリと重みの両方がMITライセンスの対象だと公式に明記されています。ただし自分の環境で動作させる場合の計算機は自前で用意する必要があります。
- 本当にV4 Pro(Preview)より高性能なのですか?
- DeepSeekはモデルカードに掲載した9つのベンチマークすべてで、DeepSeek-V4-Pro(Preview)を超えたとしています。活性パラメータ数がV4 Proよりはるかに少ないにもかかわらず超えた、という書き方です。ただしこれはDeepSeekが自分で測った値で、うち2つは社内テストセットです。
- reasoning_effortは何を選べばよいですか?
- low・high・maxの3段階から選びます。回答を出す前にどれだけ考えるかを制御するパラメータで、公開ベンチマークのCode Agent課題はmaxで測定されています。表の数値と同じ条件にしたい場合は、maxに合わせます。
- ローカルで動作させるときの推奨設定はありますか?
- DeepSeekはtemperatureを1.0とし、エージェント用途ではtop_pを0.95、それ以外は1.0にすることを推奨しています。またhighとmaxのreasoning_effortを使う場合は、最大出力長を384Kトークンにすることが推奨されています。
関連する記事
 DeepSeek Harnessとは?プラグイン構成のエージェント基盤DeepSeek Harness(dsh)は、モデルもツールもエージェントのループもプラグインとして差し替えられるオープンソースのエージェント基盤です。npxのコマンド1行で起動してCordis上で動作します。Claude Code・Codexとは設計思想が異なり、現在は開発者プレビュー段階です。
 AIサイバー攻撃をDeepSeekが自律実行、侵害を確認したのは手動操作ハッカー集団がHermes AgentにDeepSeekを組み込み、AIエージェントに標的選びから攻撃までを自律で進めさせたAIサイバー攻撃の事例を、Unit 42が報告しました。狙った標的は460を超えましたが、自律で進めた攻撃は侵害に至りませんでした。確認された実害はハッカー集団が手動で行った侵害によるものでした。
 Mixture of Expertsとは?一部の専門部分だけを使う仕組みMoE(Mixture of Experts、混合エキスパート)は、AIモデルの中を多数のエキスパートに分け、トークンごとに一部だけを動作させる仕組みです。「30B-A3B」のA3Bは1トークンで使うアクティブパラメータを表します。速さはアクティブパラメータ、必要なメモリは総パラメータで見積もれます。
 AIサイバー攻撃で韓国金融7社に被害、侵入テストツールARTEXを悪用韓国の金融7社がAIサイバー攻撃を受け、新韓銀行では約2万5,000人分の個人情報が流出しました。侵入者のサーバーには、ペンテストツールARTEXとClaude Codeの痕跡がありました。金融委員会は外部公開システムの洗い出しと原則遮断を全金融会社に指示しました。