埋め込みモデルを転用したMacの文字起こしアプリ
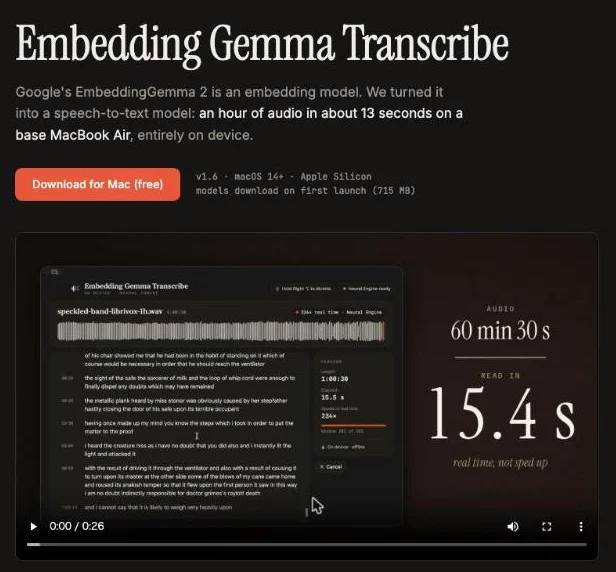
Embedding Gemma Transcribeは、EmbeddingGemma 2を音声の文字起こしモデルに作り替えた、Mac用の無料アプリです。 EmbeddingGemma 2はGoogleが公開した埋め込みモデルです。アプリは2026年10月時点でv1.6まで更新されています。
最大の特長は速さです。開発者の計測では、M3 MacBook Airで1時間の英語音声を12.6秒で文字起こししました。録音はMacの中だけで処理され、外部には送信されません。
一方で、単語の誤り率は主要な音声認識モデルより高く、日本語の音声には対応していません。英語の録音を自分のMac上ですばやく文字起こししたい人向けのアプリです。
EmbeddingGemma 2は声を同じ語の文字の隣に置く
埋め込みモデルとは、文章や画像の意味を数値の列(ベクトル)に変換するモデルです。 意味が近いものほど近い数値になるので、言葉が一致しなくても内容で探すことができます。
EmbeddingGemma 2は、Google DeepMindが2026年10月6日にApache 2.0で公開した埋め込みモデルです。テキスト・画像・音声・動画を、同じ空間のベクトルに変換できます。単語を声に出して読んだ音声は、同じ単語を文字で書いたもののすぐ近くの位置に変換されます。
開発者はこの性質に注目しました。音声を変換した位置から最も近い単語を選べば、そのまま文字起こしになるという発想です。
音声を受け取る部品(音声エンコーダー)は3億パラメータで、1回に最大5.5分の音声を処理できます。ベースモデルの詳しい中身は、別の記事で解説しています。
"EmbeddingGemma 2 is a multimodal embedding model: text, images, audio and video in one shared space."/"Say a word out loud and its audio lands close to the written word."/"So we tried reading words straight out of that space."— Embedding Gemma Transcribe より公式情報を見る →
"Features an 8K token context window (4x larger than EmbeddingGemma 1), allowing it to process up to 5.5 minutes of audio, 29 images, 58 video frames, or interleaved combinations thereof directly on local hardware."(特長の節)— Google より公式情報を見る →
Googleとは無関係の独立プロジェクト
Embedding Gemma Transcribeは、Googleとは提携しておらず、承認も受けていない独立プロジェクトです。公式サイトの末尾に明記されています。名前にGemmaが入っていますが、Googleがリリースしたアプリではありません。
Googleが作ったのは、アプリの元になったEmbeddingGemma 2のほうです。 Googleは自社でもEmbeddingGemma 2を使ったMac向けの試験アプリをリリースしていますが、本アプリとは別物です。
アプリ本体のライセンスやソースコードの公開については、公表されていません。会社のMacに入れる場合は、勤務先のソフトウェアルールなどにしたがって判断する必要があります。
"EmbeddingGemma 2 is made by Google DeepMind and released under Apache 2.0. This is an independent project, not affiliated with or endorsed by Google."— Embedding Gemma Transcribe より公式情報を見る →
音声認識モデルを作らずに英単語へ置き換える仕組み
音声を文字起こしする流れ
- 音声エンコーダーが音声を受け取る(手を加えずそのまま)
- 変換モジュールが、短い断片ごとにテキスト空間のベクトルを作る
- 英単語の中から最も近い語を選び、断片を並べる
- 別の小さなモデルが句読点と大文字を加える
Embedding Gemma Transcribeは、EmbeddingGemma 2の音声エンコーダーには手を加えず、そのまま使っています。 新しく追加したのは、小さな変換モジュール(開発者の呼び名は「reader」)です。変換モジュールは、音声を短く区切った断片を1つずつ、テキスト空間(単語や文章のベクトルが置かれる空間)のベクトルへ変換します。
Whisperのような一般的な音声認識モデルは、音声から文字までの全体を学習して作ります。このアプリは既存の埋め込みモデルの性質を利用して、足りない部分だけを補いました。
"EmbeddingGemma 2's audio encoder stays exactly as it is."/"A small reader moves each short slice of audio into the model's text space."— Embedding Gemma Transcribe より公式情報を見る →
約22万9,000語の英単語から最も近い語を選ぶ
テキスト空間のベクトルへ変換した断片は、約22万9,000語の英単語のうち最も近い1語に置き換わります。 その語を順に並べたものが文字起こし結果です。
句読点と大文字は、別の小さなモデルが後から付けます。英単語を並べただけでは文の区切りがわからないためです。
ベースモデルのEmbeddingGemma 2は、もともと文字起こし用に学習されたモデルではありません。このアプリは、検索のために作られた空間から最も近い英単語を探して文字起こししています。
"The closest of ~229,000 English words wins, and the slices become a transcript."/"A tiny extra model adds punctuation and capitals."/"The base model was never trained for speech-to-text."— Embedding Gemma Transcribe より公式情報を見る →
学習は変換モジュールだけ、H100 8基で2時間未満
学習したのは変換モジュールだけで、NVIDIAのGPU「H100」を8基使い、2時間かからずに終わりました。 学習データには、オープンなライセンスで公開された英語の音声を使っています。
音声認識モデルを一から作るには、大量の音声と長い学習時間が必要です。EmbeddingGemma 2の音声エンコーダーをそのまま流用したことで、この手間を大きく省けました。
ただし、英語の音声だけで学習しているため、対応する言語も英語に限られます。日本語で話しても、日本語の文字には変換されません。
"Only the reader is trained: under two hours on 8×H100, on openly licensed English speech."— Embedding Gemma Transcribe より公式情報を見る →
M3 MacBook Airで1時間の音声を12.6秒で処理
同じM3 MacBook Air(8GB)での処理速度(実時間の何倍か)
同じMacで比較すると、Embedding Gemma TranscribeはIBM Granite Speech 5.0 TurboCTCの倍近い速さです。1時間の音声にかかる時間は12.6秒と25.7秒で、半分以下に縮みます。
 Embedding Gemma Transcribe
 Granite Speech 5.0 TurboCTC
開発者の計測では、メモリ8GBのM3 MacBook Airで実時間の288倍の速さが出ました。 1時間の音声を12.6秒で文字起こししました。公式サイトのページ上部では、この値を丸めて「約13秒」と紹介しています。
ここでいう「実時間の何倍」は、1秒の処理で何秒分の音声を文字起こしできるかを表します。288倍なら、1秒で288秒分の音声を文字起こしできます。
Embedding Gemma Transcribeは、MacのNeural Engineで動作します。比較対象のIBM Granite Speech 5.0 TurboCTCは、同じMacのGPUで動作させたときの値です。Granite Speechは約150倍で、1時間の音声に25.7秒かかりました。
"an hour of audio in about 13 seconds on a base MacBook Air"/"288×"/"1 hour in 12.6 s"/"~150×"/"1 hour in 25.7 s"/"× real time: seconds of audio per second of processing. Rows 1–2: our tests on the same base M3 MacBook Air."— Embedding Gemma Transcribe より公式情報を見る →
Parakeetなど他モデルとの速度差はあくまで目安
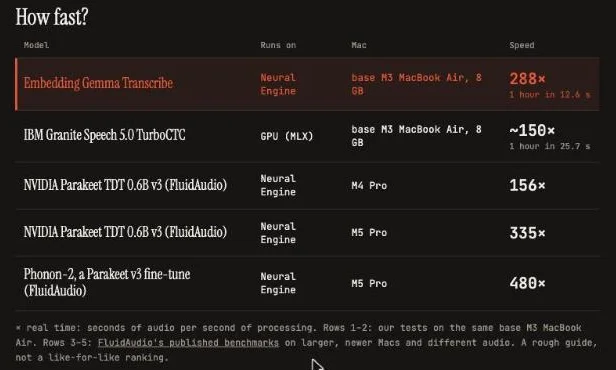
公式サイトの速度表には、NVIDIAのParakeet TDT 0.6B v3なども記載されています。ただしこれらは音声認識ツールのFluidAudioが公開した値で、測ったMacも音声も異なります。
公式サイトの速度表
| モデル | Mac | 速度 |
|---|---|---|
| Embedding Gemma Transcribe | M3 MacBook Air | 288倍 |
| Granite Speech 5.0 TurboCTC | M3 MacBook Air | 約150倍 |
| Parakeet TDT 0.6B v3 | M4 Pro | 156倍 |
| Parakeet TDT 0.6B v3 | M5 Pro | 335倍 |
| Phonon-2 | M5 Pro | 480倍 |
Phonon-2はParakeet v3を微調整したモデルです。M5 Proで480倍と、表の中で最も速い値が出ています。ただし開発者自身が、3〜5行目はより大きく新しいMacと別の音声で測った値だという但し書きを添えています。
同じ条件で並べた順位ではないため、どのモデルが最速かは判断できません。条件がそろっているのは、同じM3 MacBook Airで測った1〜2行目だけです。
"156×"/"335×"/"480×"/"Rows 3–5: FluidAudio's published benchmarks on larger, newer Macs and different audio. A rough guide, not a like-for-like ranking."— Embedding Gemma Transcribe より公式情報を見る →
精度は単語誤り率約5%で、日本語には非対応
精度と対応言語
単語誤り率(WER)は、文字起こし結果のうち何%の単語を誤ったかを表す指標です。 Embedding Gemma Transcribeの単語誤り率は2026年10月時点で約5%で、100語のうち5語ほどを誤る計算になります。数字は低いほど正確です。
開発者は、変換モジュールの学習を見直せば、主要な音声認識モデルとの差を縮められると考えています。文字起こしの精度にはまだ改善の余地があるとのこと。次の改良で取り組むとしています。
"Its word error rate is about 5% right now, against 2–3% for leading speech models. We believe a better-trained reader can close that gap; that's the next iteration."— Embedding Gemma Transcribe より公式情報を見る →
上位の音声認識モデルの誤り率は2〜3%
開発者によると、主要な音声認識モデルの単語誤り率は2〜3%とのこと。つまり、Embedding Gemma Transcribeの約5%は、その倍ほどの誤りがある水準です。
参考として、Googleが2026年8月に公開したGemini 3.5 Transcribeの単語誤り率を見ると、Artificial Analysisの計測で録音済みの音声は平均2.6%でした。リアルタイムの文字起こしでは4.0%です。詳しい性能は別の記事で解説しています。
ただし測った音声も方法も異なるため、5%と並べて順位をつけることはできません。会議記録のように誤りが許されない用途では、出力を読み直す手間が残ります。Embedding Gemma Transcribeは、大まかな内容を素早くつかむ用途に適しています。
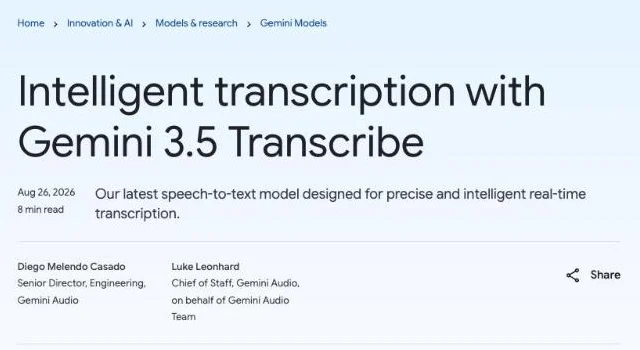
"More precise transcription: As measured by Artificial Analysis, achieves an average Word Error Rate (WER) of 4.0% for streaming and 2.6% for non-streaming use-cases."— Google より公式情報を見る →
英単語しか選ばないため日本語の音声は文字起こしできない
Embedding Gemma Transcribeが選ぶ語は約22万9,000語の英単語だけで、日本語の語は選ぶ対象に入っていません。 学習に使った音声も英語です。そのため、日本語で話した音声は文字起こしできません。
アプリの説明に「日本語非対応」とは書かれていませんが、仕組みから見て日本語の文字起こしには適していません。日本語の会議や講義の録音を文字起こししたい場合は、日本語に対応した文字起こしツールを選ぶ必要があります。PCやスマホで日本語の文字起こしを無料で行う方法は、別の記事で紹介しています。
"The closest of ~229,000 English words wins, and the slices become a transcript."/"Only the reader is trained: under two hours on 8×H100, on openly licensed English speech."— Embedding Gemma Transcribe より公式情報を見る →
Apple Silicon搭載のMacでの使い方
アプリの動作環境と料金
Embedding Gemma Transcribeは、macOS 14以降でApple Siliconを搭載したMacなら無料で使うことができます。 公式サイトの「Download for Mac (free)」のボタンからダウンロードします。
Intelのチップを積んだMacは対象外です。古いMacで試す前に、搭載しているチップを確認しておきましょう。
"Download for Mac (free)"/"v1.6 · macOS 14+ · Apple Silicon"— Embedding Gemma Transcribe より公式情報を見る →
初回起動時に715MBのモデルをダウンロード
アプリを初めて起動すると、文字起こしに使うモデル(715MB)のダウンロードが始まります。 インターネット接続が必要なのは、このときだけです。
Macの空き容量が少ない場合は、先に容量を空けておきましょう。ダウンロードが終われば、以降の処理はMacの中で完結します。
"models download on first launch (715 MB)"— Embedding Gemma Transcribe より公式情報を見る →
右Optionキーを押しながら話すとMacで音声入力可能
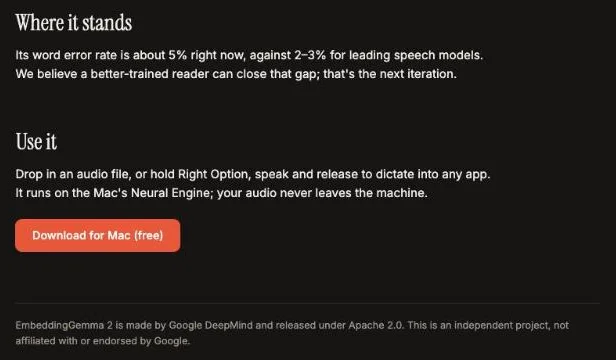
使い方は2通りあります。 1つは、音声ファイルをアプリの画面にドロップして文字起こしする方法です。録音済みのインタビューや講義の英語音声をまとめて処理するときに適しています。
もう1つは音声入力です。右側のOptionキーを押しながら話し、話し終えたらキーを離すと、話した内容が入力中のアプリに文字で入ります。メールやチャットなど、どのアプリでも使うことができます。
Macにもともとある音声入力の代わりになりますが、文字起こしが可能なのは英語だけです。日本語で話しても、日本語の文字としては入力されません。
"Drop in an audio file, or hold Right Option, speak and release to dictate into any app."— Embedding Gemma Transcribe より公式情報を見る →
Neural Engineで処理し、オフラインでも利用可能
Neural Engineは、Apple Siliconに組み込まれたAI処理専用の部品です。 Embedding Gemma TranscribeはNeural Engineで文字起こしを処理するため、インターネットに接続していなくても動作します。
録音した音声はMacの外部に送信されません。社外秘の会議や取材を録音した音声のように、クラウドのサービスへ送信したくない英語音声を文字起こしするときに役立ちます。
"It runs on the Mac's Neural Engine; your audio never leaves the machine."— Embedding Gemma Transcribe より公式情報を見る →
英語の録音を自分のMac上で処理する文字起こしアプリ
Embedding Gemma Transcribeは、EmbeddingGemma 2を転用した無料のMacアプリで、1時間の英語音声を12.6秒で文字起こしできます。 一方で単語誤り率は約5%で、日本語の音声は文字起こしできません。
英語の録音や英語の音声入力を、クラウドへ送信せず自分のMac上で処理したい人に適しています。日本語の録音には日本語に対応した文字起こしサービスを、誤りを減らしたい英語の録音には精度の高い音声認識モデルを使い分けるのが現実的です。
公式サイトのような英語のWebページを資料として残すなら、マークダウンに変換しておくと便利です。ページの構成や箇条書きを崩さずに編集できます。
FAQ
- 日本語の音声も文字起こしできますか?
- できません。文字起こしで選ぶ語は約22万9,000語の英単語だけで、学習に使った音声も英語です。日本語の録音を文字起こししたい場合は、日本語に対応した別の文字起こしツールを使う必要があります。
- Googleがリリースした公式のアプリですか?
- いいえ。Googleとは提携しておらず、承認も受けていない独立プロジェクトです。アプリの元になったEmbeddingGemma 2はGoogle DeepMindが作り、Apache 2.0で公開したモデルです。
- 料金はかかりますか?
- 無料です。公式サイトのボタンからダウンロードできます。動作にはmacOS 14以降で、Apple Siliconを搭載したMacが必要です。
- インターネット接続は必要ですか?
- 必要なのは初回起動時のモデルのダウンロード(715MB)だけです。文字起こしはMacのNeural Engineで処理され、音声はMacの外部に送信されません。
関連する記事
 リアルタイム文字起こしを無料で使う方法【PC・スマホ別】リアルタイム文字起こしは、会議や授業で話す声をその場で文字起こしできます。PCならGoogleドキュメントの音声入力やWindows 11のライブキャプション、スマホならiPhoneのボイスメモやAndroidの音声文字変換を無料で使うことができます。文字を残したいか、ネットに接続せず使いたいかで選びましょう。
 リアルタイム字幕を無料で出せる「早耳」とは?CPUだけの音声認識早耳(hayamimi)は、GPUもクラウドも使わずCPUだけでリアルタイム字幕を出せる無料の音声認識ツールです。メモリ2GB未満で動作し、日本語なら話し終えて約0.1秒で字幕が確定します。OBSの配信画面に字幕を表示でき、翻訳字幕も表示できますが、動作を確認した環境はWindows 11だけです。
 LLMの量子化とは?4bit・8bitの違いと、VRAM・精度への影響LLM量子化は、モデルの中の数値を16bitから4bitのように少ない桁数に置き換えて、必要なメモリを減らす手法です。仕組みに加え、4bitと8bitで精度がどれくらい落ちるか、GGUF・GPTQ・AWQの見分け方、自分のPCに合う量子化版の選び方までを1本にまとめた用語解説です。
 キーボード記号33個の読み方と打ち方一覧!アンダーバーの出し方もキーボード記号の読み方と打ち方がわかる早見表です。半角英数に切り替えて、Shiftキーと組み合わせるのが基本です。アンダーバーやバックスラッシュなど、迷いやすい記号は押すキーまで書いています。IMEパッドや変換を使えば、キーボードにない特殊記号も出すことができます。