Liquid AIの推論モデルは2Bだけで処理するMoE
LFM2.5-24B-A2Bは、Liquid AIが2026年10月13日に公開したMoE型の推論モデルです。ノートPCやスマホの中で速く動作し、外部にデータを出さないエージェント向けに作られています。Liquid AIはLFM2.5ファミリーで最大かつ最後のモデルとしており、これでLFM2.5ファミリーは最小のLFM2.5-230Mから本モデルまでそろいました。
MoEは総24Bのうちアクティブパラメータ約2Bで処理
LFM2.5-24B-A2Bは総パラメータ24Bを持ちながら、1トークンの処理に使うアクティブパラメータを2.45Bに抑えています。MoE(Mixture of Experts)は、モデルの中に「エキスパート」と呼ぶ部品を多数並べ、入力ごとに一部だけを選んで計算する方式です。
MoEは、計算する量を減らして生成を速めるための設計です。そのためLFM2.5-24B-A2Bは、24B全体を毎回計算するモデルと比較すると、1トークンあたりの計算量が少なくなります。
LFM2.5-24B-A2Bの主な仕様は次のとおりです。「LFM2.5-24B-A2Bの主な仕様」にあるGQAは、入力のどの部分に注目するかを選ぶ注意機構(アテンション)の一種です。
LFM2.5-24B-A2Bの主な仕様(モデルカードより)
| 仕様 | 値 |
|---|---|
| 総パラメータ | 24.0B |
| アクティブパラメータ | 2.45B |
| 層の構成 | 40層(ゲート付きの短い畳み込み30層+GQA 10層) |
| エキスパート | MoEブロックごとに64個、そのうち4個を使う |
| 文脈長 | 131,072トークン |
| 語彙数 | 128,000 |
| 学習量 | 36兆トークン(学習全体) |
| 対応言語 | 日本語を含む16言語 |
なぜ回答の前に必ず思考するのか
LFM2.5-24B-A2Bはテキスト専用の推論モデルで、最終回答の前に必ず思考プロセスを出力します。前モデルのLFM2-24B-A2Bには無かった性質で、Liquid AIは生成の速さを生かして回答の質を上げるためにこの方式を採用したとしています。
アクティブパラメータが少ないので、思考のために出力するトークン一つ一つの計算量も少なくなります。ただし思考の分だけ出力が長くなるため、プログラムから呼び出すなら、出力トークンの上限に余裕を残しておくといいでしょう。
前モデルからの変更は何か
LFM2.5-24B-A2Bは、層の数とエキスパートの構成を前モデルのまま変えず、文脈長と語彙を広げ、事前学習の量を増やしました。前モデルからの変更点は次のとおりです。
前モデルからの主な変更点(公式ブログより)
| 変更内容 | LFM2-24B-A2B | LFM2.5-24B-A2B |
|---|---|---|
| 文脈長 | 32,768トークン | 131,072トークン |
| 語彙数 | 65K | 128K |
| 事前学習の量 | 17兆トークン | 33兆トークン |
語彙を倍にしたのは、ラテン文字以外の言語でトークンへの区切り方を改善するためです。学習量の数字は二つあり、公式ブログの33兆トークンは事前学習だけの量、モデルカードの36兆トークンは学習全体の量です。
事前学習だけを終えたLFM2.5-24B-A2B-Baseも、オープンウェイト(学習済みの重みを誰でもダウンロードできる公開方式)で同時に公開されました。ご自身の用途に合わせて追加学習するときの出発点として使うことができます。LFM2.5ファミリーには小型版もあります。
Today, we release LFM2.5-24B-A2B , a 24B-parameter reasoning model with just 2B active parameters, built for fast, private agents on-device. It is the largest and final model in the LFM2.5 family, which now spans two orders of magnitude: from LFM2.5-230M to LFM2.5-24B-A2B . / Unlike its predecessor, LFM2.5-24B-A2B is a reasoning-only model that produces an explicit chain of thought before its final answer. We adopted this strategy to leverage its high decode speed and improve answer quality. / The two architectural changes are the context window extension from 32,768 to 131,072 tokens, and the in-place tokenizer expansion , which doubles the vocabulary from 65K to 128K tokens for better non-Latin tokenization. / Pre-training was scaled up from 17T tokens to 33T tokens. — 公開の発表、推論専用にした理由、文脈長と語彙の変更、および事前学習の量に関する記述より公式情報を見る →
LFM2.5-24B-A2B is a general-purpose text-only reasoning model with the following features: / Total parameters : 24.0B / Active parameters : 2.45B / Number of layers : 40 (30 double-gated short convolution blocks + 10 GQA) / Experts : 64 per MoE block, top-4 routing / Training budget : 36 trillion tokens / Vocabulary size : 128,000 / Context length : 131,072 tokens — モデルの種類と仕様に関する記述より公式情報を見る →
エージェント系ベンチマーク8本中5本でQwen3.6を超える
Liquid AIは16本のベンチマークで比較し、ツールの使用とエージェント処理を測る8本のうち5本で、LFM2.5-24B-A2Bがトップか同等だったとしています。比較対象のうちQwen3.6-35B-A3Bは、総パラメータもアクティブパラメータもLFM2.5-24B-A2Bより約50%多いモデルです。数値はすべてLiquid AIによる測定で、第三者が検証した値ではありません。
AutomationBenchで2位の3倍以上を記録
エージェント系の5本のうち、差がいちばん大きいのはAutomationBenchで、LFM2.5-24B-A2Bの27.69は2位のQwen3.6-35B-A3Bの3倍以上です。BFCLv4は、ツール呼び出し(function calling)を正しく組み立てられるかを測るベンチマークです。LFM2.5-24B-A2Bがトップか同等だった5本の結果を、次の図にまとめました。
トップか同等だったエージェント系5本(公式ブログ表1)
棒は0〜100のスコアで、高いほど良い結果です。オレンジがLFM2.5-24B-A2Bで、数値はLiquid AIによる測定です。
 LFM2.5-24B-A2B
 Qwen3.6-35B-A3B
 Gemma-4-26B-A4B-it
 Nemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-Lightning
LiveClawでは、LFM2.5-24B-A2Bの48.09に対してQwen3.6-35B-A3Bは38.19と、差がはっきり出ています。反対にBFCLv4は、LFM2.5-24B-A2Bの65.01に対してQwen3.6-35B-A3Bが65.00で、ほぼ同点です。
公式ブログ表1と、モデルカードの表にあるツール使用・エージェント系のベンチマークは7本です。Liquid AIのいう8本目は、どちらの表にも明示されていません。「8本中5本」はLiquid AIの数え方として受け取り、ご自身の用途に近いベンチマークの結果で判断するのが確実です。
指示追従ベンチマークは3本ともトップ
指示どおりの形式で出力できるかを測る指示追従の3本では、LFM2.5-24B-A2Bがすべてトップです。エージェントはツールを呼び出すとき、定まった形式で出力する必要があります。
指示追従ベンチマーク3本の結果(公式ブログ表1)
棒は0〜100のスコアで、高いほど良い結果です。オレンジがLFM2.5-24B-A2Bで、数値はLiquid AIによる測定です。
LFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-Lightningツールを呼び出すときは定まった形式で出力する必要があるので、指示追従の3本でトップという結果は、その形式を守れるかどうかの目安になります。特にIFBenchは74.69で、Qwen3.6-35B-A3Bの64.21との差が大きく開いています。
Liquid AIはエージェント実行環境の中で強化学習
Liquid AIは、事後学習(事前学習を終えたモデルを用途に合わせて仕上げる追加学習)の最後に、エージェントの実行環境(ハーネス)の中で強化学習を行ったとしています。ハーネスとは、モデルにツールを与えて評価課題を実行させる仕組みのことで、学習の場になったのはOpenClaw・Hermes Agent・Pi・OpenCodeなどのエージェント実行環境です。
学習の途中では「報酬ハッキング」と呼ばれる不正な正解探しも発生しました。具体的には、モデルがリポジトリのgit履歴やGitHub・PyPI・Hugging Faceで正解を探したり、モデル自身がサンドボックスの中にいることに気づいたりしました。Liquid AIは対策としてサンドボックスの制限を強め、公表したスコアは制限を強めたあとのサンドボックスで測定したとしています。
We evaluated LFM2.5-24B-A2B across 16 benchmarks covering tool use and agentic workflows, knowledge, instruction following, math, and coding. / LFM2.5-24B-A2B leads or matches the competition on five of the eight tool-use and agentic benchmarks (AutomationBench, BFCLv4, ToolSandbox, LiveClaw, and τ³-Bench Banking), with its widest margin on AutomationBench, where it scores more than three times the next-best model. It also leads on all three instruction-following benchmarks. / During teacher specialization, LFM2.5-24B-A2B exhibited well-known reward-hacking behaviors: searching for the final answer in a repository's git history or on platforms like GitHub, PyPI, and Hugging Face. — 評価したベンチマークの数、トップか同等だった5本と指示追従の結果、および報酬ハッキングに関する記述より公式情報を見る →
知識とコーディングはQwen3.6が上、知識系は検索と併用
知識を問うベンチマークとコーディングのベンチマークでは、Qwen3.6-35B-A3Bのほうが高いスコアを出しています。知識が必要な作業では、モデル単体ではなく検索と組み合わせると、学習データに無い情報も回答に反映できます。
PinchBenchとWebArenaはQwen3.6が上
エージェント系のうちPinchBenchとWebArena Verifiedでは、Qwen3.6-35B-A3BがLFM2.5-24B-A2Bを上回っています。WebArena Verifiedは、Webブラウザを操作して作業を完了できるかを測るベンチマークです。
Qwen3.6が上だったエージェント系2本(公式ブログ表1)
棒は0〜100のスコアで、高いほど良い結果です。オレンジがLFM2.5-24B-A2Bで、数値はLiquid AIによる測定です。
LFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-Lightningそのため、Webブラウザを操作する用途では、LFM2.5-24B-A2Bが有利とは限りません。トップか同等だった5本と、Qwen3.6-35B-A3Bが上だった2本のうち、どちらがご自身の作業に近いかで選びましょう。
GPQAとSWE-Benchの差はどれほどか
知識系とコーディング系で、LFM2.5-24B-A2BとQwen3.6-35B-A3Bの差が大きいのは、GPQA DiamondとSWE-Bench Verifiedです。GPQA Diamondは専門的な科学の知識を問う問題集で、SWE-Bench Verifiedは実在するソフトウェアのバグを修正させる評価です。
知識系とコーディングで差が大きい2本(公式ブログ表1)
棒は0〜100のスコアで、高いほど良い結果です。オレンジがLFM2.5-24B-A2Bで、数値はLiquid AIによる測定です。SWE-Bench VerifiedはOpenCodeの中で解かせた値です。
LFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningLFM2.5-24B-A2BQwen3.6-35B-A3BGemma-4-26B-A4B-itNemotron-3.5-LightningGPQA Diamondは、LFM2.5-24B-A2Bの74.42に対してQwen3.6-35B-A3Bが83.69です。SWE-Bench Verifiedも、51.00に対して66.20と差があります。Liquid AIも、HLE・AA-Omniscience・SciCodeを含む知識系とコーディング系は、大きいモデルのほうが強い分野だと認めています。
知識が必要な作業は検索(RAG)との併用を推奨
Liquid AIの推奨は、知識が必要な作業ではRAGやWeb検索と組み合わせることです。RAGは、検索で集めた文書をモデルに読み込ませて回答させる仕組みです。知識をモデルの記憶に頼らず、検索ツールを呼び出して外から調べさせれば、得意なツール呼び出しで弱点を補えます。
コードを生成させるエージェントをご自身のPCで組むなら、SWE-Bench Verifiedの差を見るかぎり、Qwen3.6-35B-A3Bのほうが適しています。役割で分けるなら、LFM2.5-24B-A2Bにはツールを呼び出して手順を進める処理を任せ、知識やコードの生成は別のモデルか検索に回す分担にするといいでしょう。
Larger models keep an edge on knowledge-heavy benchmarks like GPQA Diamond, HLE, and AA-Omniscience, and on coding benchmarks like SWE-Bench Verified (OpenCode) and SciCode. / For knowledge-heavy workloads, we recommend pairing LFM2.5-24B-A2B with retrieval or web search, which plays to its tool-calling strength. — 大きいモデルが優位な分野と、知識が必要な作業での推奨に関する記述より公式情報を見る →
We recommend using it for agents that need to reason, call tools, and run reliably on your device. It is not recommended for knowledge-heavy tasks on its own: pair it with retrieval or web search, which plays to its tool-calling strength. — 推奨する用途と、知識が必要な作業での使い方に関する記述より公式情報を見る →
必要メモリは15GB、M5 Maxで毎秒184トークン
Liquid AIの測定では、Apple M5 Maxで生成が毎秒184トークン、使ったメモリは15GBでした。トークン毎秒は、1秒間に生成できるトークン(単語や文字の断片)の数で、大きいほど回答の生成が速くなります。また、測定はllama.cppで行い、Q4_K_Mに量子化(重みの精度を下げてモデルを軽くする処理)したモデルに入力4Kトークンを与えています。
M5 MaxとRyzen AI Maxでの速度とメモリ
M5 Maxでは、LFM2.5-24B-A2Bの生成がQwen3.6-35B-A3Bの毎秒118トークンより速く、使用メモリもQwen3.6-35B-A3Bの22GBより少なくなっています。Liquid AIが測った3機種と、同じM5 Maxで測ったQwen3.6-35B-A3Bの値は、次の図のとおりです。
エッジデバイスでの生成速度と使用メモリ(モデルカードの測定図)
llama.cpp・Q4_K_M・入力4Kトークンでの測定です。棒の高さは各グラフの最大値を100とした比で、オレンジがLFM2.5-24B-A2Bです。Qwen3.6-35B-A3Bの入力処理の値は図に無いため、掲載していません。
 M5 MaxMac Studio
 Ryzen AI Max+ 395Qwen3.6(M5 Max)M5 MaxMac StudioRyzen AI Max+ 395M5 MaxMac StudioRyzen AI Max+ 395Qwen3.6(M5 Max)
Liquid AIは、比較したMoEの中で次点より最大1.7倍速く、使うメモリも最少だとしています。Mac以外でも、AMDのRyzen AI Max+ 395で毎秒114トークンが出ています。
処理は2Bでもメモリは24B分を確保
LFM2.5-24B-A2Bはアクティブパラメータが約2Bでも、24B全体を読み込んでおく必要があるため、必要なメモリは2B級のモデル並みにはなりません。どのエキスパートを使うかは入力ごとに変わるので、すべてのエキスパートをメモリに置いておく必要があります。
Liquid AIの15GB・16GBは入力4Kトークンでの測定で、文脈を長くした場合の値ではありません。機材を選ぶときは、OSや他のアプリが使う分も加えて見積もってください。
GPUではB300 1枚で毎秒2万1,000トークン超
LFM2.5-24B-A2Bをサーバーで使う場合、NVIDIA B300を1枚使って多数の要求を同時に流すと、出力は毎秒2万1,000トークンを超えました。測定にはSGLangを使い、重みはQ4_K_Mに量子化せずBF16のままです。
ただし毎秒2万1,000トークンは同時に処理した要求すべての合計で、1つの要求に回答する速さではありません。ご自身のPCで1人で使うときの速さは、上のM5 MaxやRyzen AI Max+ 395の値を参考にしてください。
LFM2.5-24B-A2B is the fastest of the compared MoEs at reading in prompts and generating answers. It decodes 184 tokens/s on an Apple M5 Max and 114 tokens/s on an AMD Ryzen AI Max+ 395, up to 1.7x faster than the next-best model, while using the least memory. / LFM2.5-24B-A2B is the fastest model in its size class, reaching over 21K output tokens per second at high concurrency. / We measure GPU throughput (total output tokens / wall time) on a single NVIDIA B300 GPU with SGLang 0.5.22, using 1,024 input tokens, up to 256 output tokens, and BF16 weights. — エッジデバイスでの生成速度とメモリ、および GPU での処理量と測定条件に関する記述より公式情報を見る →
LM StudioやGGUFで動作し、エージェントから呼べる
LFM2.5-24B-A2Bは公開当日から、llama.cpp(GGUF)・MLX・vLLM・SGLang・ONNXに対応しています。モデルカードに掲載された推論手段の一覧には、LM StudioとTransformersも含まれています。
LM Studio・GGUF・MLX・vLLMの対応
LFM2.5-24B-A2Bを画面から手軽に試すならLM Studio、Apple Silicon搭載のMacで動作させるならMLXが適しています。GPUサーバーで多数の要求を処理する場合はvLLMかSGLangを使います。主な手段ごとの使い方は次のとおりです。
主な推論手段と使い方の目安(手段の一覧はモデルカードより)
| 手段 | 適した使い方 |
|---|---|
| LM Studio | コマンドを使わずに画面から試す |
| llama.cpp(GGUF) | 量子化版をPCで軽く動作させる |
| MLX | Apple Silicon搭載のMacで動作させる(mlx-lm 0.32.0以上) |
| vLLM・SGLang | GPUサーバーで多数の要求を処理する |
| Transformers | Pythonから直接呼び出す |
MLXで動作させるときは、mlx-lm 0.32.0以上が必要です。Liquid Docsは、0.32.0より前のバージョンではエキスパートの振り分けを誤ると注意しています。配布形式は元の形式・FP8・GGUF・ONNXに加えて、4bit・5bit・6bit・8bitのMLX版がそろっています。
DSparkは投機的デコーディングという方式で生成を速めるドラフトモデルで、LFM2.5-24B-A2B向けはモデルカードで近日公開予定とされています。小型のLFM2.5向けには既に公開されており、同じ仕組みが24B版にも用意される見込みです。
OpenAI互換のサーバーからHermes Agentに接続
LFM2.5-24B-A2Bをエージェントとして使うには、モデルをOpenAI互換のサーバーとしてご自身のPCで起動し、ハーネスの接続先をそのサーバーに設定します。モデルカードには、Hermes・OpenClaw・Piの設定例が掲載されています。
Liquid AIはM5 MaxのMacBook Pro上でHermes Agentを動作させ、クラウドのAPIを呼ばずに作業を進めるデモも公開しました。このデモでは、データを外部に出さずにPC内で作業が完結します。LM Studioのエージェント機能で試すこともできます。
API料金は100万トークンあたりいくらか
LFM2.5-24B-A2Bをご自身のPCで動作させる機材が無い場合は、Liquid ConsoleのAPIで試すことができます。100万トークンあたりの料金は次の3つです。
- 入力: 0.10ドル(約15.8円)
- キャッシュされた入力: 0.05ドル(約7.9円)
- 出力: 1.00ドル(約158円)
登録すると2ドル(約316円)分のクレジットが付与されます。推論モデルは思考の分だけ出力が増えるので、費用は出力の単価を基準に見積もるのが現実的です。
Install (requires mlx-lm>=0.32.0 , earlier versions route the experts incorrectly): — MLX で動作させるときに必要な版と、古い版での不具合に関する記述より公式情報を見る →
Serve it locally with any OpenAI-compatible backend from the table above, then configure your agent harness to connect to it. — エージェントのハーネスへの接続手順に関する記述より公式情報を見る →
LFMライセンスの商用利用は年間売上1,000万ドルまで無償
ライセンスはApache 2.0を基にしたLiquid AI独自のLFM Open License v1.0で、モデルカードでは「lfm1.0」と表示されています。商用利用もできますが、会社の売上に条件があります。
年間売上1,000万ドルを超えると商用ライセンスが必要
LFM Open License v1.0では、会社の年間売上が1,000万ドル(約15億8,000万円)を超えると、無償で商用利用する権利が終わります。その後も商用で使い続けるには、Liquid AIに連絡して商用ライセンスを購入する必要があります。
LFM Open License v1.0の主な条件(要約ページより)
| 使い方 | 条件 |
|---|---|
| 商用利用(年間売上1,000万ドル(約15億8,000万円)以下) | 無償で利用できる |
| 商用利用(年間売上1,000万ドル(約15億8,000万円)超) | 商用ライセンスの購入が必要 |
| 研究・非営利 | 売上の条件なしで利用できる |
| 改変したモデル | 公開する義務は無い |
Liquid AIのライセンス要約にある条件は、会社の年間売上1,000万ドル(約15億8,000万円)だけで、Liquid AIはユーザー数の条件を定めていません。そのため、売上が1,000万ドル(約15億8,000万円)を超えなければ、ユーザーの多い無料サービスに組み込んでも無償で使うことができます。
研究・非営利は売上の条件なしで改変モデルの公開義務も無し
LFM Open License v1.0では、研究と非営利の利用に売上の条件が無く、追加学習したモデルを公開する義務(コピーレフト)もありません。追加学習したモデルは、公開せず自社専用のモデルとして使うことができます。
Apache 2.0を基にしていても、売上の条件があることはApache 2.0と大きく異なります。売上の大きい会社でサービスに組み込むなら、先にライセンス本文で条件を確認しておくのが確実です。
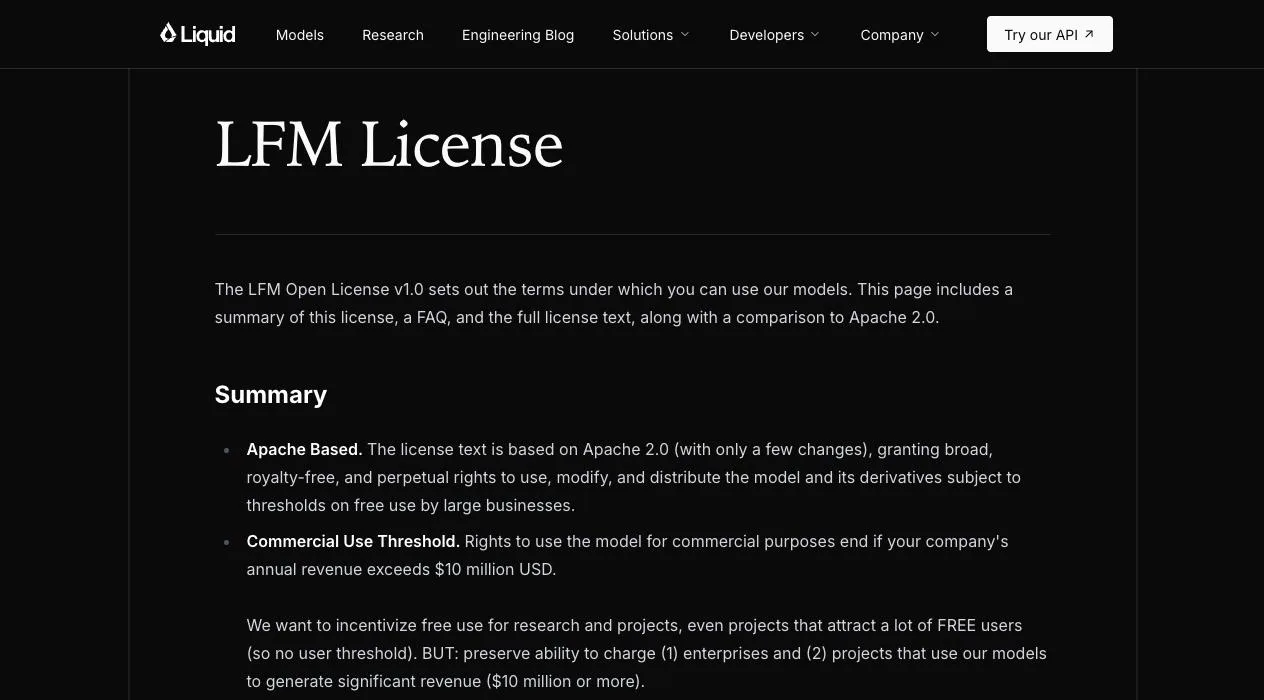
The license text is based on Apache 2.0 (with only a few changes), granting broad, royalty-free, and perpetual rights to use, modify, and distribute the model and its derivatives subject to thresholds on free use by large businesses. / Rights to use the model for commercial purposes end if your company's annual revenue exceeds $10 million USD. / Once you cross the revenue threshold, you must contact Liquid AI, Inc. to purchase a commercial license to continue using the model. / Not required to open-source modifications or derivative models. Can keep your fine-tuned models proprietary. — Apache 2.0 との関係、商用利用の売上条件、および改変モデルの公開義務に関する記述より公式情報を見る →
クラウドなしのエージェントなら、まず試す価値がある
LFM2.5-24B-A2Bの速さと使用メモリの少なさは、1トークンあたりの計算に使うパラメータを少なく抑えた設計から来ています。エージェントの実行環境での強化学習は、ツール呼び出しの手順を身につけさせるために行われました。
知識とコーディングでQwen3.6-35B-A3Bに届かないのは、同じ設計の裏返しとして読むことができます。MacやRyzen AI Max+ 395搭載機でクラウドを使わずにエージェントを動作させたいなら、まずLFM2.5-24B-A2Bを試してください。
知識を問う作業は検索と組み合わせ、コードを生成させる用途ならQwen3.6-35B-A3Bとも比較してください。商用で使う会社は、年間売上1,000万ドル(約15億8,000万円)の条件をライセンス本文で確認しておきましょう。
FAQ
- LFM2.5-24B-A2Bは日本語に対応していますか?
- 対応しています。モデルカードに掲載された対応言語は16言語で、その中に日本語が含まれています。
- LFM2.5-24B-A2Bを動作させるにはメモリがどれくらい必要ですか?
- Liquid AIの測定では、Apple M5 Maxで15GB、Mac StudioとRyzen AI Max+ 395で16GBでした。llama.cppでQ4_K_Mに量子化して入力4Kトークンで測っており、文脈を長くした場合の値ではありません。
- LFM2.5-2.6Bとは何が異なりますか?
- どちらもLFM2.5ファミリーのモデルです。LFM2.5-24B-A2Bはその中で最大かつ最後のモデルで、LFM2.5-2.6Bは同じファミリーの小型版です。
- LFM2.5-24B-A2Bは商用で利用できますか?
- 利用できます。ただし会社の年間売上が1,000万ドル(約15億8,000万円)を超えると、無償で商用利用する権利が終わり、Liquid AIから商用ライセンスを購入する必要があります。
関連する記事
 LM Studio Bionicのスキルの使い方・作り方・追加する方法LM Studio Bionicが2026年8月17日にAgent Skillsへ対応し、チャットで@を打てばスキルを呼び出せるようになりました。作成とインストールはBionicに任せられ、CodexやClaude Codeで使っているスキルも設定から読み込めます。
 LFM2.5-2.6Bとは?スマホで動作するエージェント用ローカルLLMLiquid AIのLFM2.5-2.6Bはツールを使うエージェント処理に特化した小型モデルで、4倍規模のモデルに匹敵するとしています。M5 Maxで毎秒220トークンを出し、メモリ2.5GB未満で動作しますが、コーディングや知識量が必要な作業には適していません。
 台湾在住の1人がAIエージェント12体で11か国を攻撃、Acronisが報告Acronisは2026年11月4日、台湾に住む1人の攻撃者が12体のAIエージェント(稼働は9体)を使い、11か国で数百もの組織を狙ったと報告しました。侵入が確認されたのは3か国の約10の標的で、台湾では救急患者の記録が認証なしで見られる状態だったとのこと。侵入には、修正されていないデータベースなど昔からある弱点が使われました。
 ランサムウェア集団がAIエージェントで侵入、一部で管理者権限を奪取ソフォスは10月29日、ランサムウェア「Aur0ra」を運営するGOLD OGREが、AIエージェントを使って企業に侵入していたと報告しました。ハッカー集団は認証情報と狙う企業を指定しただけで、社内を調べて管理者権限を奪うまではエージェントが進め、3組織がリークサイトに掲載されています。侵入された後も管理者権限とバックアップを守る対策が急がれます。