Muse WonderとFullはどう異なるのか?
Muse WonderはMetaがAIエージェント向けに作ったモデルで、上位版のFullとあわせてMetaでもっとも高性能なシリーズです。AIエージェントとは、目的を与えると達成までの手順をAI自身で考え、必要なツールを使い分けながら自律的に作業を進めるAIのことで、Muse Wonderと上位版のMuse Wonder Fullは、2026年10月12日に同時に発表されました。
2つのモデルは、性能と利用できる場所の両方が異なります。主な違いは次のとおりです。
| 比較 | Muse Wonder | Muse Wonder Full |
|---|---|---|
| 利用できる場所 | Meta Model API・Muse Code | Muse Code(Power・Maximumプラン) |
| 支払い | APIは使った量で課金 | Muse Codeの月額に含まれる |
| 第三者の総合指標 | 52 | 56 |
| 読み込める量 | 100万トークン | 100万トークン |
ご自身のアプリにAIを組み込む場合、APIで呼び出せるのはWonderだけです。Muse Codeで大きな開発を任せたい人には、上位版のFullが適しています。
個人用から業務まで幅広いAIエージェント向け
Muse Wonderは暮らしの用事から専門的な業務まで、ユーザーに代わってこなすAIエージェントを動作させるためのモデルです。Metaは賃貸契約書の内容を確認する作業や保険金の請求に加えて、アプリの開発にも使うことを想定しています。
入力はテキスト・画像・動画・音声の4種類で、出力はテキストです。コンテキスト長とは、AIモデルが1回のやり取りで読み込める情報量の上限のことで、Muse Wonderは100万トークンに対応しています。
Muse WonderはMetaが4月に出したMuse Sparkの開発で得た成果をもとに、事前学習と強化学習の規模を広げて作ったモデルです。Metaは学習にギガワット級のデータセンター「Prometheus」を使いました。
Metaは14か月前にAI開発を一から作り直す取り組みに着手しており、今回のモデルをその成果と位置づけています。CNBCの報道によると、開発中のコードネームは「Watermelon」だったとのこと。
Today, we’re excited to introduce the Muse Wonder series with Muse Wonder and Muse Wonder Full, our most capable models that deliver state-of-the-art performance on personal and professional agentic tasks. / Muse Wonder is available today through the Meta Model API and Muse Code, and Muse Wonder Full is available today for Muse Code subscribers. / Muse Wonder will soon power experiences in Muse, and will roll out first to subscribers. — 発表ブログ冒頭の、モデルの位置づけと提供先の説明より公式情報を見る →
FullはMuse Codeで月額50ドル以上の契約が必要
Wonderは発表の日から、開発者向けのMeta Model APIとMuse Codeで利用できます。Fullの提供先はMuse Codeの契約者だけで、APIからは呼び出せません。
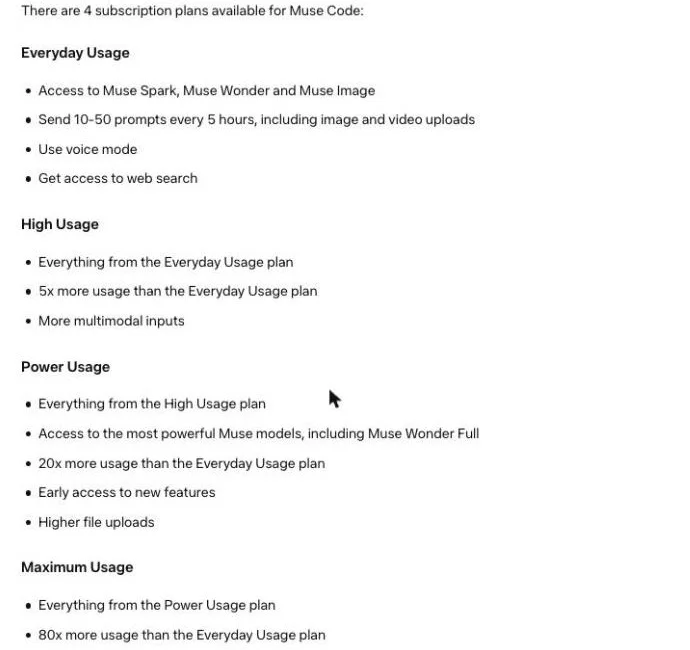
Muse Codeの公式文書を確認すると、Fullを含むのはPower UsageとMaximum Usageの2プランです。利用できる量は最安のEveryday Usageを基準に、Powerが20倍、Maximumが80倍です。
CNBCの報道によると、月額はそれぞれ50ドル(約7,922円)と200ドル(約3万1,690円)とのこと。Wonderのほうは、最安のEveryday Usageから使うことができます。
個人向けのエージェントアプリ「Muse」にも近くWonderが搭載され、まず課金ユーザーから順に提供される予定です。CNBCの報道によると、MuseアプリでWonderを使うには月額20ドル(約3,169円)か100ドル(約1万5,850円)のプランへの加入が必要になるとのこと。
Everyday Usage / Access to Muse Spark, Muse Wonder and Muse Image / Power Usage / Everything from the High Usage plan / Access to the most powerful Muse models, including Muse Wonder Full / 20x more usage than the Everyday Usage plan / Maximum Usage / Everything from the Power Usage plan / 80x more usage than the Everyday Usage plan — Muse Code の4プランのうち、Everyday Usage・Power Usage・Maximum Usage の説明より公式情報を見る →
Active MemoryとActive Focusは何か?
Metaは、Muse Wonderの特徴としてActive MemoryとActive Focusの2つを打ち出しています。どちらも、AIエージェントに長い仕事を任せたときに発生しやすい「前に伝えた条件を忘れる」「途中で止まる」といった失敗を減らすための機能です。
Active Memoryは会話をまたいで情報を思い出す機能
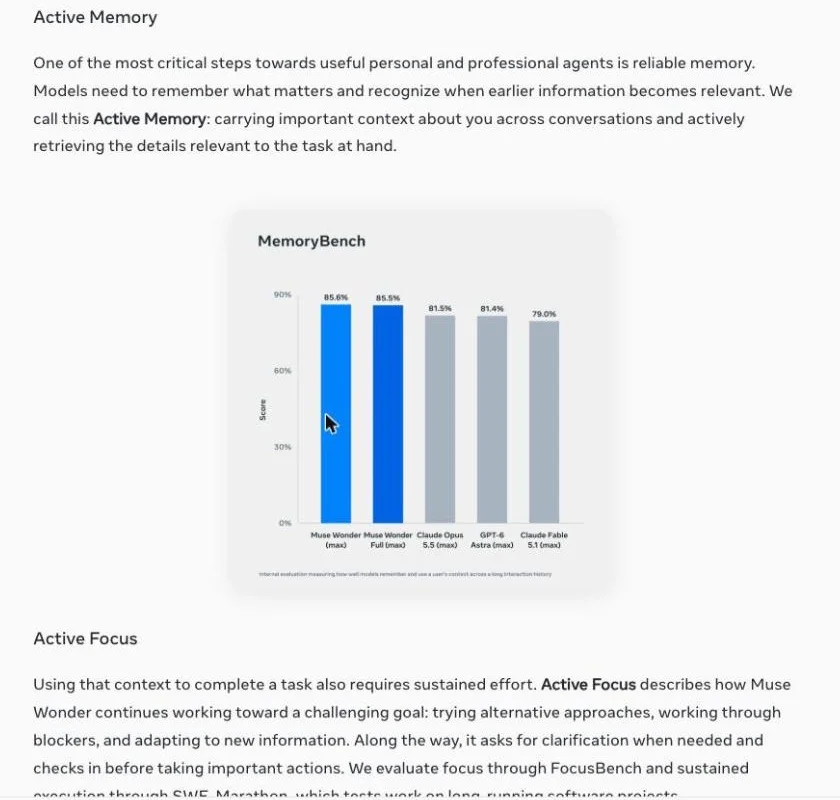
Active Memoryはユーザーにとって大事な情報を次の会話へ持ち越し、今の作業に関係する部分をAI自身で取り出します。したがって、前に伝えた条件を指示のたびに言い直さなくてよくなります。
Metaは会話をまたいで覚える力を、社内の評価「MemoryBench」で計測しました。Muse Wonderの2モデルはどちらも85%台で、他社の3モデルを上回っています。
MemoryBenchのスコア(Meta社内の評価・%)
Muse Wonderの2モデルが85%台に達し、他社の3モデルとは4ポイント以上の差があります。ただし評価を作ったのも計測したのもMetaです。


外部の機関による検証結果はまだ出ていません。この差は、現時点ではMetaが自社で計測した結果として位置づけるのが妥当です。
Active Focusは行き詰まると別の方法を試す機能
Active Focusは難しい目標に向かう途中でつまずいても、別のやり方を試しながら作業を続ける機能です。新しい情報が得られれば進め方を変え、必要なときはユーザーに聞き返し、重要な操作の前にはユーザーに確認します。
MetaでAI部門を率いるアレクサンドル・ワン氏はCNBCの取材に対し、夕食の予約や空席を調べるような作業でエージェントがつまずかないようにしたかったと述べています。現実の作業では障害や想定外のことが発生するため、止まらずに別の方法を試み、いつでもユーザーに判断を仰げるように学習させたとのこと。
CNBCは同じ記事で、Museアプリについて「エージェントが許可なく個人のメッセージにアクセスした」という苦情がSNSに投稿されていることと、Metaがこの苦情を否定していることを伝えました。ワン氏は、会話の早い段階で許可した内容をユーザーが忘れている例があるとしています。重要な操作の前に確認する設計があっても、何を許可したかはユーザー側でも覚えておく必要があります。
We call this Active Memory: carrying important context about you across conversations and actively retrieving the details relevant to the task at hand. / Active Focus describes how Muse Wonder continues working toward a challenging goal: trying alternative approaches, working through blockers, and adapting to new information. Along the way, it asks for clarification when needed and checks in before taking important actions. — Frontier Capabilities 節の Active Memory と Active Focus の説明より公式情報を見る →
Claude Opus 5.5など他社モデルとの性能比較
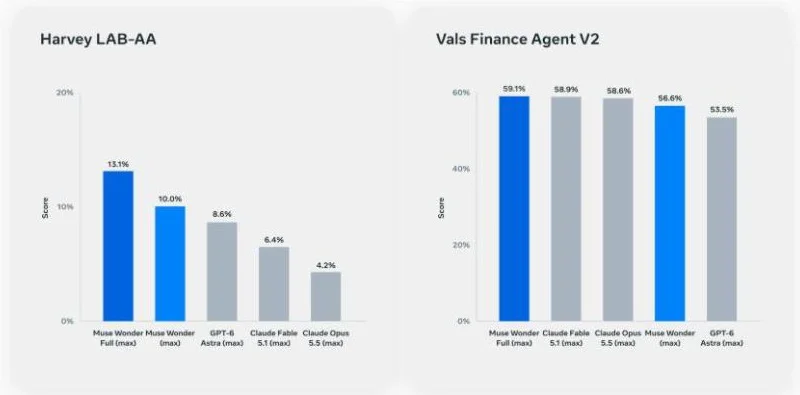
ベンチマークとは、AIモデルの性能を共通の問題集で採点して比較するための試験のことです。Metaが公開した評価表には14種類の試験があり、FullとClaude Opus 5.5がそれぞれ6種類でトップを分け合いました。比較対象は次の3モデルです。数値はどれも推論の設定を最大(max)にしたときのもので、SWE-MarathonのFullだけはxhighという別の設定で計測されています。
- Claude Fable 5.1(Anthropic)
- GPT-6 Astra(OpenAI)
- Claude Opus 5.5(Anthropic)
Metaの評価表では法律や長時間の開発でFullがトップ
法律の作業を評価するHarvey LAB-AAと、長時間のソフトウェア開発を評価するSWE-Marathonでは、Fullが他社の3モデルを大きく引き離しました。一方で、ゼロからのプログラム作成や医療の試験では、Claude Opus 5.5のほうが上です。
主な試験のスコア(Metaの評価表より)
Fullの13.1に対してOpus 5.5は4.2で、3倍以上の差があります。ただ、どのモデルも点数そのものはまだ低い水準です。
Fable 5.1GPT-6 AstraOpus 5.5FullとWonderが1位と2位で、他社の3モデルは40点台にとどまります。Fullの数値だけは設定がxhighです。
Fable 5.1GPT-6 AstraOpus 5.5こちらはOpus 5.5が70.5で抜けていて、Fullとは11ポイント以上の差があります。
Fable 5.1GPT-6 AstraOpus 5.5医療ではOpus 5.5とGPT-6 Astraが65点台で上位を占め、Fullは3位です。
Fable 5.1GPT-6 AstraOpus 5.5長時間のコーディングを評価するDeepSWE 1.1でも、Fullが79.0でOpus 5.5の74.2を超えました。反対に、Opus 5.5がトップを取った試験は次の6つです。この6つには、評価表の末尾にある第三者の総合指標も含まれます。
- ProgramBench(ゼロからのプログラム作成)
- OSWorld(パソコン操作)
- HealthBench Pro(医療)
- Terminal-Bench(ターミナル操作)
- JobBench(仕事の作業・75.4対75.3の僅差)
- Artificial Analysisの総合指標(58)
Metaはモデルカードで、他社モデルの数値には第三者や提供元の報告値を優先して使ったとしています。報告値が無い試験では、Metaが社内で計測した値などを使ったとのこと。社内で計測した分は、他社モデルに合わせて設定を調整したものとは限らないとMetaも認めています。
第三者の総合指標で1位のモデルはどれか?
外部の評価サイトArtificial Analysisの総合指標では、Opus 5.5が58で1位、Fullは56で2位でした。Metaの評価表とは順位が入れ替わります。
第三者の総合指標(Artificial Analysis)
Fullは2位でOpus 5.5に2点届かず、APIで利用できるWonderは6モデルの中で最も低い52です。
Claude Opus 5.5Muse Wonder FullClaude Fable 5.1GPT-6 Astra Gemini 4 ArgonMuse Wonder
Wonderは52で、Claude Fable 5.1やGPT-6 Astra、Gemini 4 Argonの53をわずかに下回っています。前モデルのMuse Spark 1.3は48だったので、Metaのモデル群では大きく伸びました。開発者がAPIで利用するモデルはWonderなので、比較の目安になるのは56ではなく52の数字です。
The Muse Wonder series achieves state-of-the-art results across key benchmarks for personal and professional agents, memory, and coding. / The full results below compare Muse Wonder and Muse Wonder Full with other frontier models across a broad evaluation suite. / Our evaluations include tasks in law, finance, and health that test this ability. Harvey’s Legal Agent Benchmark (LAB), for example, requires models to work with source documents and follow detailed instructions to produce legal work products. — Frontier Capabilities 節の冒頭と Domain Expertise の説明より公式情報を見る →
Muse Wonderの料金と日本での使い方
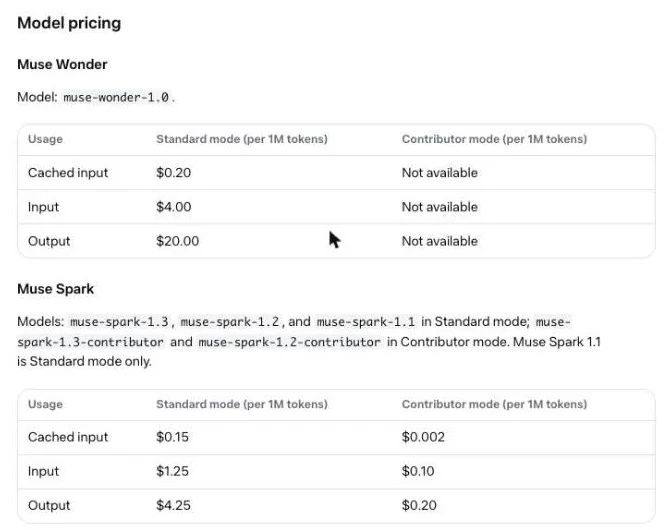
トークンは、AIが文章を細かく区切ってカウントするときの単位です。Muse WonderをAPIで使う料金は使った量に応じた従量課金で、日本はMetaの利用禁止地域に含まれていません。
APIは100万トークンあたり入力4ドル・出力20ドル
Muse WonderのAPIは入力4ドル(約634円)・出力20ドル(約3,169円)で、キャッシュ入力は0.20ドル(約31.7円)です。キャッシュ入力の料金は、一度送信したプロンプトの共通部分を使い回すときに適用されます。入力が長くなっても単価は上昇しません。
ウェブ検索を使うと、1,000回あたり2.50ドル(約396円)が別にかかります。利用の上限は、1チームあたり毎分3,000リクエスト・400万トークンです。
API料金の比較(100万トークンあたり・ドル)
Muse WonderとClaude Opus 5.5は同じ4ドル(約634円)で、Muse Spark 1.3の3倍強です。
Muse WonderClaude Opus 5.5Muse Spark 1.3出力も20ドル(約3,169円)でOpus 5.5と同額で、Muse Spark 1.3と比較すると5倍近い単価です。
Muse WonderClaude Opus 5.5Muse Spark 1.3Anthropicが公表しているClaude Opus 5.5のAPI料金も入力4ドル(約634円)・出力20ドル(約3,169円)で、1トークンあたりの単価はまったく同じです。CNBCの報道によると、ワン氏はAPIの価格をOpenAIやAnthropicの主力モデルより「十分低く」すると述べていたとのこと。少なくともOpus 5.5に対しては、この発言どおりの価格にはなっていません。
Muse Codeの契約では、入力した内容をMetaのモデル学習に使う「Contributor mode」が最初から有効になっています。その代わりに利用できる量が増加する仕組みで、設定からいつでも切り替えられます。仕事のコードを入力するなら、契約した直後にこの設定を確認しておくのがおすすめです。
API側にもContributor modeで単価が大きく低下する仕組みがありますが、Wonderは対象外で、標準の料金だけになります。Muse Spark 1.3ならこの仕組みで入力0.10ドル(約15.8円)・出力0.20ドル(約31.7円)まで低下するので、用途によっては旧モデルと使い分けるのも一つの方法です。
In Muse Code, subscriptions default to Contributor mode, and you can turn it on or off in settings / Muse Wonder Model: muse-wonder-1.0 . Usage Standard mode (per 1M tokens) Contributor mode (per 1M tokens) Cached input $0.20 Not available Input $4.00 Not available Output $20.00 Not available / No long-context premium : you pay the same rate whether your context window is mostly empty or almost full. / Web search grounding : $2.50 per 1,000 search queries , in addition to the request's token cost. — 料金ページの Contributor mode の説明、Muse Wonder の料金表、Token pricing notes より公式情報を見る →
日本は利用禁止地域に含まれるのか?
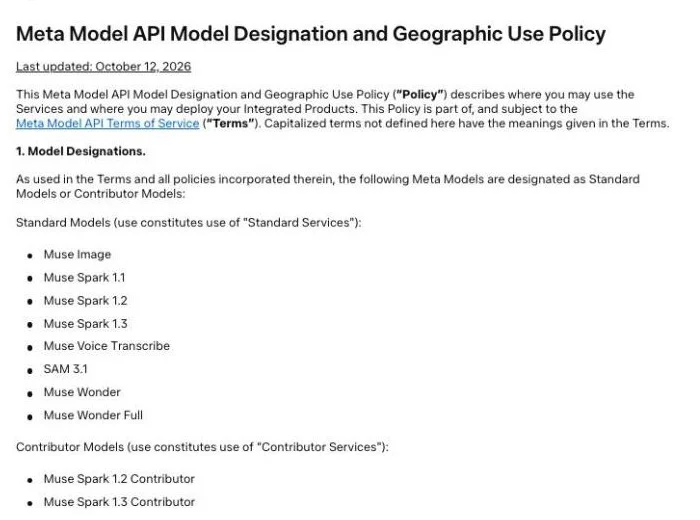
Meta Model APIの地域利用ポリシーは10月12日に更新され、Muse WonderとFullが対象モデルに加わりました。利用を禁じる地域は中国・ロシア・北朝鮮など21の国と地域で、日本は含まれていません。
ただし同じポリシーは、Metaが国や地域ごとにいつでも提供を開始したり停止したりできるとしています。Muse Codeの特典や提供状況も地域によって異なり、契約前の申し込み画面で確認できます。日本から実際に利用できるかどうかは、ご自身のアカウントで確認するのが確実です。
Metaはモデルカードで、事前学習に含まれる言語のすべてで評価を実施したわけではないとしています。評価表にも日本語の性能を評価する試験は無いので、日本語の文書を処理する業務に使う前に、ご自身の環境で試しておくといいでしょう。
2.1 General Availability . The Services are not available in all jurisdictions. Meta controls where the Services are available through technical and other means, and may enable or restrict access in any jurisdiction at any time in its sole discretion. / 3. Restricted Territories. You may not access the Services from, and you may not make Integrated Products available to or knowingly permit access by End Users located in, any of the following territories ( "Restricted Territories" ): Afghanistan Belarus Cambodia People's Republic of China (including Hong Kong SAR and Macau SAR) Cuba Eritrea Ethiopia Haiti Iran Iraq Libya Myanmar Nicaragua North Korea Pakistan Russia Somalia Syria The Crimea, Donetsk, and Luhansk regions of Ukraine Venezuela Western Sahara — 地域利用ポリシーの 2.1 General Availability と 3. Restricted Territories より公式情報を見る →
FAQ
- Muse WonderとMuse Wonder Fullの違いは何ですか?
- Fullは上位版です。第三者のArtificial Analysisが出した総合指標では、Fullの56に対してWonderは52でした。WonderはMeta Model APIとMuse Codeで利用することができ、FullはMuse CodeのPower UsageかMaximum Usageの契約者だけが利用できます。APIからFullを呼び出すことはできません。
- 日本からMuse Wonderは使えますか?
- Meta Model APIの地域利用ポリシーが定める利用禁止地域21か所に、日本は含まれていません。ただしMetaは国や地域ごとに提供を開始したり停止したりできるとしており、Muse Codeの提供状況も地域によって異なります。実際に利用できるかどうかは、ご自身のアカウントで確認する必要があります。
- Muse WonderはChatGPTやClaudeより性能が高いのですか?
- 分野によって異なります。Metaの評価表では、法律の作業や長時間のソフト開発でFullが他社のモデルを上回りました。一方で、ゼロからのプログラム作成や医療ではClaude Opus 5.5が上です。第三者の総合指標ではOpus 5.5が58で1位となり、続いてFullが56、OpenAIのGPT-6 Astraが53、Wonderが52でした。
関連する記事
 AmazonCEO、外部AIによる代理購入体験は「まだ便利とは言えない」Amazonのアンディ・ジャシーCEOは10月29日の決算説明会で、外部のAIエージェントによる代理購入はまだ少なく、広告事業への影響はないと説明しました。9月にMetaのAIエージェント「Muse」を遮断したAmazonは、自社のAlexa for Shoppingを買い物の中心に据えるとしています。
 MetaのStyle Sketchとは?手持ちの服からAIがコーデを提案するアプリMetaはAIファッションアプリ「Style Sketch」を、インドネシア・シンガポール・タイで公開しました。Instagramの投稿写真などから手持ちの服を登録すると、AIがその服でコーデを組みます。体型と肌の色に合わせたモデルでバーチャル試着もできます。11月2日時点で、日本のApp Storeではまだ配信されていません。
 Meta Museは友人・家族の人物ページを毎時更新、プロンプトで判明MetaのAIエージェント「Muse」のシステムプロンプトには、家族・友人・同僚の一人ひとりに人物ページを作り、1時間ごとに情報を集める指示があります。研究者が抽出した中身とMetaの説明に加え、記憶を消す方法もまとめています。
 Meta Muse Codeとは?中断しても続きから再開できるコーディングAI2026年8月5日にベータ公開されたMeta Muse Codeは、ターミナル型のコーディングエージェントです。搭載モデルMuse Spark 1.2、クラッシュ後も再開できるイベントログ設計、/plan・/grill・/goalの3スキルを備え、計画の段階から承認のゲートが入る設計です。