コンテキストウィンドウとは、AIが一度に読み込む情報量の上限
コンテキストウィンドウ(コンテキスト長)とはAIモデルが1回のやり取りで読み込める情報量の上限を指し、大きさはトークンという単位で表します。ここでいうAIとは、ChatGPTやClaudeやGeminiの中で実際に回答を作っているモデル(AIの本体)のことです。
コンテキストウィンドウの基本
| 観点 | 内容 |
|---|---|
| 呼び方 | コンテキストウィンドウ・コンテキスト長(context window) |
| 意味 | AIが1回の回答を作るときに参照する情報量の上限 |
| 単位 | トークン(文章を細かく区切った単位) |
| 例え | 作業用の記憶・短期記憶 |
| 学習データとの関係 | 別物。学習で覚えた知識はコンテキストウィンドウに含まれない |
学習データとは別に働く作業用の記憶
コンテキストウィンドウは、AIが学習で身につけた知識とは別のものです。AIは大量の文章を学習して作られますが、その学習データが毎回コンテキストウィンドウに読み込まれているわけではありません。
Anthropicはコンテキストウィンドウをモデルの「作業用の記憶(working memory)」と位置づけ、Googleは人の短期記憶に例えています。人が一度に覚えておく量に限りがあるように、AIが1回の回答で参照する量にも上限があるのです。
大きさの単位は文字数ではなくトークン
コンテキストウィンドウの大きさは、文字数ではなくトークンという単位で表します。トークンとは、AIモデルが文章を処理する時の最小単位のことで、1つの単語が1トークンになることもあれば、複数のトークンになることもあります。
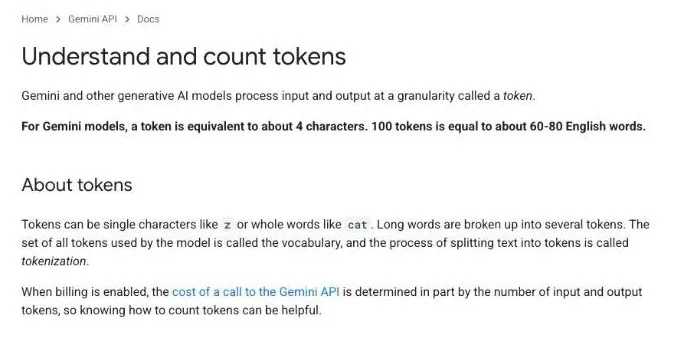
1トークンの文字数はモデルによって異なります。Googleの説明では、Geminiの1トークンはおよそ4文字で、100トークンは英語でおよそ60〜80語です。
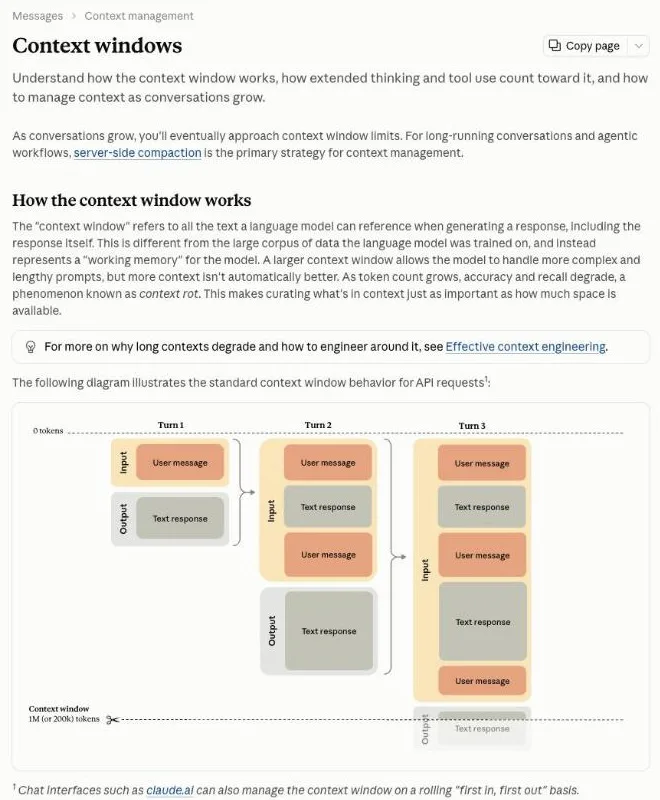
The "context window" refers to all the text a language model can reference when generating a response, including the response itself. This is different from the large corpus of data the language model was trained on, and instead represents a "working memory" for the model.(How the context window works)— Anthropic より公式情報を見る →
For Gemini models, a token is equivalent to about 4 characters. 100 tokens is equal to about 60-80 English words.(About tokens)— Google より公式情報を見る →
プロンプトだけでなくAIの回答までトークン数に含まれる
コンテキストウィンドウの中身は、ユーザーが打ち込んだプロンプトだけではありません。システムプロンプトや会話履歴に加えて、添付した資料やAIが出力する回答までトークン数に含まれます。内訳は次のとおりです。
コンテキストウィンドウに含まれるもの
| 含まれるもの | 例 |
|---|---|
| システムプロンプト | サービス側がAIに最初に与えているプロンプト |
| 会話履歴 | それまでのプロンプトとAIの回答 |
| 添付した資料 | 画像・PDF・文書 |
| ツールの結果 | 検索やプログラムの実行結果 |
| 今回のプロンプト | ユーザーがいま打ち込んだ文章 |
| AIの回答 | AIが出力する回答と、考えている途中の文章 |
システムプロンプトや添付資料、AIの回答もカウントされる
Anthropicの説明では、コンテキストウィンドウにカウントされるものは次の4つです。ユーザーが打ち込んだプロンプトのほかにも、画面に出ないものがトークンを使っています。
- システムプロンプト
- メッセージ(ツールの結果・画像・文書を含む)
- ツールの定義
- AIが出力する回答(回答の前に考える「拡張思考」の文章を含む)
コーディング用のAIツールであるClaude Codeは、短いプロンプトでも最初に多くのトークンを送信します。その内訳は「Claude Codeの起動トークン3.3万の内訳と、節約できる設定」で実測しています。
会話を継続すると履歴がたまり、上限に近づく
会話を継続すると、プロンプトとAIの回答がやり取りのたびにコンテキストウィンドウの中へたまっていきます。2回目のプロンプトでは1回目のやり取りが、3回目のプロンプトでは1回目と2回目のやり取りが、まとめて読み込まれることになります。
それまでのやり取りはそのまま残るため、会話が長くなるほどコンテキストウィンドウの空きは少なくなります。1回のやり取りが短くても、何十回も続ければ上限に近づきます。
Everything in the request counts toward the context window: the system prompt, every message in messages (including tool results, images, and documents), and your tool definitions. The output Claude generates for the turn, including its extended thinking, counts too./As the conversation advances through turns, each user message and assistant response accumulates within the context window, and previous turns are preserved completely.(How the context window works)— Anthropic より公式情報を見る →
上限を超えたときの動作はチャットとAPIで異なる
コンテキストウィンドウの上限を超えたときにどうなるかは、AIをどこから使っているかによって変わります。ChatGPTやClaudeのようなチャット画面と、プログラムからAIを呼び出すAPIとでは、動作が異なります。
上限を超えたときの主な動作
| 使い方 | 動作・対処 |
|---|---|
| チャット画面(claude.aiなど) | 古いやり取りから順に押し出されることがある |
| API(入力だけで上限を超えた) | 「prompt is too long」のエラーになる |
| API(回答の途中で上限に達した) | 回答がそこで止まる |
| 長い会話を継続したいとき | 前半を自動で要約する圧縮(compaction)を使う |
チャットでは古いやり取りから順に押し出される
claude.aiのようなチャット画面では、古いやり取りから順にコンテキストウィンドウの外へ押し出されることがあります。したがって、上限に達すると新しいやり取りが加わるたびに、いちばん古い部分から外へ出ていく仕組みです。
コンテキストウィンドウの外へ出たやり取りは、AIが参照できなくなります。会話が長くなると最初に伝えた条件をAIが忘れたように感じるのは、このためです。大事な条件は、ときどき伝え直しておきましょう。
APIでは上限を超えるとエラーで止まる
プログラムからAIを呼び出す窓口のAPIでは、上限を超えると処理が止まります。AnthropicのAPIでは、入力だけで上限を超えた場合、どのモデルでも「prompt is too long」というエラーになります。
回答を出力している途中で上限に達した場合は、Claude 4.5以降のモデルなら回答がそこで止まります。APIはチャット画面とは異なり古い部分を自動で削除しないため、開発者は送信する前にトークン数を確認しておく必要があります。
長い会話は自動の要約(圧縮)で続けられる
上限に近づいた長い会話は、前半を自動で要約して短くする「圧縮(compaction)」で続けることができます。AnthropicのAPIでは、サーバー側で前半の会話を要約に置き換え、上限を超えても会話が途切れないようにしています。
要約された部分は、元のやり取りの細かい言い回しまでは残りません。正確に覚えておいてほしい数字や条件は、要約に任せずに新しいプロンプトで改めて書いておくといいでしょう。
Chat interfaces such as claude.ai can also manage the context window on a rolling "first in, first out" basis./If the input alone already exceeds the model's context window, the API returns a 400 invalid_request_error ("prompt is too long") on every model./Compaction automatically summarizes earlier parts of the conversation on the server, so the conversation can continue past the context window limit.(How the context window works・Manage context with compaction)— Anthropic より公式情報を見る →
コンテキスト長は8,000トークンから100万トークンへ拡大
AIのコンテキスト長は、ここ数年で大きく拡大しました。Googleによると、初期の生成モデルが一度に処理できたのは8,000トークンだけだったとのこと。今では、100万トークンを読み込めるモデルが当たり前になっています。
コンテキスト長の拡大(Googleの説明による)
初期の生成モデルからGeminiまで。出典: Google「Long context」。
 Gemini
は100万トークンを入力できた最初のモデル
Googleは、100万トークンを入力できる最初のモデルがGeminiだとしています。それまでの上限は8,000トークンから3万2,000トークン、12万8,000トークンへと段階的に拡大してきました。
Googleによると、コンテキストウィンドウが小さいモデルでは古いメッセージを捨てたり内容を要約したりといった工夫が必要になることが多いとのこと。100万トークンあれば、多くの資料を分割せずにまとめて入力できます。
Claudeの最新モデルは100万トークンに対応
2026年10月時点で、Claude Opus 5.5やClaude Sonnet 5.5などのClaudeの最新モデルは、100万トークンのコンテキストウィンドウを持っています。ただし、Claude Sonnet 4.5など一部のモデルは20万トークンです。
同じ会社のAIでも、モデルや使い方によって上限は異なります。各モデルの最新値は、各社が公開しているモデル一覧で確認するのが確実です。OpenAIが提供するCodexのように、製品側でコンテキスト長を制限している例もあります。
100万トークンはコード5万行、英語の小説8冊ほど
Googleの換算では、100万トークンは1行80文字のコードなら5万行、平均的な長さの英語小説なら8冊ほどに相当します。ただし、この換算は英語での目安です。日本語の文章が何トークンになるかはモデルによって異なるため、日本語ではこの数値のとおりにはなりません。
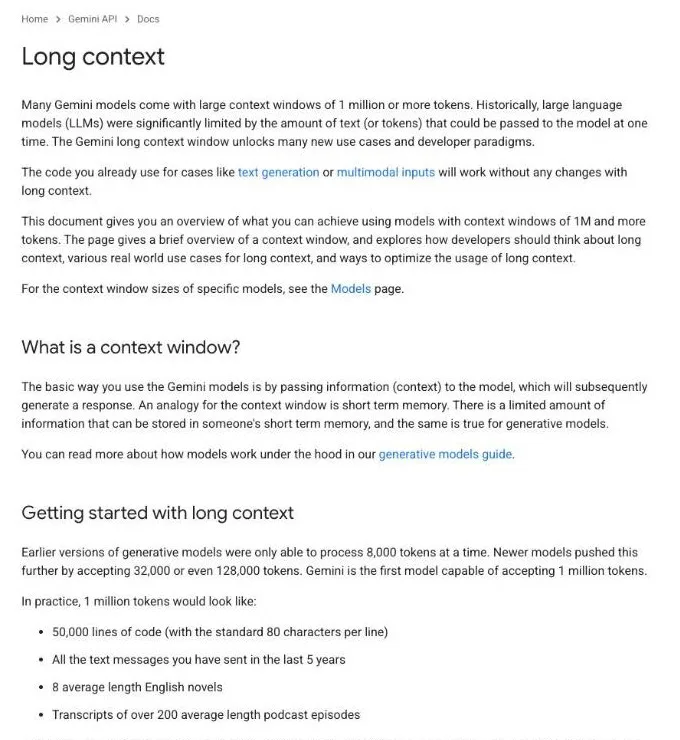
Earlier versions of generative models were only able to process 8,000 tokens at a time. Newer models pushed this further by accepting 32,000 or even 128,000 tokens. Gemini is the first model capable of accepting 1 million tokens./50,000 lines of code (with the standard 80 characters per line)/8 average length English novels(What is a context window?)— Google より公式情報を見る →
Other Claude models, including Claude Sonnet 4.5 (deprecated), have a 200k-token context window.(Context window sizes by model)— Anthropic より公式情報を見る →
コンテキストウィンドウは大きければよいとは限らない
コンテキストウィンドウが大きいほど長い資料を読み込めますが、たくさん入れるほど回答が良くなるわけではありません。入れる量が増加すると回答の正確さが低下し、資料の中ほどにある情報は読み落とされやすくなります。
長い資料を読ませるときの課題と対策
| 発生しやすいこと | 対策 |
|---|---|
| 入れる量が増加するほど正確さが低下する | 必要な情報だけを入れる |
| 資料の中ほどにある情報を読み落とす | 大事な情報は先頭か末尾に置く |
| 聞きたいことが資料に埋もれる | 聞きたいことはプロンプトの最後に書く |
読み込ませる量が多いほど回答の正確さは落ちる
Anthropicによると、トークン数が増加するほど回答の正確さと、入れた内容を思い出す力が落ちるとのこと。この現象は「context rot(コンテキストの劣化)」と呼ばれています。
何を入れるかは、コンテキストウィンドウの大きさと同じくらい大切です。関係のない資料まで丸ごと貼り付けると、本当に読んでほしい部分が読み落とされることがあります。
長い資料は中ほどが読み落とされやすい
AIは長い資料の先頭と末尾にある情報はよく使う一方で、中ほどにある情報になると回答の精度が大きく低下します。2023年にLiuらが論文「Lost in the Middle(中ほどで迷子になる)」で報告した傾向で、複数の文書から回答を探す課題などで確認されています。
長い文脈向けに作られたモデルでも、同じ傾向が出たと報告されています。大事な条件や数字は資料の真ん中に埋もれさせず、先頭か末尾に書いておくのが安全です。
必要な部分だけを読み込ませ、聞きたいことは最後に書く
長い資料を読ませるときは必要な部分だけを入れ、聞きたいことはプロンプトの最後に書くと回答が良くなります。実際に、Googleは文脈が長いときは聞きたいことを資料の後ろ、プロンプトの最後に置くと多くの場合で性能が向上するとしています。
たとえば50ページの報告書を要約させるなら、関係する章だけを貼り、その下に「この報告書の要点を3つ書いてください」と書きます。何をどの順で入れるかを設計する考え方は、コンテキストエンジニアリングと呼ばれています。Anthropicが公開した具体的なルールは「コンテキストエンジニアリングでClaude Codeの指示を80%削減」にまとめました。
A larger context window allows the model to handle more complex and lengthy prompts, but more context isn't automatically better. As token count grows, accuracy and recall degrade, a phenomenon known as context rot.(How the context window works)— Anthropic より公式情報を見る →
In particular, we observe that performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts, even for explicitly long-context models.(Abstract)— arXiv より公式情報を見る →
In most cases, especially if the total context is long, the model's performance will be better if you put your query / question at the end of the prompt (after all the other context).(Where is the best place to put my query in the context window?)— Google より公式情報を見る →
まとめ:コンテキストウィンドウはAIが読み込む量の上限
コンテキストウィンドウ(コンテキスト長)は、AIが1回の回答を作るときに読み込む情報量の上限で、単位はトークンです。また、ユーザーのプロンプトだけでなくシステムプロンプトや会話履歴、添付資料やAIの回答までトークン数に含まれ、上限を超えると古いやり取りが押し出されるかエラーで止まります。
Claudeの最新モデルは100万トークンまで読み込めるようになりましたが、たくさん入れるほど回答の正確さは低下し、長い資料の中ほどは読み落とされやすくなります。必要な情報だけを入れて聞きたいことはプロンプトの最後に書けば、大きなコンテキストウィンドウを無駄なく使うことができます。
FAQ
- コンテキスト長とコンテキストウィンドウの違いは?
- 同じものを指す呼び方です。どちらも、AIが回答を作るときに参照する情報量の上限を表します。sakutto.aiの用語集でも、コンテキスト長をコンテキストウィンドウの別名として登録しています。
- 100万トークンは日本語で何文字?
- 定まった換算はありません。1トークンの文字数はモデルごとに異なり、日本語の目安も各社とも公表していません。英語なら、Geminiの1トークンはおよそ4文字です。
- AIが前の話を忘れるのはなぜ?
- 会話が長くなってコンテキストウィンドウが埋まると、チャット画面は古いやり取りから順に押し出すことがあるためです。押し出された部分はAIが参照できなくなるので、最初に伝えた条件を忘れたような回答になります。
関連する記事
 生成AI3つを料金で比較、ChatGPTやClaudeなどの公式プランChatGPT・Claude・Geminiの生成AI比較を、公式ページに出ている料金だけで整理します。無料プランで十分な範囲と有料に切り替える目安をまとめ、用途別のおすすめの選び方も解説します。一度に読み込める文章量は3社で示し方が異なるため、数字を横に並べても比較になりません。
 AIファクトチェックは一次情報と照合、裏付け可能な統計は4割AIファクトチェックで統計を見るときは、出典ページが引用した一次情報との照合が必要です。ChatGPTやPerplexity、GoogleのAIによる概要など5つのAIが出した統計1,285件をTrakkrが一次情報と照合した分析では、裏付け可能だったのは40%でした。出典ページの多くは数字の転載だけで、複数のAIで回答が一致しても裏付けにはなりません。
 Claudeのスプレッドシートでの使い方、ドキュメントやスライドも編集Claude for Google Workspaceは、Googleスプレッドシート・ドキュメント・スライドの横でClaudeがファイルを直接編集するアドオンです。2026年10月6日に有料プラン向けにベータ公開されました。導入方法とアプリ別にできることに加え、編集モードと制限・データ保護をまとめています。
 Claude Codeの起動トークン3.3万の内訳と、節約できる設定Systimaの実測ではClaude Codeは短いプロンプトでも約3.3万トークンを送信し、うち約2.4万は27個のツール定義でした。CLAUDE.mdとMCPサーバーを足すと7.5万〜8.5万に増えます。総消費は1回の量×リクエスト回数なので、減らすなら使わないMCPと長いCLAUDE.mdから見直します。