Decision-1とは?Microsoftの判断特化モデル
Microsoft-Decision-1(以下Decision-1)は、Microsoftが2026年10月9日に公開した、判断だけを行うAIモデルです。Office of the CTOのバイスプレジデントAchint Srivastava氏が、開発者向けブログ「Command Line」で発表しました。 また、Microsoft FoundryとOpenRouterで使うことができます。
判断特化モデルは文章でなく何を出力するのか
判断特化モデル(意思決定モデル)は、判断の材料になる入力と回答の選択肢を受け取って、選択肢ごとの確率を出力するAIです。ChatGPTのような生成AIが返事の文章を作るのに対し、Decision-1が出力するのは「この問い合わせを技術担当へ回すべき確率」のような数値だけです。プログラムはその数値を見て、次の処理を分岐できます。 Microsoftが想定している用途は次の5つです。
- 処理の振り分け(ルーティング)
- 分類
- 優先順位づけ
- 検証
- ワークフローの制御
Decision-1は、はい/いいえ・多肢選択・段階評価の問いに対応しています。AIの回答やエージェントの次の行動を、評価基準(ルーブリック)に沿って採点することもできます。
Decision-1が出力する確率は、実際に正解する割合と合うように調整(較正)されています。確率をそのまま自信の度合いとして使うことができます。一定の値を超えたものは自動で処理し、それ以外は人が調べる工程に回す、といった運用です。
Decision-1のベースはどのモデルか
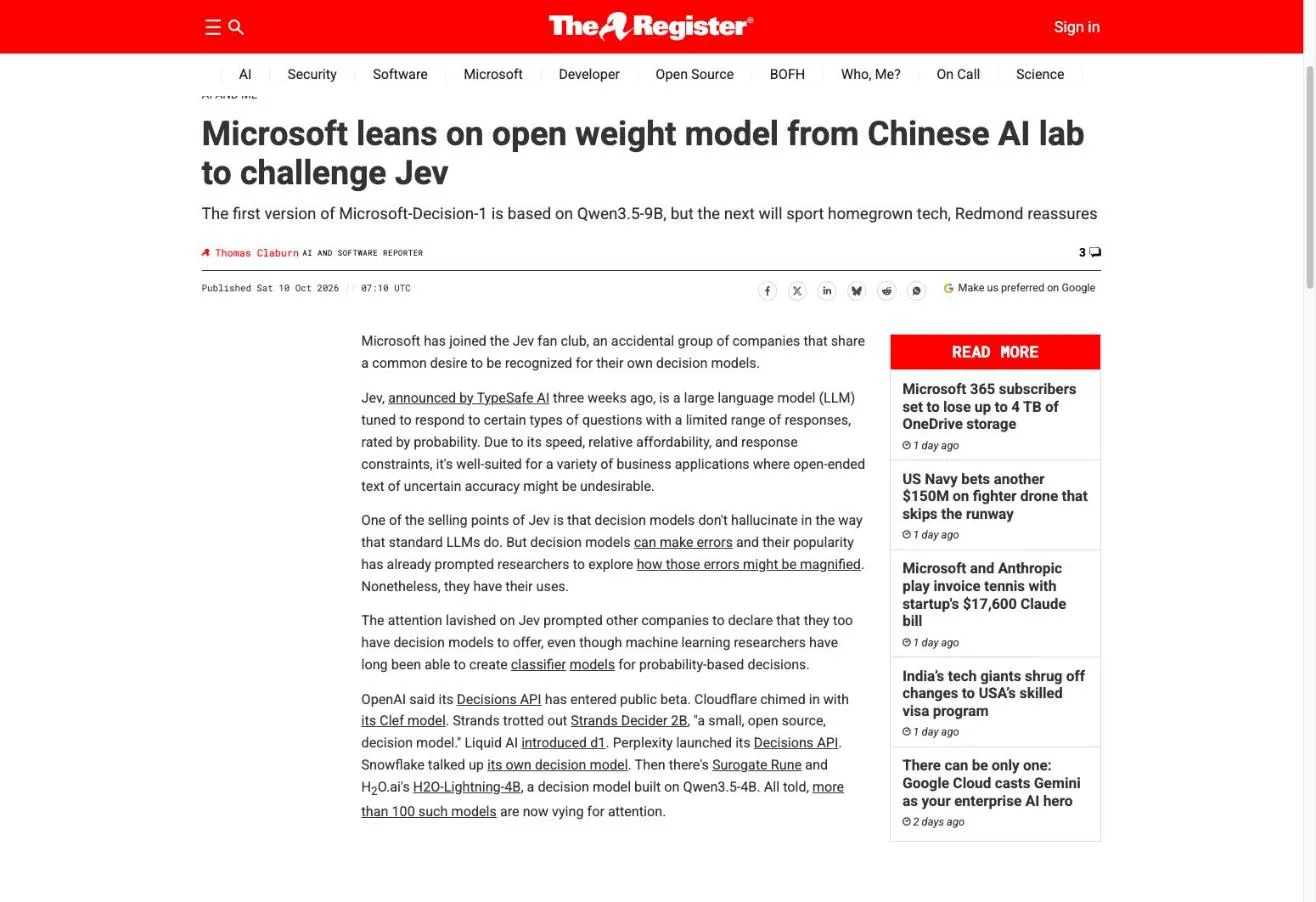
Decision-1はMicrosoftの自社モデルではなく、AlibabaのQwen3.5-9Bを追加学習したモデルです。公開済みのモデルに追加の学習をして、1回の処理で判断のスコアを出せるようにしています。
Qwenは、Alibaba Cloud(中国Alibabaのクラウド部門)が開発しているモデル群です。Microsoftは今後、ベースを自社のMicrosoft AI(MAI)やOpenAIが作ったモデルへ入れ替える予定だとしていますが、理由は明かしていません。
判断特化モデルでは、TypeSafe AIのJevが先行し、Decision-1は後発です。 同種のモデルはOpenAIやCloudflareなども公開し、10月10日の時点で100を超えました。
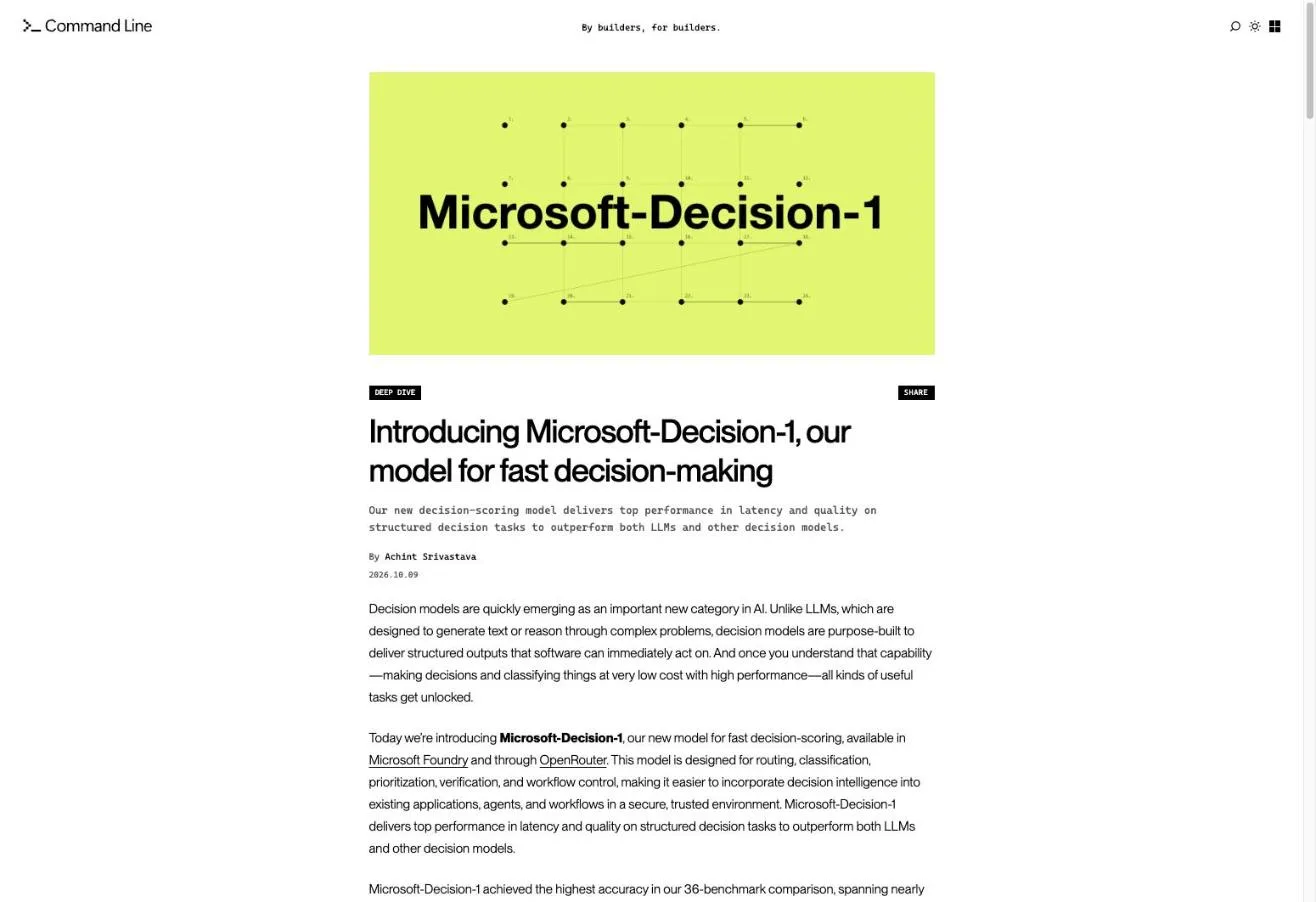
To build Microsoft-Decision-1, we post trained Qwen3.5-9B for fast, single-pass decision scoring and will soon rebase it on other models, including Microsoft AI (MAI) and OpenAI. When given a fixed set of answer options, Microsoft-Decision-1 provides a calibrated probability score for each option. The model supports yes/no, multiple-choice, and rating options, as well as rubric-based grading of AI responses and agent actions, all through a simple structured API call. — Microsoft-Decision-1の仕組みを説明した節より公式情報を見る →
The Qwen model family is developed by Alibaba Cloud, the cloud computing arm of Chinese tech giant Alibaba. Microsoft, for reasons not disclosed, said it will soon rebase the Decision-1 on its models and those from OpenAI. — Qwenをベースにした点と載せ替えの予定に関する記述より公式情報を見る →
Decision-1が出力する3種類の判断
Decision-1へのリクエストは、判断の材料になるstate(テキストかJSON)と、stateについての問い1つ以上で組み立てます。問いごとに型を指定し、型によって出力される回答の種類が変わります。
Decision-1の問いの型(Microsoft Learnによる)
| 型 | 何を聞くか | 出力されるもの |
|---|---|---|
| noul | 正しいかどうか | 0〜1の確率 |
| choice | どれに該当するか | 選んだ1つと、選択肢ごとの確率 |
| score | どの程度か | 段階の値と、段階ごとの確率 |
真偽はnoul・分類はchoice・採点はscore
3つの型は、判断の目的に合わせて使い分けます。それぞれの主な用途は次のとおりです。
- noul: 条件を満たすかの判定やふるい分け
- choice: 担当への振り分け
- score: 重要度の評価や順位づけ
scoreが出力する値は、段階の番号を確率で重み付けした平均です。4段階なら0〜3の範囲になり、段階と段階の間の値も出力されます。
同じstateへの問いは、1回のリクエストにまとめて送信できます。Microsoft Learnの例では、1件の問い合わせについて、どのチームへ回すか・4段階でどの程度深刻か・過去に問い合わせがあったかを一度に聞いています。
{
  "model": "<deployment-name>",
  "state": { "message": "Checkout is down again. This is my third request.", "customer_contact_count": 3 },
  "questions": {
    "team": { "type": "choice", "instructions": "Which team should handle this request?",
      "criteria": { "billing": "Charges, invoices, and refunds", "engineering": "Bugs, errors, and outages", "support": "How-to and account questions" } },
    "severity": { "type": "score", "instructions": "How severe is this issue?", "criteria": ["Cosmetic", "Minor", "Major", "Critical"] },
    "repeat_contact": { "type": "noul", "instructions": "Has the customer contacted support before?" }
  }
}
回答は問いにつけた名前(例のteamやseverity)ごとに出力されるので、文章を解析する処理は必要ありません。Learnによると、関連する問いをまとめると呼び出しの回数が減り、すべての回答が同じ内容から判断されるとのこと。
文章が必要な処理は生成AIと組み合わせる
Decision-1は下書き・要約・説明ができないので、文章が必要な処理はこれまでどおり生成AIに任せます。Microsoftは2つを組み合わせる使い方も紹介しています。まずDecision-1で指示を振り分けたり止めたりして、通ったものだけを生成AIへ送信する流れです。
Decision-1を単体で使った試験でも、費用はGPT-6 Solを大きく下回りました。MicrosoftのXbox Researchは、プレイヤーの自由記述1万件超を定めたテーマに分類する試験を行いました。GPT-6 Solと同程度の品質のまま、14倍以上の速さ、1/200の費用で処理できたとしています。
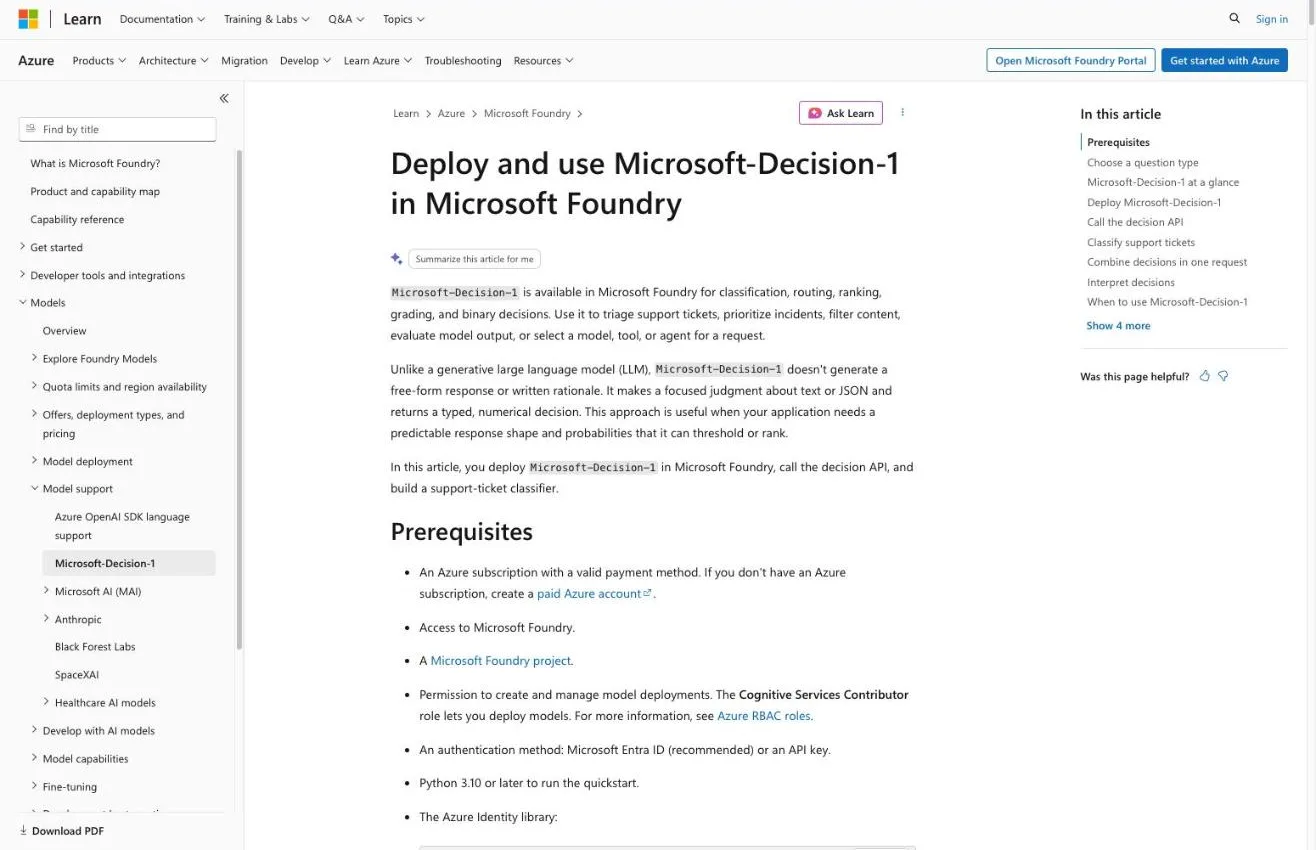
Unlike a generative large language model (LLM), Microsoft-Decision-1 doesn't generate a free-form response or written rationale. It makes a focused judgment about text or JSON and returns a typed, numerical decision. / Use a generative LLM instead when the application needs to create, summarize, rewrite, or explain content. You can also combine the two approaches. Use Microsoft-Decision-1 to route or gate a request, and then send approved requests to a generative model. — 冒頭の説明と、Microsoft-Decision-1を使う場面についての節より公式情報を見る →
Jevとの比較、精度と速度はMicrosoft計測でトップ
Decision-1の料金はJevとまったく同じで、Microsoftの計測では精度と速度でJevを上回り、較正ではJevを下回りました。ここで取り上げる数値は、すべてMicrosoftの発表ブログに掲載されている値です。
料金はJevと同じ入力100万トークン0.042ドル
料金は入力100万トークンあたり0.042ドル(約6.65円)で、出力トークンは無料です。Jevと料金がまったく同じなので、Microsoftが差として打ち出しているのは精度と速度です。
Microsoftは大型の汎用モデルとの費用の差も金額で公表しています。100万件を分類した場合の費用は、GPT-6 Solの約2,434ドル(約38万5,200円)に対してDecision-1は約11ドル(約1,741円)という推計です。
36ベンチマークで精度トップ、較正はJevのほうが高い
学習に使っていない36のベンチマーク・147,137問で比較した平均精度は、Decision-1が83.5%で最も高く、Jev 1.13.0は82.3%でした。上位3モデルの差は2ポイント未満なので、精度だけで見ればリードはわずかです。
36ベンチマークの平均精度(Microsoftの計測)
棒の高さは精度(0〜100)。Strands-Decider 2B(54.8%、36本中23本の平均)は省略。出典: Microsoft Command Line。
 Decision-1
 Jev 1.13.0
 GPT-6 Luna Decisions
差がはっきり開くのは速度です。Microsoftが比較に使ったのは応答時間の中央値(p50)で、半分の応答がその時間内に終わる値です。
応答時間の中央値・短いほど速い(Microsoftの計測)
棒の高さは掲載した中で最も遅いdeck-31Bの400ミリ秒を100とした比。GPT-6 Solの3,010ミリ秒は目盛りの外のため省略。出典: Microsoft Command Line。
Decision-1Jev 1.13.0GPT-6 Luna DecisionsDecision-1は2位のH2O-Lightning-4Bより2.5倍、GPT-6 Solより35倍速いことになります。Microsoftは、判断1回につき100ミリ秒遅いだけでも、20回続けば全体で2秒の遅れになるとしています。
較正だけは、Decision-1がトップではありません。較正スコアは、モデルが出す確信度と実際の正答率がどれだけ一致しているかを表す指標で、完全に一致すると100になります。
較正スコア(Microsoftの計測)
| モデル | 較正スコア |
|---|---|
| Jev 1.13.0 | 93.7 |
| Quyet-1.0-Large | 93.1 |
| Microsoft-Decision-1 | 92.2 |
| Surogate Rune 26B-A4B | 91.8 |
| H2O-Lightning-4B | 91.8 |
| GPT-6 Luna Decisions | 89.9 |
| deck-31B | 83.5 |
ブログには、Jevの精度と較正の数値を公開後に追記したという但し書きがあります。追記前のバージョンでは、Decision-1の較正はQuyetに次ぐ2位でした。Jevを含めた今の表では3位です。
Microsoftは、言い方を変更しても判断がぶれないかも調べました。同じ指示を8通りに言い換えたり並べ替えたりしたところ、判断が変わったのは平均1.3%でした。選択肢の説明を言い換えた場合と、選択肢を逆順やシャッフルにした場合は、一度も変わらなかったとしています。
Microsoft-Decision-1 achieved the highest accuracy in our 36-benchmark comparison, spanning nearly 150,000 questions across benchmarks kept blind from training. And in our benchmarking, it was the fastest measured: 2.5 times quicker than H2O-Lightning-4B v1.1, the runner-up, and 35 times quicker than GPT-6 Sol. / Editor’s note: This post was updated from the original to add benchmarks for Jev on accuracy and calibration. / Microsoft-Decision-1 changes its decision on 1.3% of perturbations on average with zero flips when option descriptions are paraphrased or when options are reversed or shuffled. — 冒頭の要約、編集注、判断の安定性についての節より公式情報を見る →
Microsoftの公表値と第三者計測で、なぜ差が出たのか
公開の翌日に発表された第三者の計測では、応答時間の中央値がMicrosoftの公表値の5倍を超えました。ただし計測の方法が異なるため、どちらかが間違っているとは言えません。
85ミリ秒はFoundryの同じリージョンでの自社計測
Decision-1の85ミリ秒は、MicrosoftがFoundryを同じリージョンから呼び出して測った値です。一方、比較した他のモデルの応答時間には、10月7日に確認したJevBench v1.6.1の調整済み中央値を使っています。85ミリ秒とJevの240ミリ秒は、同じ環境で並べて測った数値ではありません。
Microsoftは、p95(応答の95%が収まる時間)が125ミリ秒だったことも公表しています。p95なら中央値には表れない遅い応答がわかるので、判断を何段も重ねる処理ではp95も比較しておくといいでしょう。
JevBenchの中央値459ミリ秒、総合はAPI部門6位
判断特化モデルを独自に分析しているBenchmark HeavenのJevBenchは、10月10日にDecision-1をAPI部門へ追加しました。Azure Foundryに直接送信した非公開問題1,200件と公開問題300件で評価し、速度を測る124リクエストでは応答時間の中央値が459ミリ秒でした。
総合スコア(Composite A)は69.11で、API部門27件中6位です。判断力(Capability)は70.78、較正は84.40でした。総合スコアは判断力・較正・速度・料金を同じ重みで合わせたJevBench独自の指標なので、正答率とは別の数字です。
更新履歴には、注意点が2つ書かれています。1つは、文脈長の上限を超えて失敗した21件を、誤答として分母に入れたままであること、もう1つは、他のモデルは以前に測った日の値のままで、今回あわせて測り直してはいないことです。
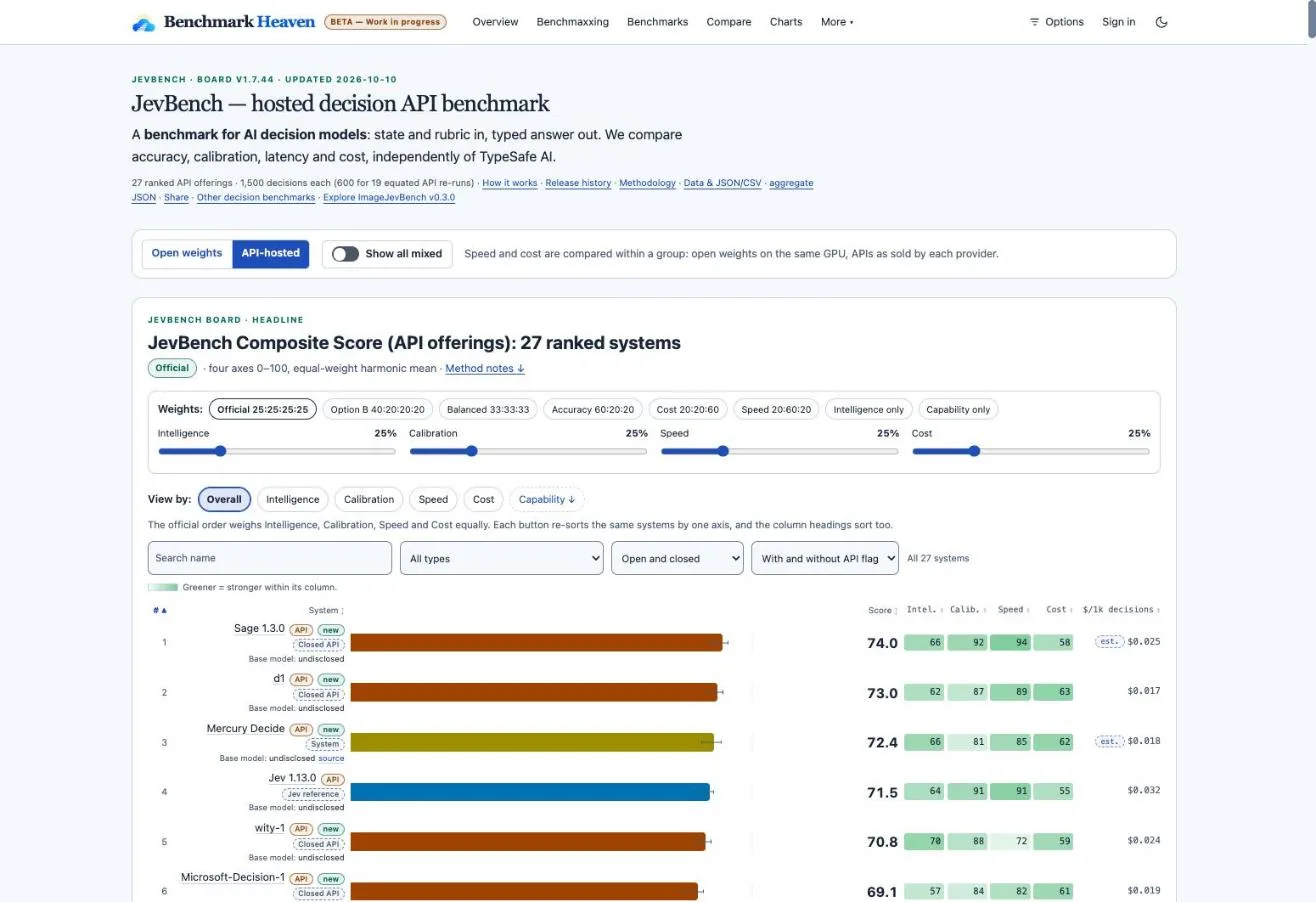
v1.7.31 (2026-10-10): Microsoft-Decision-1 joins the hosted API board after a native Azure Foundry measurement on 1,200 sealed plus 300 public observations: Capability 70.78, Calibration 84.40 and Composite A 69.11. Its 21 context-limit failures remain in the scored denominator. Native median latency is 459 ms on the 124-request speed subset. — 更新履歴のv1.7.31の項目より公式情報を見る →
FoundryとOpenRouterでの使い方
Decision-1はご自身のFoundryプロジェクトにデプロイして使うほか、OpenRouterでも同じ料金で呼び出せます。ただし、Foundryで使うには次の3つが必要です。
- 支払い方法を登録したAzureサブスクリプション
- Foundryプロジェクト
- デプロイの権限として、Cognitive Services Contributorロール
Foundryでデプロイし、systemoneのAPIを呼ぶ
デプロイしたら、Foundryリソースの/providers/microsoft/v1/systemoneへリクエストをPOSTで送信し、modelにはモデル名ではなくデプロイ名を入れます。認証には、Learnが推奨するMicrosoft Entra IDか、APIキーのどちらかを使います。
デプロイの種類は、GlobalStandardと、一部のリージョンだけで使うことができるDataZoneStandardの2つです。OpenRouterのモデルページでは、入力はテキストのみで、文脈長は32,768トークンです。
長い文書は、stateに入れる前に短くしておく必要があります。 Learnのページには、自社のラベル付きデータで精度と応答時間の中央値を測るPythonのサンプルが掲載されています。
人に関わる重い判断はDecision-1だけで決めない
Microsoft Learnでは、信用・雇用・住宅・医療・法務など人に関わる重い判断で、Decision-1を唯一の決定者にしないよう勧めています。判断を伴う処理には、人が確認する工程を残してください。
Learnに書かれている制約は、ほかにもあります。問いや選択肢の書き方・順序でスコアが変わること、較正の精度が高いのは見慣れた種類のタスクであること、Decision-1は回答の理由を出さないことの3つです。対策としてLearnでは、誤検知と見逃しのそれぞれのコストから自動処理のしきい値を決め、「判断できない」のような保留の選択肢を用意するよう勧めています。
The request's model value is your deployment name, not the underlying model name. / Wording sensitivity: Scores can change based on how you phrase or order questions and options. Poorly framed questions still return scores. / For consequential decisions about people, such as decisions involving credit, employment, housing, healthcare, or legal matters, use the model for decision support with meaningful human review. Don't use it as the sole decision-maker. — 判断APIの呼び出し方と、既知の制約についての節より公式情報を見る →
Microsoft-Decision-1 has a 32,768 token context window. — モデルページのよくある質問より公式情報を見る →
Microsoft Decision-1のポイントまとめ
Decision-1は、Jevと同じ料金・同じ問いの型で使うことができる判断特化モデルです。精度と速度でトップという結果はMicrosoftの自社計測で、第三者のJevBenchでは応答時間にも順位にも差が出ています。
- すでにAzureやFoundryを使っている: Decision-1なら今のアカウントの中で呼び出せる
- 自動処理の基準にする確率の正確さを最優先したい: Microsoftの比較でも較正はJevが上
- 速度が重要な処理: Microsoftは85ミリ秒、JevBenchは459ミリ秒と測っているので、Decision-1とJevの両方をご自身の環境で測る
Decision-1もJevも入力100万トークンあたり0.042ドル(約6.65円)なので、正解がわかっている自社のデータを少しずつ流して比較しても、費用はほとんどかかりません。精度と応答時間を計測してから、本番環境でどちらを使うかを判断してください。
FAQ
- Microsoft Decision-1の料金はいくらですか?
- 入力100万トークンあたり0.042ドル(約6.65円)で、出力は無料です。TypeSafeのJevと同じ料金で、OpenRouterでも同じ金額です。
- Decision-1に要約や判断の理由を書かせることはできますか?
- できません。出力するのは確率・選んだ選択肢・スコアといった数値だけです。要約や説明が必要な処理には生成AIを使うよう、Microsoftは推奨しています。Decision-1で振り分けてから生成AIへ入力する連携もできます。
- Decision-1にはどのくらいの長さの文章を入力できますか?
- OpenRouterで使える文脈長(一度に入力できる長さ)は、32,768トークンです。入力はテキストのみで、画像には対応していません。
関連する記事
 意思決定AIのTypeSafe AIが評価額75億ドルで8.7億ドル調達意思決定モデルJevを開発するTypeSafe AIが、評価額75億ドル(約1兆1,870億円)で8億7,000万ドル(約1,377億円)を調達しました。a16zが主導したシリーズAで、Jevの公開から24日後です。10月14日公開のJev 1.14では、画像入力などを本番非推奨の実験的機能として使うことができます。数値の多くは自社計測です。
 Cloudflare Clefとは?Jevとの違いと未検証のベンチマークCloudflareが公開した意思決定モデルClefは、Jev互換のAPIで画像や動画も判定でき、料金はJevの約6倍です。軽量版Clef-flashもあり、Workers AIで呼び出せます。7指標でトップというベンチマークの結果はCloudflareの自己申告で、第三者による検証はまだです。
 北朝鮮の攻撃グループが偽求人やマルウェア開発にAIを悪用、Microsoftが分析Microsoftは2026年10月29日、北朝鮮の8グループによるAI利用を4段階に分類し、Jade Sleetなど3グループが作戦全体にAIを組み込んだと報告しました。AIは偽の求人文や履歴書のほか、おとりのPDFやマルウェア開発にも使われますが、作戦は今も人が指示しています。会社は採用相手の身元を、社員は届いた求人とコードを疑うことが備えになります。
 Microsoftが全従業員の約27%、約6万人を対象に希望退職を募集Microsoftは10月26日、米国・カナダ・英国・インドのレベル70以下の社員を対象に、期間限定の希望退職制度を導入しました。CNBCによれば対象は約6万人で全従業員の約27%を占め、応じた社員は12月31日付で退職となるとのこと。Microsoftは10月28日の決算説明会で、希望退職にかかるコストを10〜12月期の業績見通しに織り込みました。