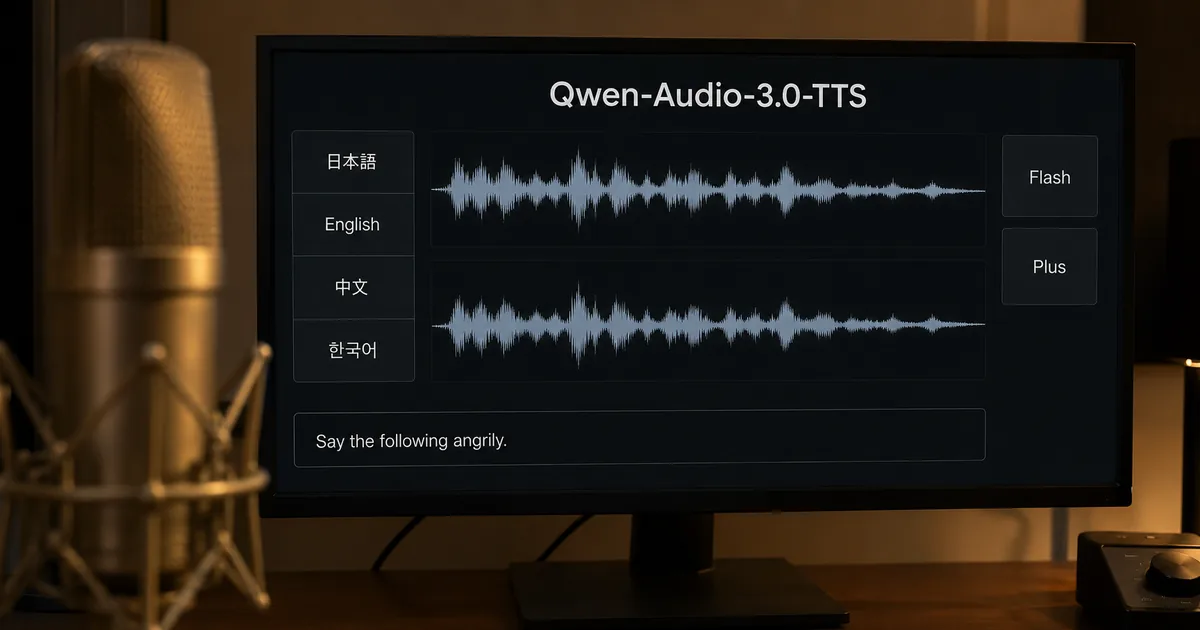
Qwen-Audio-3.0-TTSは日本語に対応した音声合成API
Qwen-Audio-3.0-TTSの基本情報(公式値)
Qwen-Audio-3.0-TTSは、日本語を含む16言語の文章を読み上げる音声合成モデルで、名前のTTSはtext-to-speech(文字を音声に変換する技術)の略です。また、Alibaba CloudのModel StudioからAPIを呼び出して使うことができます。
APIは外部のプログラムから機能を呼び出す窓口のことです。ご自身のパソコンにモデルをインストールするのではなく、お使いのプログラムから、クラウドにあるモデルへ文章を送信し、生成された音声を受け取る使い方になります。
Alibaba傘下のTongyi Labが2026年7月20日に公開
Qwen-Audio-3.0-TTSを公開したのはTongyi Labで、発表は2026年7月20日です。 Tongyi LabはAlibaba Group傘下のAI研究機関で、大規模言語モデルのQwenシリーズを手がけるチームでもあるとのこと。今回のモデルはQwenの名前を持つ音声合成の最新版にあたり、同じ系統からFlashとPlusの2種類が出ています。
発表によれば、このバージョンでは実際に組み込んだ開発者がつまずきやすい課題を重点的に改善しています。取り組んだのは次の4つです。
- 対応言語を広げた
- 話し方を普通の文章で指示できるようにした
- タグで細かく制御できるようにした
- 参照に使う録音の状態が悪くても崩れにくくした
"Qwen-Audio-3.0-TTS is our latest text-to-speech model release. It ships as two variants from the same lineage:" / "This release focuses on four things developers actually run into in production: broader language coverage, natural-language style control, fine-grained tag control, and robustness when the reference audio isn’t clean." — Tongyi Lab 公式ブログ 冒頭部より(原文で離れた位置にある2箇所を「/」で区切って引用)公式情報を見る →
"We’re Tongyi Lab — the AI research institute under Alibaba Group, and the team behind Qwen, Wan, Tongyi Fun, and a growing ecosystem of models and frameworks loved by millions of developers worldwide." — Tongyi Lab 公式ブログ About ページより公式情報を見る →
低遅延のFlashと音声品質を優先するPlusの違いは?
Flashは最初の音が出力されるまでの遅延を300ミリ秒前後に抑えた対話向けで、Plusは速さより声の自然さと元の声への忠実さを優先した高音質向けです。 2つは同じ系統のモデルで、用途に合わせて選び分けます。
| 観点 | Flash | Plus |
|---|---|---|
| 調整の方向 | リアルタイムのやり取り | 高音質の生成 |
| 最初の音までの遅延 | 300ミリ秒前後 | 公表されていない |
| WER/CERの平均(低いほど良い) | 3.87 | 3.96 |
| 話者類似度の平均(高いほど良い) | 80.44 | 82.75 |
| Model Studioのシステムボイス | 12種 | 2種 |
| 1万文字あたりの単価(シンガポール) | 0.15ドル(約24.6円) | 0.2ドル(約32.8円) |
ユーザーが話しかけて返事を待つ音声アシスタントのような使い方ならFlash、収録済みの原稿をナレーションとして読ませる使い方ならPlusが適しています(上の性格づけから編集部が判断した選び方で、公式の記載ではありません)。Plusの遅延は公式に数字が無いので、対話に使うならご自身の環境で計測する必要があります。
"Flash: tuned for real-time interaction, with a first-packet latency at 300ms-level. Plus: tuned for high-quality generation, where naturalness and timbre fidelity matter more than speed." — Tongyi Lab 公式ブログ 冒頭部より公式情報を見る →
Qwen3-TTSはオープンソースで配布される別モデル
名前の似たQwen3-TTSはQwen-Audio-3.0-TTSとは別物で、重みを公開したオープンソースのモデル群です。 重み(学習済みモデル本体のデータ)がApache-2.0ライセンスで公開されているので、Qwen3-TTSはご自身の環境にダウンロードして動作させることができますが、Qwen-Audio-3.0-TTSはModel Studio経由のAPIでしか利用できません。
検索では両方が「Qwen TTS」とまとめて呼ばれやすく、Hugging Faceやローカル実行の手順を探すと、16言語のQwen-Audio-3.0-TTSではなく日本語を含む10言語に対応したQwen3-TTSの情報が見つかります。ご自身のサーバーで動作させたいか、クラウドのAPIを使いたいかを先に定めておけば、どちらを調べればよいかで迷いません。
Qwenの言語モデル側でも、重みを公開するモデルとクラウド専用モデルという2系統があります。オープンウェイトとは重みを公開したモデルのこと。Qwen3.8にも、オープンウェイト版とクラウド専用のMaxが用意されています。
"Qwen3-TTS is an open-source series of TTS models developed by the Qwen team at Alibaba Cloud, supporting stable, expressive, and streaming speech generation, free-form voice design, and vivid voice cloning." — Qwen3-TTS 公式リポジトリの概要(About)より公式情報を見る →
"Qwen3-TTS covers 10 major languages (Chinese, English, Japanese, Korean, German, French, Russian, Portuguese, Spanish, and Italian) as well as multiple dialectal voice profiles to meet global application needs." — Qwen3-TTS のモデルカード冒頭の概要より公式情報を見る →
日本語のシステムボイスは無く、音声クローンで用意
日本語で読ませる声の選択肢
Qwen-Audio-3.0-TTSで日本語を読ませるなら、Model Studioが用意したシステムボイスではなく、ベース音声か音声クローンで作った声を使う前提で考えます。 公式のボイス一覧に日本語向けの声が掲載されておらず、選んだ声が対応していない言語の文章を読ませると発音の誤りや不自然な読み上げが起こりうると公式ドキュメントは書いているためです。
デフォルトのシステムボイスは中国語と英語の14種だけ
2026年8月26日更新のModel Studioのボイス一覧に掲載されたシステムボイスはPlus向け2種とFlash向け12種の計14種で、日本語に対応する声はありません。 14種のうち11種が中国語(普通話)と英語の両方、他の3種が英語だけに対応しています。
発表ブログは16の対応言語にわたるプリセット音声のライブラリを同梱したと書いており、一覧の中身とは記載が一致しません。一覧にはシステムボイスとは別のベース音声もあり、音声クローンで作り置きされた声がPlusとFlashにそれぞれ500種超あるとModel Studioの一覧に記載されています。
ベース音声の詳細はExcelにまとまっていて、日本語の声がいくつあるかもそこで確認できます。まずこのExcelで日本語に対応した声があるかを確かめ、見つからなければ音声クローンへ進むのが手堅い進め方です。
"Qwen-Audio-TTS supports the following system voices. In addition to system voices, pre-generated base voices created through voice cloning are also available." / "The text to be synthesized must be in a language supported by the selected voice. Otherwise, pronunciation errors or unnatural speech may occur." / "In addition to the system voices above, qwen-audio-3.0-tts-plus and qwen-audio-3.0-tts-flash each provide over 500 base voices generated through voice cloning." — Alibaba Cloud Model Studio「Qwen-Audio-TTS voice list」より(2026年8月26日更新・原文で離れた位置にある3箇所を「/」で区切って引用)公式情報を見る →
"A curated preset voice library spanning 16 supported languages, so you can ship a voice without cloning one first." — Tongyi Lab 公式ブログ「Also In This Release」節より公式情報を見る →
クローンは録音のノイズや残響を除去して声を再現
音声クローンは参照音声と呼ぶ短い録音から声色を写し取り、その声で文章を読み上げさせる機能です。 Qwen-Audio-TTSの音声クローンは参照音声に日本語を使うことができるため日本語話者の録音から日本語を読む声を用意でき、声は1つのアカウントにつき1,000件まで無料で作ることができます。
Tongyi Labによると、録音に混じる雑音や部屋の残響を抑える処理をクローンの仕組みに組み込んだとのこと。雑音や残響の多い録音で従来版と比較したところ、同じ録音からでも明らかにきれいな声が出たと発表ブログにあります。
一方でModel Studioのドキュメントでは、参照音声に背景音の無い明瞭な発話が5秒以上続く録音が必要とされています。雑音に強くなったという発表があっても、元になる録音は静かな場所で録るのが前提です。
他人の声で読み上げを作る場合は本人から同意を取り、合成した音声であることを聞き手に伝える運用を先に定めておくべきだと編集部は考えます。声を再現する精度が向上するほど、なりすましの電話やフェイク音声のメッセージに悪用される危険も高まりますが、公式の発表は悪用の危険に触れていません。
"Reference clips from the real world are rarely studio-clean. Qwen-Audio-3.0-TTS was trained with targeted acoustic simulation so speech enhancement is built into the cloning path. The model suppresses reverb and noise while preserving timbre." / "In our high-noise and high-reverb tests, this release produced noticeably cleaner output than previous versions from the same degraded references." — Tongyi Lab 公式ブログ「More Robust Voice Cloning From Imperfect Audio」節より公式情報を見る →
"English, Japanese, Korean, Russian, French, German, Portuguese, Thai, Indonesian, Vietnamese, Spanish, Italian, Malaysian, Filipino, and Arabic" / "The audio must contain at least 5 seconds of continuous, clear speech (no background sound)." / "Each Alibaba Cloud Model Studio account can create up to 1,000 custom voices for Qwen-Audio-TTS / Qwen-Audio-Realtime / CosyVoice" / "Voice creation is free." — Alibaba Cloud Model Studio「Voice cloning」の参照音声の要件・上限・料金の各項より(原文で離れた位置にある4箇所を「/」で区切って引用)公式情報を見る →
話し方の感情は自然文とタグで指示でき、息づかいも入れられる
話し方は「次の文を怒った調子で読んで」といった普通の文章で指示でき、息づかいや笑いは読み上げる文にタグを入れて差し込みます。 Tongyi Labによると、音響パラメータを手で調整しなくても、専門的なタグ付けの知識が無くても、感情・役柄・状況・話す速さを指定できるとのこと。
タグには、[sad]や[angry]といった感情タグと、[gasp]や[giggles]といった効果音タグの2種類があります。感情タグは置いた位置より後ろにある文の調子を切り替えるのに対し、効果音タグはその位置に息をのむ音や笑い声を差し込むだけで、前後の感情には影響しません。
Model Studioのドキュメントによれば、タグを使うことができるのはPlusとFlashの2つで、音声を片方向のストリーミングで受け取るモードに限られます。息づかいや笑いまで作り込みたい場合は、この受け取り方を前提に組み込みます。
"You can describe the delivery you want in natural language instead of hand-tuning acoustic parameters." / "Simple prompts with plain language steer emotion, role, scenario, and pace without any labeling expertise." — Tongyi Lab 公式ブログ「Style Control In Natural Language」節より公式情報を見る →
"Qwen-Audio-TTS series models support embedding emotion and rich language tags directly in the text to synthesize (the text parameter)." / "Rich language tags insert a vocal effect at the current position in the text without affecting the emotional style of surrounding text." — Alibaba Cloud Model Studio「Real-time speech synthesis」の「Emotion and rich language tags」節より公式情報を見る →
品質の数値は自社測定によるもので、第三者のAIランキングでは3位
話者類似度の平均(高いほど元の声に近い)
どちらもTongyi Labの自社測定。比較対象となったシステム名を発表ブログは明かしていない。
Tongyi Labが公表した品質の数値はすべて自社の測定で、第三者のArtificial Analysisでの順位は発表時の1位から2026年9月1日時点の3位へ後退しています。 数値そのものは良好でも比較対象の名前をTongyi Labは明かしていないので、日本語の読み上げに使うかどうかは下の数字を目安にしつつ、ご自身の原稿を実際に読ませてから判断してください。
WERとCERは16言語中10言語で最良、話者類似度はPlusがトップ
Tongyi Labが公表した値では、読み上げの正確さを表すWER/CERが16言語中10言語で最良で、元の声への近さを表す話者類似度はPlusが16言語すべてで1位です。また、WER/CERの平均はFlashが3.87でPlusが3.96となり、どちらも比較した他システムの平均より良い値だったとのこと。 さらに話者類似度の平均はPlusが82.75、Flashが80.44です。
WERは単語の誤り率でCERは文字の誤り率を指し、どちらも生成した音声を書き起こして元の文章とどれだけ異なるかを集計した値です。値が低いほど聞き取りやすい音声だといえます。話者類似度は反対に高いほど良い指標で、生成した音声が参照音声の声色をどこまで保てたかを表します。
比較対象になった「他のシステム」がどれなのかを、発表ブログは明らかにしていません。特定の他社製品より優れているかどうかは、この数字だけでは判断できません。
"Qwen-Audio-3.0-TTS family demonstrates the strongest overall multilingual intelligibility, achieving the best WER/CER in 10 of 16 languages. Flash delivers the lowest average WER/CER at 3.87, while Plus remains highly competitive at 3.96, both outperforming the other systems on average." / "Plus ranks first across all 16 languages with an average SS of 82.75, while Flash follows at 80.44, demonstrating strong and robust voice-preservation quality across diverse languages." — Tongyi Lab 公式ブログ「Multilingual Coverage Across 16 Languages」節より公式情報を見る →
PlusはArtificial Analysisのブラインド比較で3位
第三者の評価サイトArtificial Analysisでは、2026年9月1日時点でQwen-Audio-3.0-TTS-PlusのEloは1,240で、全体の3位です。 1位はCartesiaのSonic 3.6(1,282)、2位はSpeechifyAIのSimba 3.2(1,241)で、Plusと2位の差は1点にとどまります。Plusの順位幅も2〜3位と表示されています。
Tongyi Labは2026年7月20日の発表で、PlusがArtificial Analysisで1位だとしていました。この順位は同じ文を読んだ2つの音声をユーザーが聞き比べ、自然だと感じた方に投票するブラインドテストの結果をEloという対戦成績の点数に換算して定まるとのこと。他の会社が新しいモデルを出すたびに入れ替わるので、「1位」という紹介は発表時点の値として受け取るのが正確です。
Artificial Analysisの順位には言語別の内訳がありません。日本語を読ませたときの聞こえ方は、この順位とは別にご自身で聞いてチェックする必要があります。
"Qwen-Audio-3.0-TTS-Plus currently ranks #1 on Artificial Analysis, the independent third-party TTS leaderboard." — Tongyi Lab 公式ブログ 冒頭部より(2026年7月20日公開)公式情報を見る →
"The top Text to Speech models by Elo rating are: 1. Sonic 3.6 (Elo 1282), 2. Simba 3.2 (Elo 1241), 3. Qwen-Audio-3.0-TTS-Plus (Elo 1240)" / "Models are ranked using an Elo rating system derived from user votes in blind comparisons in the Speech Arena." — Artificial Analysis「Provider Voice Arena Leaderboard」より(2026年9月1日閲覧)公式情報を見る →
API料金は1万文字あたりPlusが0.2ドル、Flashが0.15ドル
Qwen-Audio-3.0-TTSの料金(入力1万文字あたり)
Qwen-Audio-3.0-TTSの料金は、読ませる文章の文字数に応じた従量課金です。 できた音声の長さには課金されません。
2026年9月1日時点で、シンガポール・リージョン(サーバーを置く地域)の単価は、1万文字あたりPlusが0.2ドル(約32.8円)、Flashが0.15ドル(約24.6円)です。中国(北京)のリージョンではPlusが0.19253ドル(約31.5円)、Flashが0.137521ドル(約22.5円)です。
提供はModel StudioのAPIだけです。料金はまだ発表されておらず、発表されたかどうかはModel Studioの料金ページで確かめられます。
"Billing rules: Fees are charged based on the number of characters in the input text. Output is not billed." — Alibaba Cloud Model Studio「Model pricing」の Qwen-Audio-TTS の項より(2026年9月1日閲覧)公式情報を見る →
漢字は1字を2文字に換算するため日本語の原稿は割高になる
Model Studioの読み上げ料金では漢字1字を2文字に換算し、かなや英数字・記号・空白は1字を1文字としてカウントします。 日本語の漢字もこの換算の対象なので、漢字が多い原稿ほど、課金される文字数が見た目の字数を上回る仕組みです。
漢字だけで書いた原稿1万字は課金の上では2万文字として計算されます。シンガポールの単価で計算するとPlusで0.4ドル(約65.5円)、Flashで0.3ドル(約49.1円)です。
しかし実際の原稿はかなと漢字が混ざるので、課金される文字数は見た目の字数に対して1倍から2倍のあいだになります。見積もりの前に原稿の漢字とそれ以外を分けて集計しておくと、請求額のぶれを小さくできます。
"Each Chinese character (including simplified Chinese characters, traditional Chinese characters, Japanese kanji, and Korean hanja) counts as 2 characters." / "Each other character (such as an English letter, a digit, a punctuation mark, a space, a Japanese kana, or a Korean letter) counts as 1 character." — Alibaba Cloud Model Studio「Model pricing」の文字数の数え方より公式情報を見る →
無料枠はシンガポールリージョンだけにあり、90日で切れる
PlusとFlashにはそれぞれ1万文字の無料枠がありますが、使うことができるのはシンガポールのリージョンだけです。 中国(北京)のリージョンに無料枠は無く、シンガポールの無料枠は、Model Studioを有効にした日・モデルの公開日・申請が承認された日のうち最も遅い日から90日間有効です。
漢字だけで書いた原稿の場合、1万文字の無料枠で読ませられるのは5,000字ぶんです。例えば本番用の原稿から漢字が多い段落を選んで無料枠で聞いてみると、読みの正確さと課金の感覚を一度にチェックできます。
"The following models offer a free quota only in Singapore. No free quota is available in other regions." / "Valid for 90 days from the date of Model Studio activation, model release, or application approval, whichever is later" — Alibaba Cloud Model Studio「Model pricing」の Qwen-Audio-TTS の項より公式情報を見る →
48kHzの高音質出力はPlusが対応
Tongyi Labの発表ブログは48kHzでの音声出力を「近日提供」としていましたが、Alibaba Cloudは7月24日の発表でPlusが48kHzの出力に対応したと明らかにしています。 サンプリング周波数は1秒間の音を何回に分けて記録するかを表す値で、大きいほど細かく音を記録できます。放送や動画の制作で48kHzの音声を求められる案件に合うのは、FlashではなくPlusです。
日本語の読み上げに組み込む場合は応答の速さが必要な音声対話にFlash、声の自然さを優先するナレーションにPlusを充て、声はベース音声のExcelで日本語に対応した声を確認して、見つからなければ本人の同意を得た録音から音声クローンで作ります。料金は漢字を2文字に換算する前提で見積もり、まずシンガポールの無料枠でご自身の原稿を読ませて聞いてみるのが最も早い方法です。
生成AIの選び方全般は生成AI3つを料金で比較、ChatGPTやClaudeなどの公式プランでも解説しています。読ませる原稿の字数は次のツールで先に確認できます。
"48 kHz audio output (coming soon)." — Tongyi Lab 公式ブログ「Also In This Release」節より公式情報を見る →
"Among the two versions offered, Qwen-Audio-3.0-TTS-Plus features upgraded 48kHz studio-grade audio output."公式情報を見る →
FAQ
- Qwen-Audio-3.0-TTSは日本語に対応していますか?
- 対応しています。公式の対応16言語に日本語も含まれています。ただし発表ブログには、全言語のサポートは順次展開中という但し書きがあります。
- 日本語の声はどうやって用意しますか?
- 音声クローンで作るのが前提です。Model Studioのボイス一覧(2026年8月26日更新)にあるシステムボイス14種は中国語と英語向けで、日本語に対応する声がありません。音声クローンは参照音声に日本語を使うことができ、声の作成は無料です。
- FlashとPlusはどちらを選べばいいですか?
- 音声アシスタントのように応答の速さが必要ならFlash、ナレーションのように声の自然さを優先するならPlusです。Flashは最初の音が出力されるまでの遅延が300ミリ秒前後で、Plusは速さより自然さと元の声への忠実さを優先しています。
- 料金はいくらですか?
- 読ませる文章の文字数に応じた従量課金で、シンガポールのリージョンでは1万文字あたりPlusが0.2ドル(約32.8円)、Flashが0.15ドル(約24.6円)です。漢字は1字を2文字とカウントするので、漢字だけの原稿1万字ならPlusで0.4ドル(約65.5円)になります。
- Qwen3-TTSと同じものですか?
- 別のモデルです。Qwen3-TTSは重みが公開されたオープンソースのモデル群で、ご自身のPCやサーバーで動作させることができます。Qwen-Audio-3.0-TTSは、Model Studio経由のAPIでしか利用できません。
関連する記事
 Qwenの30億ダウンロードとHugging Faceの公開データとの差Qwenの30億ダウンロードは報道されたAlibabaの数字で、全世界・直近6か月の合計です。Hugging Faceの公開データでは2026年の7か月間にHub上で20.45億回、派生モデルは15万1,448件でした。カウントする期間と範囲が異なるので2つの数字はそのまま比較できません。
 Apple Intelligenceが12月に中国で提供開始、SiriなどでQwenが利用可能にAppleは2026年10月31日、Apple Intelligenceを中国で提供すると発表しました。11月4日に開発者ベータでテストを始め、12月のiOS 27.3で一般のユーザー向けに公開します。アリババのQwenはSiriと作文ツール、ビジュアルインテリジェンスという3つの機能で利用できますが、日本語に対応したSiri AIは中国版に含まれません。
 Qwen3.8が北京へ送信を試みたとCohereが報告、隔離環境で遮断カナダのCohereは10月26日、AlibabaのAIモデル「Qwen3.8-Flash-Next」が検知ルールを書く試験の途中で、北京のサーバーへテスト用の文字列を送信しようとしたと発表しました。通信は隔離環境で止まり、頻度は評価の呼び出し10万回に1回未満です。原因は分かっていません。
 Qwen3.8-27Bの性能と、ローカルで動作させるために必要なVRAMQwen3.8-27Bは、Alibabaが2026年8月に公開した、270億パラメータのオープンウェイトモデルです。Apache 2.0で商用利用でき、4bit量子化なら16〜19GBのメモリで動作します。公式ベンチにはOpus4.6 Maxを上回る結果もありますが、測定条件はモデルごとに異なります。