Playgroundとは?無料のビジョンAI比較ツール
Roboflow Playgroundは、ご自身の画像で複数のモデルを並べて比較する、Roboflow公開の無料ブラウザツールです。 ビジョンAIとは、画像や映像を見て判断するAIの総称のこと。Playgroundに画像を入れると、物体をバウンディングボックスで囲む作業や文字の読み取りを複数のモデルに同時にさせて、出力を並べて見ることができます。
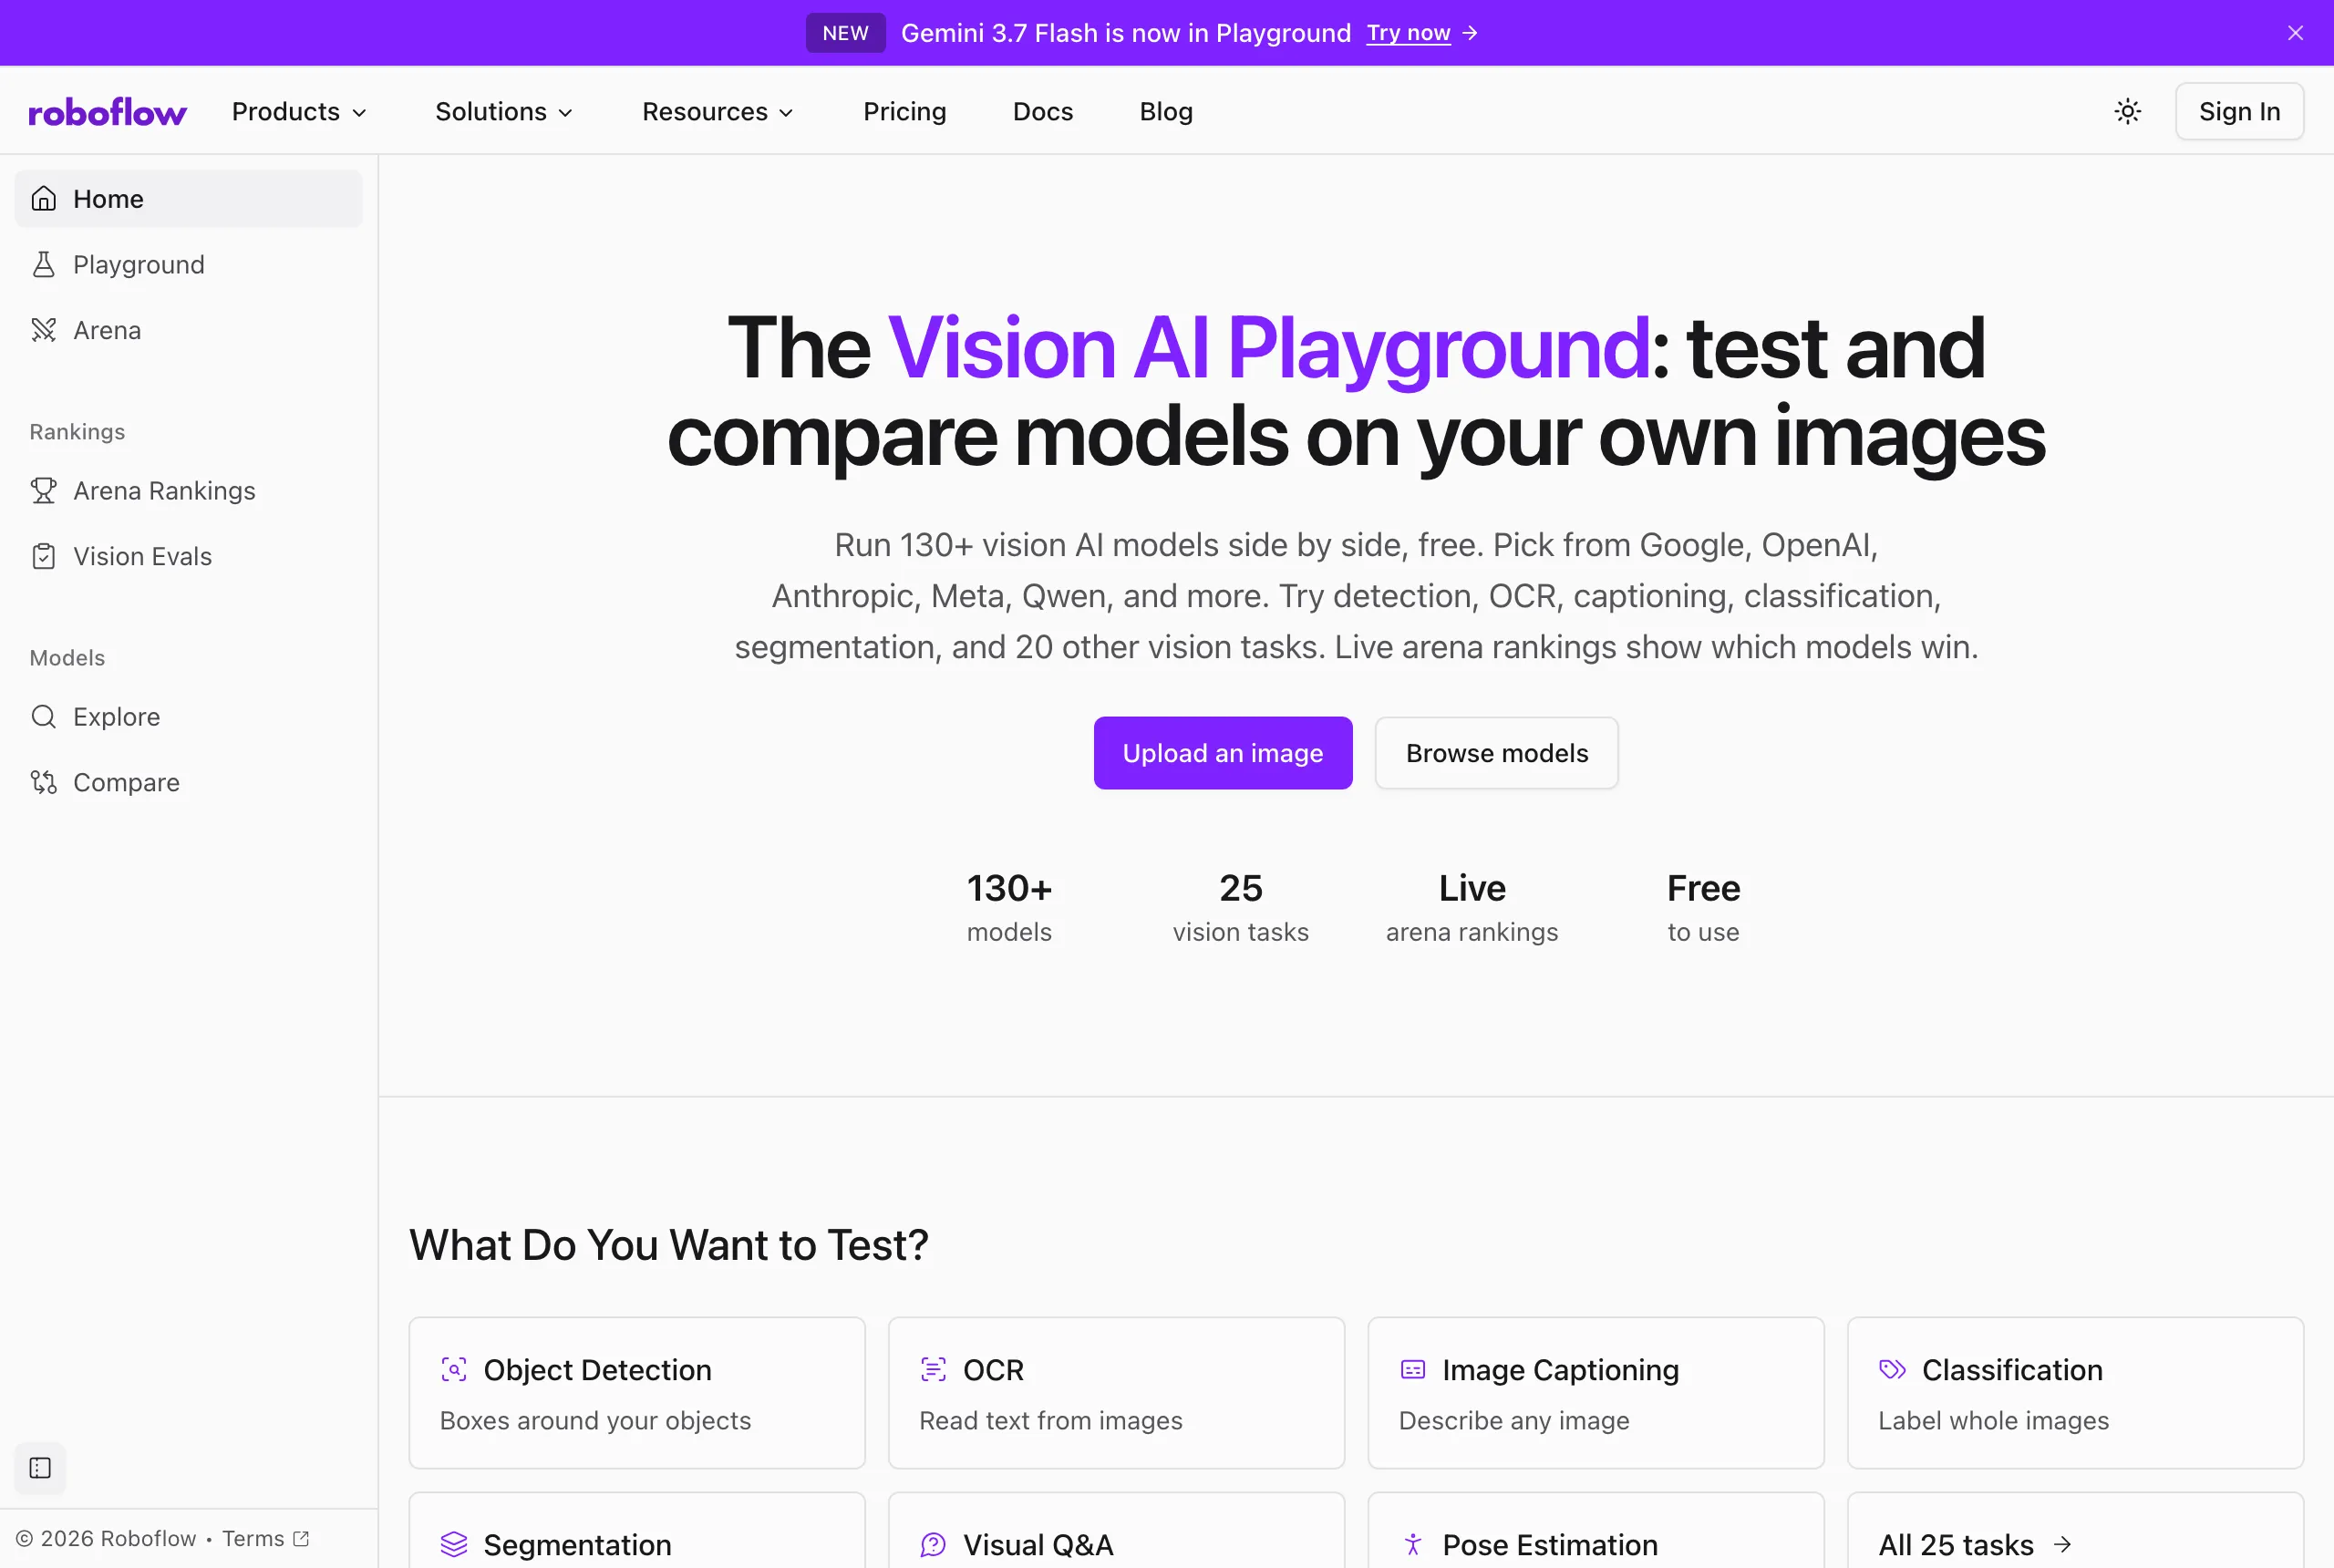
2026年10月11日時点の公式サイトは、140以上のモデル・25のビジョンタスク・ライブのアリーナランキング・無料という4点を掲げています。提供元は、Google・OpenAI・Anthropic・Meta・Qwenなどです。
Roboflow Playgroundの基本情報
| 情報 | 内容 | 出所と日付 |
|---|---|---|
| 提供形態 | ブラウザで動作する無料ツール | 公式サイト(2026-10-11) |
| モデル数 | 140以上(公式ブログは134) | 公式サイト(2026-10-11)/公式ブログ(2026-08-27) |
| タスク数 | 25 | 公式サイト・公式ブログ |
| 同時実行 | 最大4モデル(公式ブログは最大5) | 公式サイト(2026-10-11)/公式ブログ(2026-08-27) |
| 主な提供元 | Google / OpenAI / Anthropic / Meta / Qwenほか | 公式サイト(2026-10-11) |
| 必要なもの | 画像1枚(APIキー・ノートブック・カードは不要) | 公式サイト(2026-10-11) |
| ランキング | アリーナのELO+Vision Evals | 公式サイト(2026-10-11) |
| 本番への接続 | Roboflow Workflows(クラウドかエッジへデプロイ) | 公式サイト(2026-10-11) |
Roboflowの製品は、Playgroundだけではありません。公式ブログのナビゲーションには、Playground以外に次の5つが挙がっています。
- Deploy: デバイス・エッジ・VPC・APIでモデルを動作させる
- Workflows: ローコードでパイプラインとアプリを組む
- Train: 学習の基盤とGPUを提供する
- Annotate: AI支援でラベル付けをする
- Universe: オープンソースのデータセットと学習済みモデルを公開する
Playgroundは、これらの手前でご自身の画像に合うモデルを先に選ぶ入口です。Playgroundで選んだモデルは、Roboflow Workflowsでそのまま動作させることができます。
画像認識AIは140以上でOCRからセグメンテーションまで
タスクは25あり、主なタスクは物体検出・OCR・キャプション生成・分類・セグメンテーションです。 公式サイトのトップに表示されているタスクは次のとおりです。
- 物体検出(Object Detection): 対象をバウンディングボックスで囲む
- OCR: 画像から文字を読み取る
- キャプション生成(Image Captioning): 画像の内容を文章で表す
- 分類(Classification): 画像全体にラベルを割り当てる
- セグメンテーション(Segmentation): ピクセル単位のマスクで対象を切り出す
- 画像Q&A(Visual Q&A): 画像についてプロンプトで問いかける
- 姿勢推定(Pose Estimation): 体のキーポイントを追う
全25タスクの一覧には、深度推定・3D再構成・動画の物体追跡・文書Q&A・画像埋め込みなども含まれます。公式ブログが対応タスクとして掲載しているのは、物体検出・セグメンテーション・キャプション生成・分類・OCR・オープンプロンプトの6つです。
公式サイトのモデル数は140以上で、公式ブログのモデルディレクトリでは134です。公式ブログに掲載されている種類ごとの数は、次の3つです。3つの合計は134を超えますが、公式ブログは種類の重なりに触れていないため、合算はしません。
- オープンソースモデル87: 重みをダウンロードできるモデル。うち37はホスト型のAPI経由でPlayground上で動作し、自社でのホスティングは任意
- 商用API 47: 入力・出力・キャッシュの単価を100万トークンあたりで掲載
- 専用のコンピュータビジョンモデル49: YOLO26やRF-DETRなど、高いフレームレートと本番の精度を狙った単一タスクのモデル
ディレクトリにはオープンソースのQwen3.8 27Bも掲載されています。専用モデルは特定の1つの作業に限定したモデルで、視覚言語モデルは画像を見て言葉で答えるモデルです。
公式ブログは、ゼロショット(追加の学習をしないまま未知の対象に対応する方式)のモデルは比較に手間がかかるという課題を解決するものとして、Playgroundを紹介しています。モデル一覧の表示は、モダリティ(画像・動画などの入力の種類)・提供元・ライセンス・タスクの条件で限定できます。
"Run 140+ vision AI models side by side, free."/"Pick from Google, OpenAI, Anthropic, Meta, Qwen, and more."/"Try detection, OCR, captioning, classification, segmentation, and 20 other vision tasks."/"Browse 140+ vision AI models from every major lab, newest first."/"It covers 25 tasks, such as object detection, OCR, captioning, and segmentation."(トップの見出し文/Model Directory カード/ページ下部の説明文)— Roboflow Playground 公式サイトより公式情報を見る →
"The Model Directory indexes 134 models across 25 vision tasks. You filter by modality, organization, license, or specific task capabilities."/"Thirty-seven run live in Playground via hosted APIs, so self-hosting is optional."/"Universe Open source computer vision datasets and pre-trained models"/"Comparing zero-shot computer vision models can be daunting."(モデルディレクトリの説明/オープンソースモデルの内訳の注記/ナビゲーションの製品一覧/冒頭の課題提起)— Roboflow 公式ブログより公式情報を見る →
ビジョンAIはAPIキー不要、画像1枚から無料で利用可能
Playgroundの利用は無料で、APIキー・ノートブック・クレジットカードのいずれも必要ありません。 社内の商品写真1枚で、どのモデルが対象を正しく囲むかを調べたい場合でも、用意するのはその画像だけです。
画像を1枚上げてタスクを選択し、最大4つのモデルを実行する流れです。数秒後には、各モデルの出力が左右に表示されます。照明の違いや写っている物、判定が難しい状況で各モデルがどう答えるかを、この出力で確認できるとのこと。
試す画像は、実際に使う状況に近いものを選びます。ファイルサイズが大きい画像を事前に小さくしたいときは、ブラウザ上で画像を圧縮するツールをお試しください。
"You don't need an API key, a notebook, or a credit card to find your model. Upload one of your own images, pick your task, and run up to four models on it at once, free. In seconds you see how each one handles your lighting, your objects, and your edge cases, with the outputs side by side."/"Roboflow Playground is a free online tool."(Test Vision AI Models Online for Free 節/ページ下部の説明文)— Roboflow Playground 公式サイトより公式情報を見る →
Playgroundで物体検出を比較する3段階の使い方
比較の手順は、タスク・モデル・画像とプロンプトの順に定める3段階です。 公式ブログの例は、本とコーヒーの画像をアップロードし、指示に「glass mug」(ガラスのマグカップ)と入れて物体検出を実行するものです。以下では、この例に沿って手順を追います。
比較を終えるまでの3段階
| 段階 | 操作 | 定めること・入れるもの |
|---|---|---|
| 1 | タスクを選ぶ | 何を判断させたいか(検出・OCR・分類など25のタスク) |
| 2 | モデルを選ぶ | 比較したいモデルを最大4つ(公式ブログは最大5) |
| 3 | 画像とプロンプトを入れる | ご自身の画像1枚と、検出したい対象の名前やプロンプト |
3段階の区切り方は本記事独自のものです。公式ブログは、サイトにアクセスする・タスクを選ぶ・最大5モデルを選ぶ・画像をアップロードしてプロンプトを設定する、の順に記載しています。
物体検出とOCRではモデルの選択肢が変わる
選択肢に出るモデルは、タスクによって変わります。 公式ブログの例では、物体検出を選ぶとGemini 3.6 FlashとSAM 3がどちらも選択肢に表示されます。画像Q&Aを選んだ場合、SAM 3は対応していないため選択肢に出ません。
納品書の写真から文字を読み取りたい場合は、OCRを選びます。何が写っているかをプロンプトで問いかけたいときは画像Q&Aです。先にタスクを定めておけば、選択肢にはそのタスクに対応するモデルだけが出ます。
"The models available depend on the chosen task type."/"For example, you can use Gemini 3.6 Flash and SAM 3 for object detection because both models support object detection, but you can't use SAM 3 models for VQA because they don't support this task."(What is Roboflow Playground? 節でタスクとモデルの関係を述べた2文)— Roboflow 公式ブログより公式情報を見る →
画像認識AIの無料比較は一度に4モデルまで
並べられるモデルの数は、公式サイトが最大4(2026年10月11日時点)、公式ブログが最大5(2026年8月27日)です。 本記事は、実際に操作する入口である公式サイトの4を採ります。2ページで数字が異なるため、画面で上限を見てから選びます。
別の機能として、Compareがあります。Compareは2〜4モデルのスペックとタスクを並べる機能です。公式ブログによると、コンテキストウィンドウ(一度に読み込める量の上限)・トークン単価・遅延(結果が出力されるまでの時間)・Vision Evalsのスコアを1画面で比較できるとのこと。
実行のたびに、速度とコストの指標が更新されます。公式ブログでは、有料のQwen3.8 Maxと無料のオープンモデルSAM 3を同じ画像で比較しています。
視覚言語モデルの設定ポップオーバー(設定の選択肢を重ねて表示する小窓)では、考える深さ(thinking level)と最大出力トークン数を変更できます。GPT-5.6 Solの出力上限である128,000トークンまで出力させたいときは、スライダーで最大値に設定します。
"run up to four models on it at once, free"/"See specs and tasks for 2 to 4 models, side by side."(Test Vision AI Models Online for Free 節の実行上限/Compare Models カードの説明文)— Roboflow Playground 公式サイトより公式情報を見る →
"You upload an image, pick a vision task, and run up to five models at once."/"Real-time speed and cost metrics update with every run, making it easy to weigh paid options (like Qwen3.8 Max) against free open models (like SAM 3)."/"You can also open the settings popover on vision-language models to adjust the thinking level and maximum output tokens."/"Pick two to four models, and the tool compares their specs, context windows, token pricing, latency, and Vision Evals scores in one view."(実行できるモデル数の記述/速度とコストの指標/設定ポップオーバーの説明/Compare の説明)— Roboflow 公式ブログより公式情報を見る →
VLMで物体検出するときは画像と一緒に検出対象の名前を入れる
VLM(視覚言語モデル)で物体検出するときは、画像と一緒に検出したい対象の名前を言葉で入力します。公式ブログの例では「glass mug」と入れて、本とコーヒーの画像からマグカップを探させています。
実行すると、各モデルのバウンディングボックスとラベルが画像の上に描かれます。 raw JSONに切り替えると、正確な座標も確認できます。
共有URLには、設定・検出する対象の種類(クラス)・結果がそのまま保存されます。URLを受け取った人は、同じ状態から操作することができます。
画像の縦横比やサイズを整えたいときは、画像をリサイズしてからアップロードする方法があります。Playgroundに入力できる画像サイズの上限は公表されていません。
"For object detection, Playground automatically plots the bounding boxes returned by each model."/"If you need to inspect the details, choose the raw JSON option to check exact coordinates."/"It saves your exact setup, classes, and results so anyone can jump right in."(物体検出の結果表示/raw JSON の切り替え/共有URLの説明)— Roboflow 公式ブログより公式情報を見る →
ELOレーティングは人の投票でAIベンチマークは正解と照合
結果を判断する目印は、ご自身の画像で得た出力・アリーナのELO・Vision Evalsの3つです。 ELO(人の投票による順位)とVision Evalsは選択肢を限定するために使い、最終判断はご自身の画像で下します。
結果を判断する3つの目印
| 目印 | 内容 | 判断の根拠 |
|---|---|---|
| ご自身の画像で得た出力 | バウンディングボックス・読み取った文字・説明文などの直接の結果 | 目視で判断 |
| アリーナのELO | ライブで更新されるモデルのランキング | 人の投票 |
| Vision Evals | 定められた画像課題でのスコア | 正解との照合 |
AIモデル比較のELOレーティングは目隠し投票の結果で定まる
ELOレーティングは、モデル名を伏せた目隠し投票の結果から定まります。ELOレーティングとは、対戦の勝ち負けから相対的な強さを数値で表す評価の仕組みのことです。
アリーナモードでは、モデル名を伏せたまま、結果が良かったほうのモデルに投票します。公式ブログによると、Playgroundのクエリ5回に1回が、この目隠しの比較になるとのこと。
目隠しの比較で集めた投票結果は、そのままライブのアリーナランキングに反映されます。公式サイトでは、このランキングを「ライブのELOランキング」と呼んでいます。人の好みのデータを集めた順位なので、正解との照合で付けるVision Evalsの点数とは別の指標です。
"Arena mode allows the user to vote on the best performing model without knowing its identity to remove all bias."/"Every fifth query in Playground runs a blind comparison to gather human preference data."/"This feeds directly into our live arena rankings."(Arena mode の説明3文)— Roboflow 公式ブログより公式情報を見る →
"Live arena rankings show which models win."/"Live ELO rankings and vision evals show how each model scores."(トップの見出し文/ページ下部の説明文)— Roboflow Playground 公式サイトより公式情報を見る →
Vision Evalsは物体検出やOCRなど6タスクで採点
Vision Evalsは、34の視覚言語モデルを正解つきの6タスクで採点する仕組みです(公式ブログ、2026年8月27日時点)。 公式ブログによると、人の投票は有用な判断材料ですが、本番の運用では客観的な正解が欠かせません。
6タスクは、物体検出・カウント・識別・OCR・データ抽出・視覚推論です。スコアは、提供元が新しい重み(学習結果のデータ)を出すたびに自動で更新されます。
採点の方法はタスクごとに異なります。公式ブログに掲載されている採点方法は、次の3通りです。
- 物体検出: mAP@50
- OCR: テキスト類似度
- 残りの4タスク: 完全一致
mAP@50とは、検出したバウンディングボックスが正解のバウンディングボックスと半分以上重なったものを正解とみなして平均した、精度指標のことです。スコアを比較しやすくするため、Vision Evalsは推論努力(モデルがどれだけ考えるか)を低く設定して全モデルを実行し、高く設定したテストもあわせて行います。 Vision Evalsの画面は、次の4区画で構成されています。
- リーダーボード: 34モデルを総合スコアで順位づけし、平均精度・1サンプルあたりの総トークン・推定コスト・平均推論速度を並べる
- スコア対コストの散布図: 左上が、高い精度を低いトークンコストで出せる範囲
- タスク別カード: 6タスクの上位3モデル
- タスク別の表: 全モデルの6タスク分のスコアで、色は75%以上が濃い緑・40〜74%が薄い緑・40%未満が黄色
公式サイトのトップには、総合スコアの上位5モデルが掲載されています。下のグラフは、2026年10月11日時点の上位5モデルの総合スコアです。
Vision Evalsの総合スコア上位5モデル
棒の高さは、公式サイトのトップに掲載されている総合スコア(%)です。2026年10月11日時点の上位5モデルの値です。


上位5モデルには、Gemini 3.7 Flashが入っています。5つのスコアは80.1〜83.4%の範囲に収まっています。順位だけで選ばず、ご自身の画像での出力も確認します。
"Roboflow Vision Evals evaluates 34 frontier vision-language models across six standardized ground-truth tasks: Object Detection, Counting, Identification, OCR, Data Extraction, and Visual Reasoning."/"object detection uses mAP@50, OCR uses text similarity, and the other four tasks use exact match."/"Every model runs at low reasoning effort so scores stay comparable"/"The Vision Evals interface breaks down model performance across four main sections"(Vision Evals 節の評価対象/採点方法/推論の努力量/画面の構成)— Roboflow 公式ブログより公式情報を見る →
"How models score on set image tasks. We add each new model."/"Top models on Vision Evals by overall score"/"GPT-6 Astra 83.4%"/"Claude Opus 5.5 82.0%"/"Gemini 3.5 Flash 81.8%"/"GPT-6.1 Sol 81.7%"/"Gemini 3.7 Flash 80.1%"(Vision Evals カードの説明文/トップの上位5欄の各行)— Roboflow Playground 公式サイトより公式情報を見る →
比較のあとは視覚言語モデルと専用の物体検出モデルを併用
要件が流動的なうちは視覚言語モデルのゼロショットで探り、クラスが固定されて推論量が増えたら専用モデルへ移すのが、公式ブログが述べる進め方です。 クラスとは、見つけたい対象の種類を指します。
専用モデルを使う前に、まず視覚言語モデルで必要な条件を満たすかを検証します。そのうえで、RF-DETRのような専用モデルを、自社の注釈つきデータで学習します。
注釈とはラベル付けのことで、RoboflowにはAI支援のAnnotateという機能があります。公式ブログは、学習した専用モデルなら高速かつ低コストで動作すると述べています。
Roboflow Workflowsでは、視覚言語モデルと専用モデルを1本のパイプラインで連携することができます。コンベア上の欠陥検出の例では、専用の検出器が欠陥部分を見つけて、その周辺を切り出します。視覚言語モデルが読み取るのは、切り出した画像だけです。
できあがったパイプラインは、クラウドAPIかエッジ(現場の機器側)のハードウェアへ、ワンクリックでデプロイできます。モデルの詳細ページでは、ライブデモ・ライセンスの内訳・30日間の利用数を見ることができ、Python・JavaScript・cURLのコードも用意されています。
パイプラインは、Roboflow Agentに文章で指示して作らせることもできます。「detect missing labels on bottles at 30 fps」(瓶のラベルの貼り忘れを1秒30コマで検出)と入力すると、AgentがWorkflowを作って試しに実行し、出たエラーも自動で修正するとのこと。
状況ごとの進め方
| 状況 | 進め方 |
|---|---|
| 汎用モデルで十分だった | Roboflow Workflowsに組み込み、クラウドかエッジにデプロイする |
| 検出のあとに文字を読ませたい | 検出・OCR・視覚言語モデルをWorkflowsの条件分岐で連携する |
| 精度が足りない | 自社の注釈つきデータで、RF-DETRのような専用モデルを学習する |
"Every model here runs in Roboflow Workflows: chain detection, OCR, and VLMs with logic, then deploy to cloud or edge."/"When general models fall short, train a model on your own data."(From playground to production 節の2文)— Roboflow Playground 公式サイトより公式情報を見る →
"Vision-language models excel at zero-shot exploration when requirements are fluid."/"When your classes are fixed and your inference volume grows, validate requirements with a vision-language model, then train a specialized model like RF-DETR on your own annotated data."/"A specialized detector localizes a defect on a conveyor belt and dynamically crops the region of interest. The vision-language model reads only the crop."/"Every model detail page provides an interactive live demo, licensing breakdowns, 30-day usage numbers, and API deployment code snippets in Python, JavaScript, and cURL."(Experiment with Playground Today 節/Explore the 130+ model directory 節)— Roboflow 公式ブログより公式情報を見る →
画像認識のAIモデル比較は公式の数字も一致しない
公式サイトと公式ブログでは、モデル数と同時実行数の数字が異なります。 2ページそれぞれの記載と日付は次のとおりです。
公式サイトと公式ブログの数字
| 比較する内容 | 公式サイト(2026-10-11) | 公式ブログ(2026-08-27) |
|---|---|---|
| モデル数 | 140以上 | 134(記事の題は130+) |
| 同時実行 | 最大4 | 最大5 |
| タスク数 | 25 | 25 |
| Compare | 2〜4モデル | 2〜4モデル |
公式サイトの値は2026年10月11日、公式ブログの値は2026年8月27日の記載です。実際に同時実行できるモデルの数は、画面でモデルを選ぶときに確認するのが確実です。
もう1点は、アップロードした画像の保存と学習への利用です。Roboflowは、アップロードした画像を保存するか、学習に利用するかを公表していません。
公式ブログは、オープンソースモデルの一部がホスト型のAPI経由でPlayground上で動作するとしています。保存と学習への利用が公表されていない以上、機密を含む画像は入れないでおくのが安全です。
"Roboflow Playground: Try and Compare 130+ Computer Vision Models"/"Published Aug 27, 2026"/"Playground hosts 134 models from Google, OpenAI, Anthropic, Meta, and Qwen."/"Thirty-seven run live in Playground via hosted APIs, so self-hosting is optional."(記事タイトル/公開日の表示/What is Roboflow Playground? 節/Explore the 130+ model directory 節)— Roboflow 公式ブログより公式情報を見る →
"Run 140+ vision AI models side by side, free."/"run up to four models on it at once, free"(トップの見出し文/Test Vision AI Models Online for Free 節)— Roboflow Playground 公式サイトより公式情報を見る →
ご自身の画像で選択し、公式の数字は日付で読む
Roboflow Playgroundは、ご自身の画像で画像認識AIを並べて比較する無料のツールです。 2026年10月11日時点の公式サイトでは、140以上のモデル・25のタスク・最大4モデルの同時実行が表示されています。
まずご自身の画像で試します。次にELOとVision Evalsで選択肢を限定し、必要ならWorkflowsと自社データでの学習へ進みます。
数字は、各ページの掲載日とあわせてお使いいただけます。モデル数も同時実行数も公式の2ページで異なるため、公式サイトの表記を優先し、上限は画面で見て判断します。
FAQ
- Roboflow Playgroundは無料で使うことができますか?
- 無料です。APIキーもノートブックもクレジットカードも必要ありません。ご自身の画像を1枚アップロードしてタスクを選択し、最大4つのモデルに同時にかけるところまでが無料の範囲です。
- 何種類のモデルから選択できますか?
- 公式サイトの表記は2026年10月11日時点で140以上です。Google・OpenAI・Anthropic・Meta・Qwenなど主要な提供元のモデルが掲載され、モデル一覧は新着順で見られます。公式ブログ(2026年8月27日)は134としています。一度に実行できるのは公式サイトで最大4つで、140以上は選択肢の総数を指します。
- 物体検出以外のタスクにも使うことができますか?
- 使うことができます。25のタスクのうち、物体検出のほかにOCR・キャプション生成・分類・セグメンテーションが公式に例示されています。一覧には深度推定・姿勢推定・動画の物体追跡・文書Q&Aなども含まれます。
- ランキングは誰の評価で成り立っていますか?
- アリーナのランキングには、人の好みのデータが入ります。Playgroundのクエリ5回に1回は、モデル名を伏せた比較になり、その結果がライブのアリーナランキングに直接入るとのこと。定められた画像課題でモデルを正解と照合するVision Evalsは、別の指標です。
- 選んだモデルをそのまま実運用に使うことができますか?
- Playgroundに掲載されているモデルは、Roboflow Workflowsでそのまま動作させることができます。検出・OCR・視覚言語モデル(画像を見て言葉で答えるモデル)を条件分岐で連携し、クラウドまたはエッジへデプロイする流れです。汎用モデルで精度が足りない場合は、自社データでの学習に切り替えます。
関連する記事
 OpenRouterが画像生成AIを同じプロンプトで横断比較する新指標OpenRouterが公開した「Image benchmarks」は、同じプロンプトで生成した画像をモデルごとに並べて見比べられるページです。2026年10月14日時点でFull wine glassの一覧には44件が掲載され、正確さ・料金・生成時間で並べ替えられます。
 Mistral OCR 4は信頼度も返し、料金は千ページあたり4ドルMistral OCR 4は文字の位置と表や数式といったブロックの種類のほか、読み取りの信頼度まで出力するOCRです。精度の点数は公式の内部評価によるもので目安にとどまるとのこと。料金は標準のAPIが1,000ページ4ドル(約647円)で、注釈にも対応するDocument AIは5ドル(約808円)です。
 PP-OCRv6とは?日本語OCRの認識精度と使い方、商用利用の条件PP-OCRv6の日本語の認識精度は公式ベンチマークで90.5%ですが、PaddleOCRが自ら測った値です。日本語を読ませるならモデルはSmall以上に限られ、pip installだけでは動作せず推論エンジンを別に入れます。ライセンスはApache License 2.0で、商用利用も無償です。
 ニトリに不正アクセス、会員・購入者の情報が最大3,762万件が流出の可能性ニトリホールディングスは2026年11月9日、自社システムへの不正アクセスを発表しました。会員や購入者の氏名・住所・電話番号などを含む情報が、最大3,762万件流出した可能性があるとのこと。ログインパスワードとクレジットカード情報は含まれません。ニトリや配送事業者を装うメールやSMSのリンクにはアクセスせず、公式サイトで本物か確認しましょう。