主要AI企業がrobots.txtの共通シグナルに対応へ
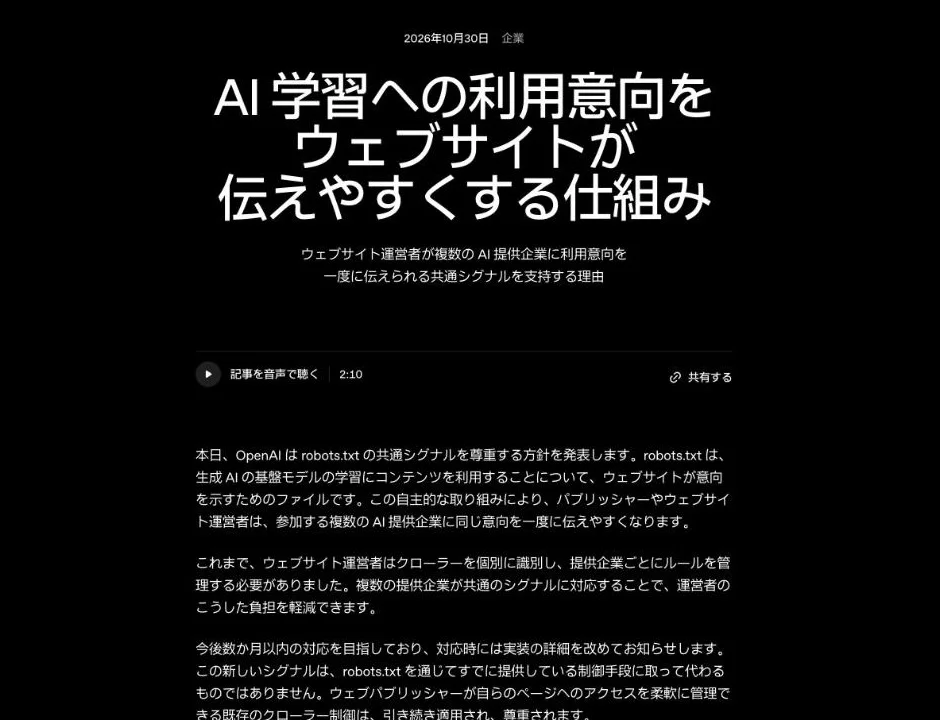
robots.txtとは、サイトのいちばん上の階層に置き、クローラー(自動でページを集めて回るプログラム)に読んでよいページを伝えるテキストファイルのことです。OpenAIは2026年10月30日、robots.txtに書く「共通シグナル」を尊重すると発表しました。共通シグナルは、生成AIの学習にサイトの内容を使ってよいかを、複数のAI企業へrobots.txtの同じ記述で伝えるための指定です。
robots.txtに1グループ書くだけで、AI学習の拒否をOpenAI・Google・Microsoftへまとめて伝えられるようになります。ただし、3社ともまだ対応を開始していません。 これまでは、AI企業ごとにクローラーの名前を確認し、会社別にルールを書き分ける必要がありました。同日にはGoogleとMicrosoftも対応を発表しています。
3社の対応はいつから?
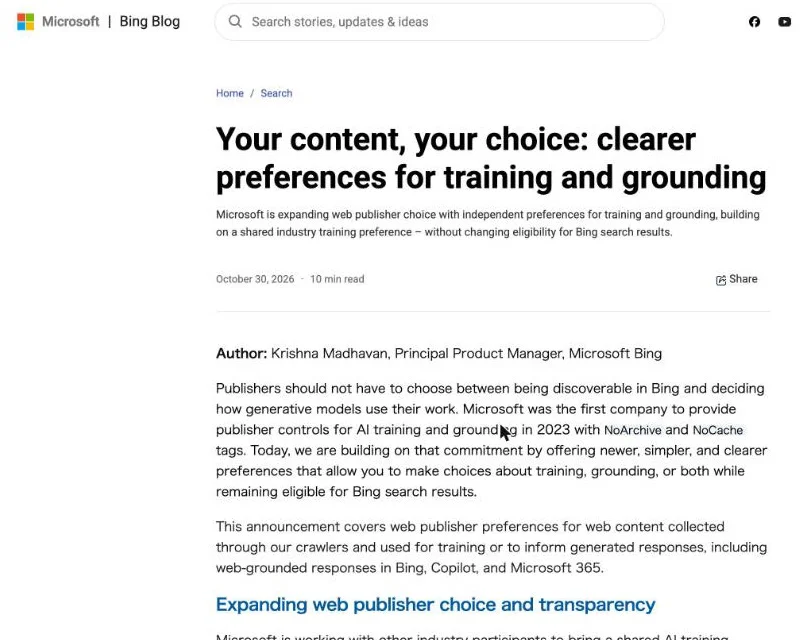
いちばん早く日付を公表したMicrosoftでも適用は2027年2月1日からで、Googleは2027年初め、OpenAIは時期を「今後数か月以内」としています。 3社の発表の要点は次のとおりです。
| 会社 | 対応の開始 | 発表した場所 |
|---|---|---|
| Microsoft | 2027年2月1日 | Bingの公式ブログ |
| 2027年初めの予定 | 検索セントラルのブログとクローラーの一覧 | |
| OpenAI | 今後数か月以内(日付は未定) | OpenAIの公式ブログ |
Microsoftは、2027年2月1日以降にクロールしたページから新しい指定を読み取ります。Googleはブログで「2027年に対応を目指す」とし、クローラーの一覧でも「2027年初め」と時期を記載しました。OpenAIは、対応した時点で実装の詳細を改めて公表するとのこと。
共通シグナルを定める草案は、Anthropicの担当者が書いたものです。担当者本人が、技術標準を議論するIETFのメーリングリストで「すでに実装を開始した」と書いたと、Unite.AIが報じました。同じ報道では、この担当者が共通シグナルを既存のクローラー制御を補うものと位置づけていることも伝えています。
"Starting February 1, 2027, Microsoft will honor the new preferences as it crawls"— Microsoft Bing Blogs より公式情報を見る →
"Google intends to support the AIPREF shared machine-readable training preference signal"/"in early 2027."— Google のクローラーの一覧より公式情報を見る →
"今後数か月以内の対応を目指しており、対応時には実装の詳細を改めてお知らせします。"— OpenAI より公式情報を見る →
仕組みはまだIETFで議論中の草案にすぎない
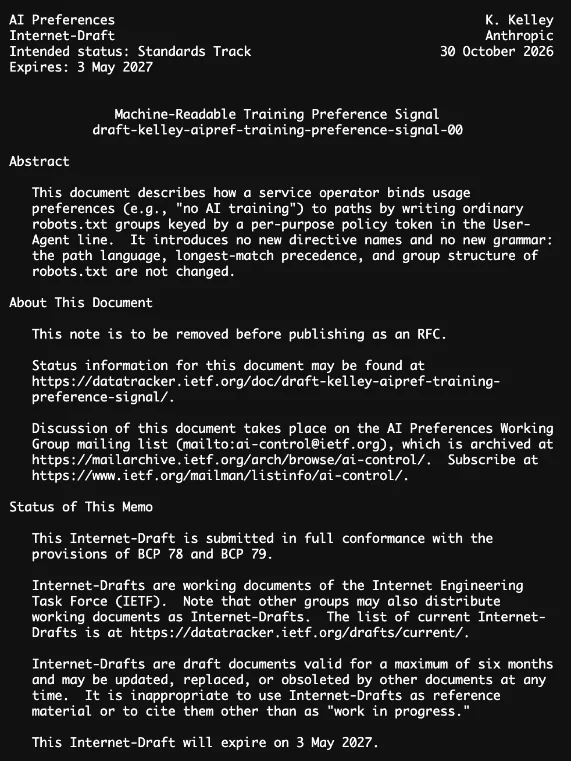
IETFとは、インターネットの技術標準を定める団体のことで、共通シグナルの書き方もIETFで議論されています。共通シグナルはAnthropicの担当者がIETFに提出した個人の草案で、標準として確定したものではなく、各社が自主的に尊重する取り組みです。
草案の題名は「Machine-Readable Training Preference Signal」です。AnthropicのKevin Kelley氏が、2026年10月30日にIETFへ提出しました。草案の有効期間は最長6か月で、この草案は2027年5月3日に期限を迎えます。
期限までに改訂されたり、別の文書に置き換えられたりする可能性もあるでしょう。OpenAIは、この取り組みがIETFのAI Preferencesワーキンググループの活動に基づくとし、議論の進展に合わせて運用を見直すとしています。
共通シグナルは各社が自主的に尊重する仕組みのため、対応を表明した会社のクローラーにしか効きません。対応を表明していない会社のクローラーには、これまでどおり会社ごとの名前で指定を書く必要があります。
"Internet-Drafts are draft documents valid for a maximum of six months and may be updated, replaced, or obsoleted by other documents at any time."/"This Internet-Draft will expire on 3 May 2027."— Status of This Memo より公式情報を見る →
共通シグナルをrobots.txtに書く方法
共通シグナルの1グループに書く3種類の行
ポリシートークンとは、クローラーの名前の代わりに「AIの学習」のような用途を表す語のことで、共通シグナルではUser-Agentの行にこの語を書きます。User-Agentの行にクローラー名の代わりに「__usage_ai-training」と書き、Disallowで拒否、Allowで許可を表します。
行の書き方やパスの指定方法は、今のrobots.txtとまったく同じです。命令の種類も追加されていないので、共通シグナルに対応していないプログラムは、この部分を知らないクローラー向けのグループと見なして読み飛ばします。
サイト全体でAI学習を拒否
「User-Agent: __usage_ai-training」の下に「Disallow: /」の1行を置けば、サイトのすべてのページについて学習を拒否する意向になります。 「/」はサイトのいちばん上の階層を指し、その下にあるページがすべて対象です。Microsoftが公式ブログに掲載した例も、次の2行でした。
User-Agent: __usage_ai-training
Disallow: /
特定のフォルダだけを拒否したいときは、「Disallow: /example-path/」のようにパスを書きます。Microsoftによると、何も書かなければ学習を許可したものとみなされるとのこと。
"Allow is the default, so no robots.txt AI Training setting is needed to allow training."— Microsoft Bing Blogs より公式情報を見る →
一部のフォルダだけ学習を許可
「Disallow: /」に「Allow: /press-kit/」のような行を加えると、そのフォルダだけは学習に使ってよいと伝えられます。 草案が例に出しているのは、報道向けの資料を置くフォルダだけを学習に使ってよいとする書き方です。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
DisallowとAllowの両方に一致するパスでは、今のrobots.txtと同じく、より長く一致した行が優先されます。上の例では「/press-kit/」の下にあるページに「Allow: /press-kit/」のほうが長く一致するため、学習に使ってよいという意向になります。
"This expresses a preference _against_ AI training for all paths except those under /press-kit/, for which it expresses a preference _in favor_ (Section 4.2)."— Section 1 より公式情報を見る →
「User-Agent: *」では指定したことにならない
全クローラー向けのグループは共通シグナルとして読まれないため、__usage_ai-trainingのグループが無いサイトは何も意向を示していないとみなされます。 「User-Agent: *」の下に「Disallow: /」を書いていても、AIの学習を拒否したことにはなりません。
学習を拒否したいなら、「User-Agent: __usage_ai-training」の行を必ずご自身で書く必要があります。すでに「*」のグループがあるサイトも、共通シグナルのグループは別に書き加えてください。
"However, wildcard groups (i.e., User-Agent: *) MUST NOT be interpreted as matching the policy token."— Section 4.2 より公式情報を見る →
共通シグナルでもクロールは続き、各社の指定も有効
共通シグナルを書いたときの各指定の効き方
変わるのは学習に使ってよいかの意思表示だけで、検索エンジンの巡回や各社がすでに用意した指定はそのまま残ります。 共通シグナルは、今あるrobots.txtの指定を上書きするものではありません。書き加える前に、次の3点を確認しておくと設定を誤りにくくなります。
学習への利用は拒否できてもクロールは続く
共通シグナルはクローラーの巡回を制限する指示ではないため、検索エンジンへの掲載はこれまでどおりで、巡回自体を制限したいときは各クローラー向けのグループを書きます。 草案では、コンテンツの利用についての意向と巡回の制御は、互いに独立したものという位置づけです。Microsoftも、新しい指定はコンテンツの利用を管理するもので、クロールのアクセスを管理するものではないとしています。
ただし草案は、学習の目的だけで巡回しているクローラーなら、拒否されたページの取得を控えてよいともしています。拒否したページへの巡回は減少することがあっても、なくなるとは限りません。
"This policy token is not a directive for crawling behavior."/"If a service operator wishes to limit crawling, it MAY use groups for crawlers' product tokens in robots.txt to do so."— Section 4.4 より公式情報を見る →
GPTBotなど各社の個別指定はそのまま有効
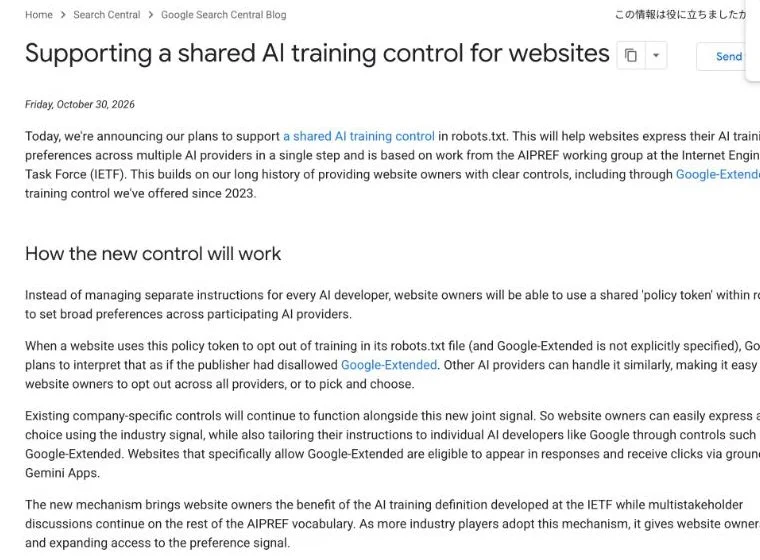
OpenAIもGoogleも各社の指定を置き換えないとしており、企業ごとの指定は共通シグナルより具体的な指定として優先されることがあります。 OpenAIは、GPTBotなど既存のクローラー制御は引き続き適用されると発表しました。Googleも、Google-Extendedなど企業ごとの制御は共通シグナルと並行して使うことができるとしています。
草案は、より具体的な指定を一般的な指定より優先すべきだとしています。会社が独自の指定を共通シグナルより具体的なものとみなすことも認めているため、両方を書いて内容が一致しないと、会社ごとの指定が優先される場合があります。共通シグナルと各社の指定は、同じ向きに書きそろえておくのが確実です。
"この新しいシグナルは、robots.txt を通じてすでに提供している制御手段に取って代わるものではありません。"— OpenAI より公式情報を見る →
"Existing company-specific controls will continue to function alongside this new joint signal."— Google Search Central Blog より公式情報を見る →
基準はページを取得した時点のrobots.txt
robots.txtに書き加えた日より前に集められたページには意向が及ばず、個別の契約があれば契約の内容が優先されることもあります。 草案は、ページを取得した時点で有効だったrobots.txtの内容で、そのページに当てる意向を判断すると定めています。
共通シグナルを書き加えても、書き加える前に取得されたページには新しい意向が当てられません。サイト運営者とAI企業が個別に契約を結んでいる場合は、その契約の内容が共通シグナルの意向より優先されることがあります。
"expressed in the robots.txt file in effect when the asset was retrieved"/"Private agreements MAY override preferences expressed via this mechanism."— Section 3・4.5 より公式情報を見る →
GoogleとMicrosoftの対応の違いは?
共通シグナルで学習を拒否したときの2社での効き方
同じ1グループでも、Googleでは学習と回答での参照の両方が対象になり、Microsoftでは学習だけが対象になります。 GoogleとMicrosoftは、共通シグナルを自社のどの指定と結びつけるかも明らかにしています。AIの回答への表示を残したいサイトは、2社の仕組みの差を確認してから書くと安全です。
Googleでは学習とGeminiでの参照の両方が対象
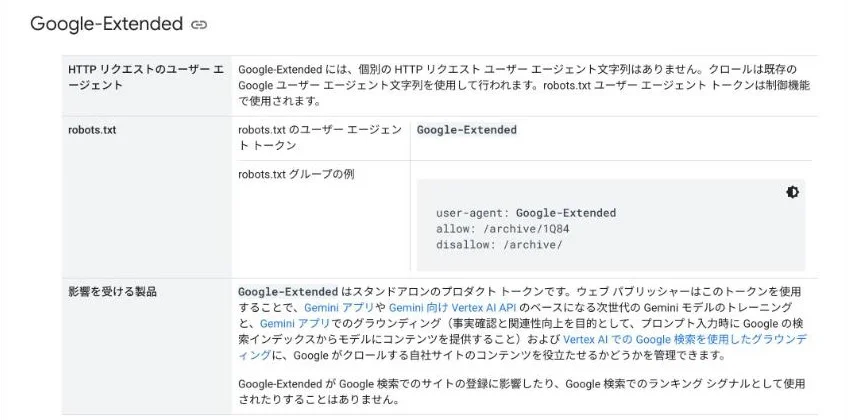
Googleでは、Geminiの学習とグラウンディングに使うかをGoogle-Extendedで管理します。したがって、Google-Extendedを個別に書いていないサイトは、共通シグナルの拒否がそのままGoogle-Extendedの拒否になります。結果として、Geminiの学習にもグラウンディングにも使われません。
Google-Extendedは、Googleが2023年から提供している学習の制御で、Google検索への掲載や順位には影響しません。Googleでは、学習とGeminiでの参照を分けて指定することはできません。Geminiの回答に表示させ続けたいなら「User-Agent: Google-Extended」のグループで許可を明示する必要があり、その場合はGeminiの学習にも使われます。
"When a website uses this policy token to opt out of training in its robots.txt file (and Google-Extended is not explicitly specified), Google plans to interpret that as if the publisher had disallowed Google-Extended"— Google Search Central Blog より公式情報を見る →
"Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search."— Google のクローラーの一覧より公式情報を見る →
Microsoftは学習と回答作成時の参照を別々に指定
Microsoftは共通シグナルを学習の指定としてだけ読み、回答を作るときの参照はページ単位の別の指定で管理します。したがって、学習は拒否しつつ、Copilotなどの回答には表示させ続けられます。 学習の指定はrobots.txtのほかにページ単位でも書くことができ、ページ単位の指定が優先される仕組みです。回答を作るときの参照(AI Grounding)の指定には、次の3つの選択肢があります。
| 指定 | 回答を作るときの参照 |
|---|---|
| Allow | 参照を許可する |
| Disallow | 参照を許可しない |
| DisallowExtended | CopilotなどMicrosoftが運営するサービスでの参照だけを許可する |
Microsoftによると、参照をDisallowかDisallowExtendedに設定した場合、AIの回答でブランドが表示される機会は減少するとのこと。Bing検索の掲載資格は変わりません。また、検索結果にページのキャッシュを表示させないための指定であるNoArchiveとNoCacheは、2027年3月1日以降は学習の意向として読まれなくなります。
"AI Grounding is a separate page-level preference from Microsoft that lets you manage how your content is used to help inform generated responses."— Microsoft Bing Blogs より公式情報を見る →
今すぐAI学習を拒否するrobots.txtの書き方
目的別に拒否するボット
今日から効くのは3社の学習用ボットを名指しする書き方で、その下に共通シグナルの1グループを加えた雛形を1回貼れば、各社の対応後も書き直す必要がありません。 表明した3社はまだ共通シグナルを読み取っておらず、3社に対しては名指しの指定だけが実際に働いています。
学習用のGPTBotやClaudeBotを個別に拒否
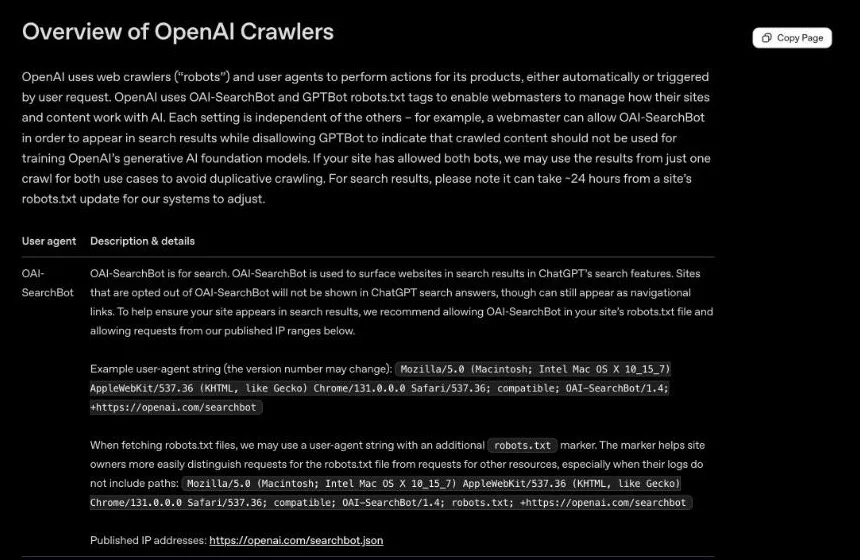
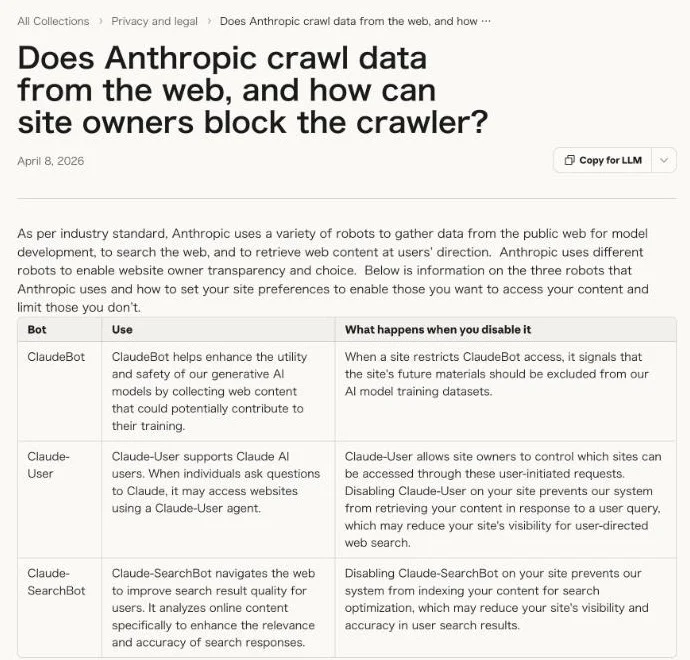
学習用のボットは3社に1つずつあり、それぞれに「Disallow: /」を書けば今日から学習を拒否できます。 Anthropicのヘルプによると、ClaudeBotを拒否すると、サイトが今後公開する内容は学習データの対象外になるとのこと。3社のボットを拒否する書き方は次のとおりです。
User-Agent: GPTBot
Disallow: /

User-Agent: Google-Extended
Disallow: /

User-Agent: ClaudeBot
Disallow: /
Geminiの回答にご自身のサイトを残したいなら、Google-Extendedのグループは「Disallow: /」ではなく「Allow: /」と書きます。Google-Extendedを書かずにおくと、Googleの対応後は共通シグナルの拒否がGoogle-Extendedの拒否として読まれるためです。
"Each setting is independent of the others – for example, a webmaster can allow OAI-SearchBot in order to appear in search results while disallowing GPTBot to indicate that crawled content should not be used for training OpenAI’s generative AI foundation models."— Overview of OpenAI Crawlers より公式情報を見る →
"When a site restricts ClaudeBot access, it signals that the site's future materials should be excluded from our AI model training datasets."— Anthropic ヘルプより公式情報を見る →
AI検索に出したいなら検索用のボットは拒否しない
OAI-SearchBotやClaude-SearchBotまで拒否すると、ChatGPTやClaudeが検索して作る回答に表示されなくなるので、学習用のボットだけを書きます。 OpenAIによると、GPTBotとOAI-SearchBotの設定は互いに独立しているため、検索の回答に表示されたまま学習だけを拒否することができるとのこと。
「User-Agent: *」で全部のクローラーを拒否すると、検索用のボットまで巡回できなくなります。AIの検索経由で訪れる読者を残したいサイトは、学習用の名前だけを並べるのが安全です。書き換えたrobots.txtがChatGPTの検索結果に反映されるまでには、24時間ほどかかることがあります。
"Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers, though can still appear as navigational links."— Overview of OpenAI Crawlers より公式情報を見る →
共通シグナルのグループも併記しておく
対応していない読み取りプログラムはこの行を無視するため、今のうちに書いておいても害がなく、各社が対応した時点から有効になります。 学習用のボット3つの後に共通シグナルのグループを加えた雛形は、次のとおりです。
# 学習用のボットを拒否(今日から有効)
User-Agent: GPTBot
Disallow: /

User-Agent: Google-Extended
Disallow: /

User-Agent: ClaudeBot
Disallow: /

# 共通シグナル(各社の対応後に有効)
User-Agent: __usage_ai-training
Disallow: /
雛形の貼り付け先は、ドメイン直下のrobots.txt(例:example.com/robots.txt)です。robots.txtがまだ無いサイトでは、新しく作ったテキストファイルに雛形をそのまま保存してください。
"will ignore policy-token groups as they would any group for a user agent they do not recognize."— Section 1 より公式情報を見る →
FAQ
- robots.txtでAI学習を拒否すると、Google検索の順位は下がりますか?
- 下がりません。Googleの学習用の指定であるGoogle-Extendedは、Google検索での表示にも順位にも影響しません。ただしGoogle-Extendedを拒否すると、Geminiの学習に加えてGeminiアプリの回答での参照にも使われなくなります。
- __usage_ai-trainingを書けば、今すぐAI学習を拒否できますか?
- まだできません。日付を公表した中で最も早いMicrosoftでも、共通シグナルを読み取るのは2027年2月1日からです。今すぐ学習を拒否するには、GPTBot・Google-Extended・ClaudeBotなど会社ごとの名前で「Disallow: /」を書き、共通シグナルのグループはその後に並べておきます。
- 「User-Agent: *」で全部のクローラーを拒否していれば、共通シグナルは書かなくてよいですか?
- 書く必要があります。草案では「*」のグループは共通シグナルとして読まれず、__usage_ai-trainingのグループが無いサイトは意向を示していないとみなされます。学習を拒否したいなら「User-Agent: __usage_ai-training」の行を別に書きます。
- 共通シグナルを書けば、すでに集められたページも学習の対象外になりますか?
- なりません。草案では、ページに当てる意向はそのページを取得した時点のrobots.txtで判断します。共通シグナルを書き加える前に取得されたページには、新しい意向は当てられません。
関連する記事
 生成AI3つを料金で比較、ChatGPTやClaudeなどの公式プランChatGPT・Claude・Geminiの生成AI比較を、公式ページに出ている料金だけで整理します。無料プランで十分な範囲と有料に切り替える目安をまとめ、用途別のおすすめの選び方も解説します。一度に読み込める文章量は3社で示し方が異なるため、数字を横に並べても比較になりません。
 5つのAI開発ツールの内蔵ブラウザに脆弱性、CodexとVS Codeは未修正Forever Securityの研究で、Cursor・GitHub Copilot・Codex・VS Code・Claude Desktopの内蔵ブラウザに、パソコン内のファイルを読まれるなどの脆弱性「EMBRACE」が見つかりました。CodexとVS Codeは研究の公開時点で未修正です。出所不明のHTMLファイルは内蔵ブラウザで開かないでください。
 OpenAIとAnthropicがAPIの値下げを続ける理由は乗り換え防止と価格競争OpenAIとAnthropicは2026年6月からの数か月で、LLMのAPI料金を最大80%値下げしました。データサイエンティストのMax Woolf氏によると、理由はモデルを簡単に乗り換えられること、安いオープンウェイトモデルとの競争、提供に必要な計算量の削減という3点とのこと。新旧の料金と値上がり説への反論も取り上げます。
 GoogleのクラウドでOpenAIのGPT-6を一部企業向けに提供開始OpenAIとGoogle Cloudが10月21日に提携し、GPT-6 Astraなど3モデルがModel Gardenに加わりました。今は一部企業向けのプライベートプレビューで、料金は両社とも未公表です。利用料はGoogle Cloudの請求に一本化され、プロンプトと出力はモデルの学習に使われません。