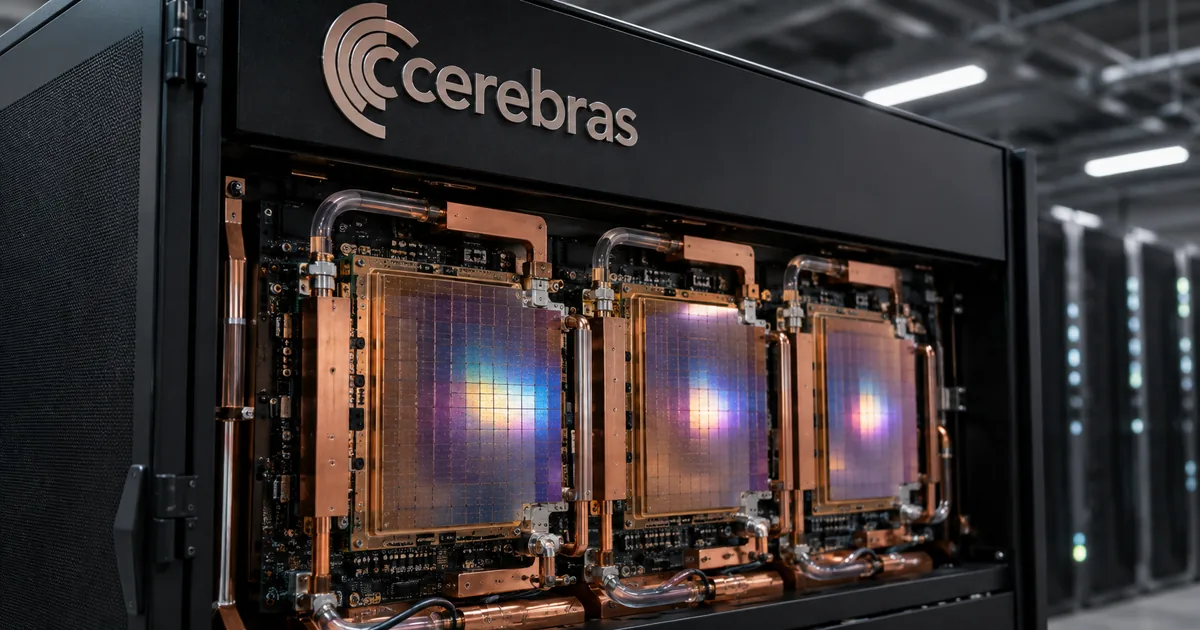
CS-4はWafer Scale Engineを3枚搭載
CS-4とはWafer Scale Engine(ウェハースケールエンジン)を3枚搭載してラック1本にまとめた、セレブラスの製品のことです。また、Cerebras Systemsが2026年8月18日に発表した第4世代の製品で、搭載するウェハーは新しいWSE-3 Turbo(WSE-3T)です。次世代のラック基盤であるCerebras Nexus(ネクサス)にとって、最初の製品でもあります。
前世代のCS-3と比較したラック全体の数値は次のとおりです。表の2列目は1ウェハーぶんのCS-3の値で、3列目は3ウェハーぶんのCS-4の値です。
| 観点 | CS-3(1ウェハー) | CS-4(3ウェハー) |
|---|---|---|
| AI演算 | 125 PFLOPS | 750 PFLOPS |
| メモリ帯域 | 21.6 PByte/s | 129.6 PByte/s |
| オンチップのファブリック帯域 | 26.7 PByte/s | 160.5 PByte/s |
| システムI/O帯域 | 1.2 Tbit/s | 7.2 Tbit/s |
| I/Oレイテンシ | 5マイクロ秒 | 2マイクロ秒 |
PFLOPSは1秒あたりの演算回数の単位で、PByte/sとTbit/sはデータを運ぶ速さの単位です。ファブリックはチップ内部の配線を指し、レイテンシとはデータの出入りにかかる待ち時間のことです。
Cerebrasはプレスリリースで、WSE-3TをWSE-3と同じく史上最大のAIプロセッサとしています。WSE-3Tの主な仕様は次の4つです。
- 4兆個のトランジスタ
- 90万個のAI最適化コア
- 46,225平方ミリのシリコン
- ウェハー上に直接統合した44GBのSRAM(プロセッサに直結した高速メモリ)
ウェハー1枚あたりの性能は前世代から次のように変わりました。レイテンシ以外の値は、表のCS-4の列(3ウェハーぶん)ではなく1ウェハーぶんです。
- AI演算: 250 PFLOPS(倍増)
- メモリ帯域: 43.2 PByte/s(倍増)
- ファブリック帯域: 53.5 PByte/s(倍増)
- 外部とのI/O: 2.4 Tbit/s(倍増)
- I/Oレイテンシ: 5マイクロ秒から最短2マイクロ秒へ短縮
Cerebrasは、速度とスループット(単位時間あたりの処理量)は主にメモリ帯域に左右されるため、帯域が倍になれば両方とも大きく改善するとしています。CS-4はこのWSE-3Tを3枚搭載するので、ラック全体のメモリ帯域は129.6 PByte/sになります。
The CS-4 is a rack-scale solution built from three new Wafer Scale Engines and revolutionary rack and system designs. / Like the WSE-3, the WSE-3T is the largest AI processor ever built, containing four trillion transistors and 900,000 AI-optimized cores across 46,225 square millimeters of silicon, with 44GB of SRAM integrated directly on the wafer. — 冒頭と A New Processor 節より公式情報を見る →
GPU比最大30倍はどんな条件で出た数値か
プレスリリースの最大30倍は、GPT-OSS-120BというモデルでCS-4とGPUに同じプロンプトを与え、速度を比較した値です。 CS-4はユーザーあたり毎秒4,400トークン超(TPS/user)を出し、GPUベースの製品より最大30倍速いとのこと。トークンとはAIが文章を処理するときの区切りの単位のことです。
プレスリリースは脚注で、実際のスループットがモデル構造・コンテキスト長・精度・サービング構成によって変わると補足しています。ブログ末尾の但し書きにも、GPUとの速度差はワークロード(処理の内容)・構成・測定日・測定に使ったモデルによって変わりうるとしています。30倍はCerebrasが公表した条件での値です。
ブログは取り上げたモデルのすべてで最大30倍だと書き、対象は小規模で効率的なものから世界最大級のモデルまで及ぶとしています。ブログのグラフには、出所としてArtificial Analysisと社内ベンチマーク(2026年8月)が記されています。しかし出所に第三者機関と社内ベンチマークが併記されているだけで、どの数値がどちらによるものかは書かれていません。
大きなモデルについては2本の文書で書き方が異なります。ブログは10兆パラメータ(モデルの大きさを表す数)を超えるモデルで毎秒1,000トークン超を出せると書き、出所は社内ベンチマークからの外挿(実測値の延長で見積もった値)とのこと。プレスリリースにある50兆パラメータ超という数字はクラスタとして対応できるモデルの規模で、速度の値は書かれていません。
プレスリリースの冒頭は、CS-4がCS-3より最大2倍速く、ユーザーあたりの速度でGPUとの差が最大30倍になるとしています。ブログにはCS-3比で最大10倍のトークン容量と最大2倍の速さという数字があり、出所は社内ベンチマークと予測とのこと。またCerebrasは、ワット当たりのスループットがCS-3の最大10倍だとしています。同じ電力でトークンの速さと量を両立できるという主張です。
30倍の比較には、条件の書かれていない部分があります。Cerebrasが明らかにしていないのは次の3点です。
- 比較対象としたGPUの機種・世代・台数・構成
- モデルごとの30倍の内訳
- 第三者機関が出した数値そのものと再現条件
Cerebras CTOのSean Lie(ショーン・リー)は、30倍速くなる効果は応答が速く感じられることにとどまらないと指摘しています。エージェント(AIが手順を組んで作業する仕組み)なら、同じ待ち時間で推論・検証・ツールの利用を1桁以上多くこなせるとのこと。開発者は応答の速い推論とエージェント型の用途を、データセンターの運営者は電力あたりのスループットを求めているとブログは書いています。
プレスリリースとブログは同じ製品を取り上げていますが、数値や条件の書き方が異なる箇所があります。両方の本文を貼り付けて差分を取ると、どこが言い換えでどこが別の記述かを確認できます。
It is up to twice as fast as the CS-3, bringing the CS-4s advantage in tokens-per-second-per-user over GPUs to up to 30x more. / In a head-to-head comparison on GPT-OSS-120B, when given identical prompts, the CS-4 delivers / more than 4,400 tokens second per user (TPS/user), up to 30 times faster than GPU solutions. / Being 30 times faster doesn’t just make a response feel fast. It gives an agentic system room for more than an order of magnitude as much reasoning, verification, or tool use in the same wall-clock time / Actual throughput varies by model architecture, context length, precision, and serving configuration. — 冒頭と A New Leader in AI Inference Speed and Capacity 節と脚注[1]より公式情報を見る →
Source: Artificial analysis and internal benchmarking (August 2026) / With this low-latency communication, CS-4 can deliver more than 1,000 tokens per second on models exceeding 10 trillion parameters. / Source: extrapolation from internal benchmarking (August 2026). / up to 10x more token capacity and up to 2x faster performance than CS-3. Source: internal benchmarking and projections (August 2026). / Observed inference speed improvements versus GPU-based systems may vary depending on workload, configuration, date and models being tested. — Up to 30x faster than GPUs 節と 1,000 tokens per second 節と末尾の注記より公式情報を見る →
Wafer Scale Engine向け電力設計とGPU併用
Cerebrasは、CS-4の速さがプロセッサ単体の改良ではなくラック全体を設計し直した結果だとしています。 ブログによると、演算・電力・冷却・I/Oをそろえて改良しなければ、性能は大きく伸びないとのこと。
Nexusはラックを演算・電力・I/Oの3つの基礎要素に分け、それぞれを独立に更新できるようにしたモジュール構成です。1つの要素の改良が他の部分の再設計を待たずに顧客へ届くとのこと。CS-4はNexusを採用した最初の製品です。
Wafer-Scale Backpackは、背面に取り付ける自己完結型の部品です。電力変換・直接液冷・高速I/O・制御電子回路を、ウェハーの周りの小型の立体パッケージにまとめています。演算部を電源から切り離したことで製造が簡素になり、展開にかかる時間が数日から数時間に短縮されたとのこと。前世代比で、Backpackは部品点数が50%少なく、自動化製造を60%多く使っています。
CS-4では電力の届け方も変わりました。従来のGPUボードでは電力を変換する部品とプロセッサの距離が約50ミリメートルでしたが、CS-4では1/100の約0.5ミリメートルまで近づけたとのこと。Cerebrasは、ボード上の電力損失がほぼなくなるのでWSE-3Tへ2倍の電力を届けられ、動作周波数を上げてトークンの生成を速められるとしています。
新しいI/O(外部との入出力)の仕組みには2つの接続モードがあります。1つ目はイーサネット上の標準規格RoCE v2 RDMAによる、既存インフラとの接続です。ウェハー外への総帯域はウェハーあたり2.4 Tbit/s、CS-4ラック全体で7.2 Tbit/sになります。
2つ目は、スイッチを介さずラック内とラック間で、ウェハーどうしを直接接続するDirect Wafer Linksです。ウェハー間のレイテンシは最短2マイクロ秒まで下がります。
分離推論(disaggregated inference)とは、AIが応答を出力するまでの2つの段階を、別々の計算基盤に割り当てる方式のことです。1つ目はプロンプトを処理してモデルの状態を作るprefill、2つ目はその状態から応答を生成するdecodeです。
CS-4はdecodeを担当し、prefillには専用のエンジンを使う構成をネイティブにサポートしています。組み合わせ先としては、AMD Helios(ヘリオス)とAWS Trainium(トレイニウム)が紹介されています。
CerebrasのブログによればprefillをGPUやASIC(用途を限定して作った専用チップ)の基盤に任せ、decodeをCS-4で処理する異種混成の推論システムも組めます。OpenAIの推論用チップについては「OpenAI自社推論チップJalapeño、電力効率は実測で最大1.9倍」にまとめています。
By decoupling compute from the power supplies, the Wafer-Scale Backpack simplifies manufacturing and reduces deployment time from days to hours. Compared with the prior-generation system, the Wafer-Scale Backpack has 50% fewer components and uses 60% more automated manufacturing. / by moving power conversion 100x closer to the processors – from roughly 50 millimeters away from the processor as on conventional GPU boards to approximately 0.5 millimeters – CS-4 nearly eliminates board-level power loss. This delivers twice as much power to the WSE-3T, enabling higher operating frequencies and faster token generation. / The Wafer I/O Module also supports a new communication mode, called Direct Wafer Links, which enables wafers to be linked within and across racks without a switch. — New System and Rack Design 節より公式情報を見る →
Compute, power, cooling, and I/O have to move forward together. / First, a purpose-built prefill engine processes the incoming prompt and prepares the model state. That state is then transferred to CS-4, where the system performs ultra-low-latency decoding and generates the response. / Providers can use GPU or ASIC infrastructure for efficient prefill while using CS-4 for ultrafast decode — 冒頭の設計の前提と Native support for disaggregated inference 節より公式情報を見る →
セレブラスのAI機は発表と同じ四半期に出荷、価格はまだ公表されていない
最初のCS-4の出荷は「今四半期」に始まると、プレスリリースとブログの両方が書いています。 「今四半期」は発表日を含む四半期を指し、プレスリリースにもブログにも次の情報は記載されていません。
- 出荷の具体的な日付と四半期の名前
- 価格
- 出荷の数量
- 初期の顧客
- 消費電力の絶対値(書かれているのはワット当たりのスループットの倍率)
システム全体の仕様は、CS-4のデータシートに掲載されているとプレスリリースは案内しています。出荷の時期は、将来予想に関する記述(forward-looking statements)に当たりうるとのこと。今後注目したいのは、データシートの内容と実際に出荷が始まる日付です。
Cerebras CS-4は、WSE-3 Turboを3枚搭載して750 PFLOPSを出すラック型の製品です。GPU比最大30倍という数字は、モデルや構成で変わるとCerebrasが述べています。速さの源は電力供給を含むラック全体の再設計と分離推論とのこと。出荷は発表と同じ四半期に始まりますが、Cerebrasは価格をまだ公表していません。
First CS-4 shipments begin this quarter. Full system specifications are available in the CS-4 datasheet at https://www.cerebras.ai/cs4-datasheet. / statements about the anticipated benefits of CS-4 and WSE-3 Turbo, the rapid creation of disaggregated solutions, and the timing of CS-4 shipments — Availability 節と Forward-Looking Statements 節より公式情報を見る →
The first CS-4 shipments begin this quarter. — What comes next 節より公式情報を見る →
FAQ
- Cerebras CS-4はいつから使うことができますか?
- 最初の出荷は発表と同じ四半期に始まると、プレスリリースとブログの両方が書いています。Cerebrasは具体的な日付と価格をまだ公表していません。システム全体の仕様は、CS-4のデータシートにあるとプレスリリースが案内しています。
- 「GPU比30倍」は何を比較した数字ですか?
- GPT-OSS-120Bに同じプロンプトを与えた直接比較で、CS-4がユーザーあたり毎秒4,400トークン超を出した条件での値です。Cerebrasは比較対象のGPUの機種と構成を明らかにしていません。ブログは取り上げたモデルのすべてで最大30倍と書き、プレスリリースの脚注は実際のスループットがモデル構造・コンテキスト長・精度・サービング構成で変わるとしています。
- WSE-3 Turboは前世代のWSE-3と何が異なりますか?
- WSE-3と同じく4兆個のトランジスタと90万個のAI最適化コアを搭載し、AI演算と帯域が倍になっています。ウェハー1枚あたりのAI演算は250 PFLOPSへ、メモリ帯域は43.2ペタバイト毎秒へ倍増しました。I/Oレイテンシも5マイクロ秒から最短2マイクロ秒へ短縮されています。
- CS-4はGPUの代わりになりますか?
- prefill(プロンプトの処理)にGPUやASICの基盤を使い、decode(応答の生成)にCS-4を使う組み合わせが発表で紹介されています。CS-4がGPUを置き換えるかどうかについては、プレスリリースでもブログでも言及されていません。
関連する記事
 NVIDIAが韓国Rebellionsと初期協議、提携・出資・買収は未定NVIDIAが韓国のAI半導体企業Rebellionsと、技術提携・出資・買収を含む初期段階の協議をしているとBloombergが2026年8月21日に報じました。RebellionsはAI推論向けのNPUを設計する会社で、日本でもRebellionsの実証と導入計画が進んでいます。
 国産AIチップを拒む企業は「裏切り者」、丁薛祥副首相の警告をWSJが報道丁薛祥副首相が国産AIチップの採用を拒む企業は「裏切り者」だと警告したと、WSJが関係者の話として報じました。中国政府の公式発表ではありません。米国の輸出規制でAI半導体の調達が難しくなるなか、副首相は2026年4月に外部の圧力に耐える独自の道を進むべきだと公の場で述べています。
 ニトリに不正アクセス、会員・購入者の情報が最大3,762万件が流出の可能性ニトリホールディングスは2026年11月9日、自社システムへの不正アクセスを発表しました。会員や購入者の氏名・住所・電話番号などを含む情報が、最大3,762万件流出した可能性があるとのこと。ログインパスワードとクレジットカード情報は含まれません。ニトリや配送事業者を装うメールやSMSのリンクにはアクセスせず、公式サイトで本物か確認しましょう。
 Claude Fable 5.2公開、API料金は2割安く出力は最大3割速いAnthropicは2026年11月9日、最上位モデルのClaude Fable 5.2を公開しました。API料金は100万トークンあたり入力8ドル(約1,265円)・出力40ドル(約6,327円)で、Fable 5.1より2割安くなりました。出力生成も最大30%速くなっています。ProとTeamの標準シートは日本時間11月17日まで、週の利用上限の半分をFableに使うことができます。