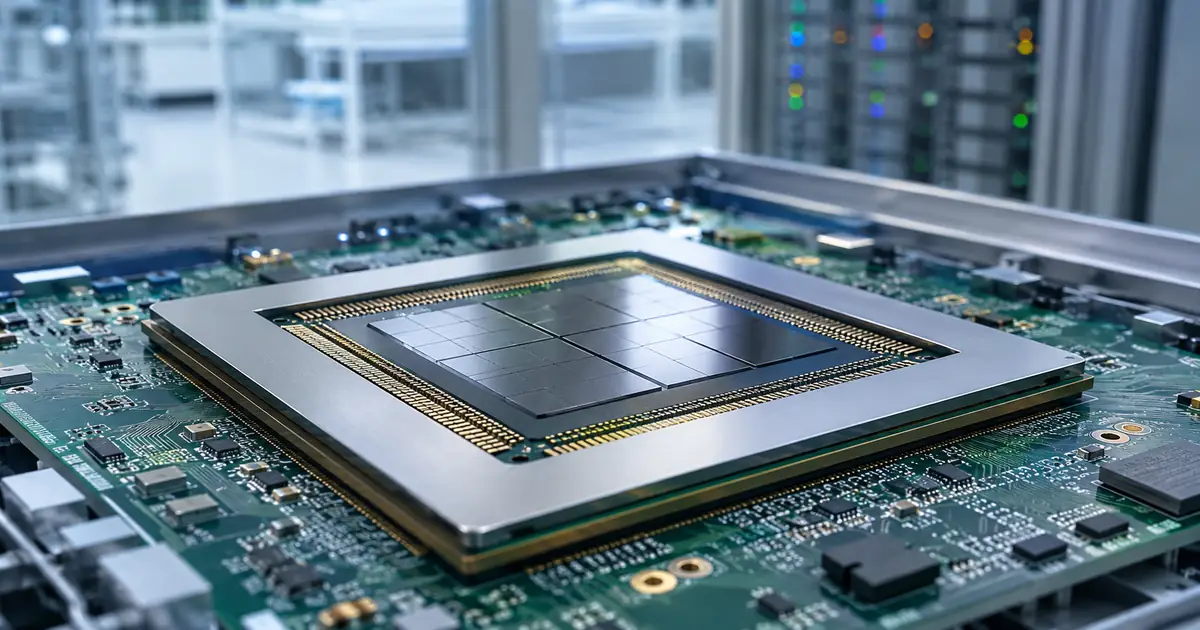
Jalapeñoとは推論に特化したOpenAI初の自社チップ
Jalapeñoをつくる3社の分担
Jalapeño(ハラペーニョ)は、OpenAIが半導体大手のBroadcomと組んでつくった、初の自社設計AIチップです。2026年6月24日の発表でOpenAIはJalapeñoをIntelligence Processorと呼んでおり、Jalapeñoは両社が複数世代にわたってつくる計算基盤の1世代目です。
推論は完成したモデルを動作させる処理、学習はモデルを作る処理
AIの処理は大きく2種類あります。学習は大量のデータを読ませてモデルそのものをつくる処理のこと。一方、できあがったモデルを動作させてプロンプトに回答するのが推論で、ChatGPTに何かを入力して回答が表示されるまでの処理はすべて推論です。
Jalapeñoは推論専用のチップです。昔のAI処理向けにつくられた汎用アクセラレータを手直ししたものではなく、いまのLLM推論のために白紙から起こした設計とのこと。推論以外の用途を考えなくてよいので、OpenAIは演算・メモリ・ネットワークの割り振りを推論に合わせて定められます。
3社はJalapeñoの設計と量産と基板をどう分担しているか
3社は設計と量産と基板を分担しています。OpenAIは、自社のモデル・カーネル・サービングシステム・今後の製品計画を踏まえて、チップの中身を設計しました。
Broadcomは受け取った設計をシリコンに落とし、Tomahawkを含むネットワーク技術と量産の仕組みを持ち込みます。ボードとラックとシステム統合はCelesticaが担当し、全体としてはモデルをつくっている会社が設計し半導体とネットワークの会社が工業製品に仕上げる分担になっています。
試作チップ上でGPT-5.3-Codex-Sparkが動作
試作チップは6月の発表の時点ですでにラボで動作していました。量産で狙う周波数と電力の設定値のままで、GPT‑5.3‑Codex‑Sparkを含む処理を走らせていました。
ただし6月の時点では性能の測定がまだ途中で、OpenAIは「ワットあたり性能が現行の最先端を大きく上回る見込み」という言い方にとどめ、具体的な数値は出していませんでした。詳しい情報は今後数か月以内に出すとしており、2026年8月25日に実測値が公開されました。
"OpenAI and Broadcom (NASDAQ: AVGO) today unveiled Jalapeño, OpenAI’s first Intelligence Processor: an accelerator architected around OpenAI’s vision for the future of LLM inference"/"Jalapeño is a blank-slate design for modern LLM inference, not a general-purpose accelerator adapted from earlier AI workloads."/"Broadcom’s silicon implementation and networking technologies, including Tomahawk networking silicon, help bring the platform to large-scale production."/"Engineering samples of the Jalapeño chip are running ML workloads in the lab at production target frequency and power, including GPT‑5.3‑Codex‑Spark."(Jalapeño 発表本文)— OpenAI より公式情報を見る →
2026年8月25日の初の実測でワットあたりの処理量は1.5〜1.9倍
OpenAIが公開した実測値(比較対象システムとの比)
| 指標 | 比較対象システムに対する結果 |
|---|---|
| ピーク時のワットあたりAI処理量 | 1.5〜1.9倍 |
| 端から端までの遅延 | 1/1.7〜1/3.6 |
| 対話性の高い処理での性能 | 2.1〜4.1倍 |
| Kimi K2.5 1Tのワットあたりピーク性能 | 約1.5倍 |
| Kimi K2.5 1Tの端から端までの遅延 | 約1/3.4 |
OpenAIは2026年8月25日に、Jalapeñoの初めての実測結果を公開しました。測定に使ったSemiAnalysisのベンチマークInferenceXは、チップ単体の演算性能ではなくAIへのリクエストを受け取ってから返し終えるまでの一連の処理を見るものです。
試したモデルは重みが公開されている次の3本です。OpenAI以外の会社がつくったモデルも含まれています。
- GPT‑OSS 120B
- DeepSeek R1 670B
- Kimi K2.5 1T
遅延は1/1.7〜1/3.6、対話処理は2.1〜4.1倍
スループットは一定の時間にさばける処理の量のこと。なお、スループットと応答速度は片方を伸ばすともう片方が落ちる関係になりがちですが、OpenAIは両方を1つの設計で同時に上げたとしています。3本に共通して出た数字は次の3つです。
- ピーク時のワットあたりAI処理量:比較対象システムの1.5〜1.9倍
- 端から端までの遅延:1/1.7〜1/3.6
- 対話性の高い処理での性能:2.1〜4.1倍
最大規模だったKimi K2.5 1Tでは、ワットあたりのピーク性能が約1.5倍、遅延が約1/3.4でした。付録のグラフには個別の実数も出ており、GPT‑OSS 120Bのピーク時の混合TPS/kWは85,448対44,960、遅延は1.03秒対1.80秒とのこと。社内テストでは自社の最新モデルで差がさらに開いたとのことで、OpenAIの発表では、負荷が重いほど有利になる設計とされています。
比較対象はNVIDIAのGB200とGB300の2機種だけ
比較対象がどの製品なのかは本文ではなく付録のグラフに書かれています。GPT‑OSS 120Bの相手はGB200、DeepSeek R1 670BとKimi K2.5 1Tの相手はGB300で、いずれもNVIDIAのシステムでした。
OpenAIが公開した比較対象は逆にいえばこの2機種だけです。他の製品や世代と並べた数字は8月25日の発表にありません。
定格700ワットに対して実測の持続電力は550ワット以下
OpenAIは各アクセラレータの公表されている電力定格で結果を正規化しました。付録にある定格は次のとおりです。
- Jalapeño:700ワット
- 比較対象のGB200:1,200ワット
- 比較対象のGB300:1,400ワット
テスト中のJalapeñoの持続消費電力は定格を下回る550ワット以下でした。正規化に使った700ワットは実際に流れた電力ではなくカタログ上の数字とのこと。性能はチップ1個あたりで比較されることもありますが、OpenAIは電力あたりで見るほうが役に立つと考えています。
"To understand how Jalapeño performs in practice, we tested it on InferenceX, a public benchmark from SemiAnalysis that measures the full process of serving an AI request."/"Across all three, Jalapeño delivered 1.5 to 1.9 times more AI work per watt at peak throughput and 1.7 to 3.6 times lower end-to-end latency than the comparison systems. For highly interactive workloads, it delivered 2.1 to 4.1 times higher performance."/"On Kimi, the largest public model we tested, it delivered approximately 1.5 times higher peak performance per watt and 3.4 times lower end-to-end latency than the comparison system."/"To compare the systems consistently, we normalized the results using each accelerator’s published chip power rating. Jalapeño is rated at 700 watts, although its measured sustained power remained at or below 550 watts on the workloads tested."(Jalapeño’s first results 本文)— OpenAI より公式情報を見る →
この1.5〜1.9倍は誰がどの条件で測った値なのか
数字を受け取る前に確認する3点
ここまでの数字だけでは「JalapeñoはNVIDIAの数倍速い」とは言い切れません。測定の主体と条件と段階の3点を見直すと数字の受け取り方が変わります。
第三者が再測定したという記載はOpenAIの発表2本に無い
InferenceXは公開されたベンチマークですが、実際に回したのはOpenAIでした。発表の本文も、OpenAI自身がテストを進めてきたという書き方です。
6月24日と8月25日の発表2本を読むかぎり、外部の誰かが独立に同じチップを動作させて数値を再現したという記載は見つかりません。出ているのは公開された手法にもとづくOpenAIの測定結果だけです。
測定条件は公称8k/1kの固定長だけで実運用の全体は測っていない
付録のグラフにはどのモデルでも「公称8k/1k・STP」という但し書きが記されています。つまり、「公称8k/1k・STP」は、入力8,000トークン・出力1,000トークンの固定長で1往復ぶんだけ流した測定という意味です。
実際のサービスでは会話が続くほど入力は長くなり、エージェントはツールの応答を待って止まり、保存した文脈を何度も読み直します。固定長の1往復は、文脈を読み直す処理のごく一部でしかなく、8k/1k以外の長さの数値も今回の発表に出ていません。
量産と大規模配備はこれからなので運用中に出た実績値ではない
8月25日の時点でJalapeñoはまだ量産に入っていませんでした。発表の終わりでOpenAIは量産のための適格性評価とソフトウェアの仕上げと大規模運用の準備を進めつつ、さらに多くのモデルで性能を検証しているとしています。
つまり8月25日の数値は本番に乗せたあとの実績ではありません。実運用での数値が出てくるとすれば、年末からの配備が始まって以降です。
"InferenceX · GPT‑OSS‑120B · nominal 8k/1k · STP · package TDP: Jalapeño 700 W; GB200 1,200 W"/"As we prepare for deployment, we are continuing production qualification, maturing the software, preparing to operate Jalapeño at scale, and validating performance across more models."(Jalapeño’s first results 本文・付録)— OpenAI より公式情報を見る →
第1世代のJalapeñoはNVIDIAの置き換えになるのか
OpenAI × Broadcomの日程
- 2025年10月10ギガワットのカスタムAIアクセラレータ提携を発表
- 2026年6月第1世代チップJalapeñoを発表
- 2026年8月初の実測を公開
- 2026年後半Broadcomがラックの配備を開始
- 2026年末OpenAIの計算基盤への導入を開始
- 2029年末ラック配備の完了目標
Jalapeñoは1枚のチップだけの話にとどまりません。Jalapeñoは、2025年から続くOpenAIとBroadcomの契約の第1世代という位置づけです。
設計から製造引き渡し(テープアウト)までの期間は9か月
テープアウトはチップの設計データを確定し、製造工程へ回す節目のこと。そして、Jalapeñoは初期設計からこの節目まで、わずか9か月で到達しました。高性能な先端半導体で、これまでで最速のASIC開発サイクルだとOpenAIは考えています。
Jalapeñoの開発の速さを支えたものは3つあります。ソフトウェアとハードウェアを一体で開発したこと、Broadcomが持つシリコン実装の知見、OpenAIのモデルを設計と最適化の一部に投入したことです。
AI生成の実装は一部のブロックで人手の1.5〜1.8倍の速度
AIがどれだけ役立ったかにも数字が出ています。オープンウェイトはモデルの重みが公開されていて、誰でもローカル環境で動作させることができるモデルのこと。OpenAIのチームはCodexとGPT‑Astraを使い、当初の量産計画に入っていなかったオープンウェイトモデル3本を2か月以内に高い性能で動作させることができるようにしました。
GPT‑OSSのアテンションとMixture-of-Expertsから選んだブロックでは、AIが生成した実装が人手で書かれた既存のものより1.5〜1.8倍速く動作しました。ただしこの倍率は選んだブロックに限った値で、モデル全体の話ではありません。
10ギガワット提携は2025年10月、配備は2026年末までに開始
Jalapeñoの前提になっている契約は、2025年10月13日に発表された10ギガワット規模の、カスタムAIアクセラレータ提携です。この発表でBroadcomはラックの配備を2026年後半に始め、2029年末までの完了を目指すとしていました。
Jalapeñoはこの提携が見込む複数世代計画の第1世代です。OpenAIは年末までに自社の計算基盤へ導入する予定で、開発が本格的に進む第2世代に続いて第3世代も具体化しつつあるとしています。
学習も推論もNVIDIA製を導入し続けるとOpenAIは書く
NVIDIAのGPUを置き換える話なのかどうかは、8月25日の発表に書いてあります。ただ、OpenAIは学習でも推論でもNVIDIAと他のパートナーのアクセラレータを今後も広く導入していくとしています。
OpenAIが推論の一部を自社チップへ移す分だけ、特定メーカーへの集中は薄まる方向です。ただし公表されている内容を素直に読むなら、置き換えではなく積み増しです。
"Jalapeño was co-developed from initial design to manufacturing tape-out in just nine months, and the custom AI accelerator program represents what we believe to be the fastest ASIC development cycle ever achieved in high-performance advanced semiconductors."(Jalapeño 発表本文)— OpenAI より公式情報を見る →
"Using Codex with GPT‑Astra, the team brought three open-weight models that were not part of Jalapeño’s original production plan to high performance within two months."/"For selected GPT‑OSS attention and mixture-of-experts blocks, AI-generated implementations ran 1.5 to 1.8 times faster than the existing human-expert-written implementations."/"We plan to begin deploying Jalapeño within OpenAI’s compute infrastructure by the end of the year. It is the first generation of a multigenerational roadmap: Gen 2 is deep in development, and Gen 3 is taking shape."/"We will continue to widely deploy accelerators from NVIDIA and other partners for both training and inference workloads."(Jalapeño’s first results 本文)— OpenAI より公式情報を見る →
"Broadcom to deploy racks of AI accelerator and network systems targeted to start in the second half of 2026, to complete by end of 2029"(戦略的提携 発表本文)— OpenAI より公式情報を見る →
推論専用の積み増しチップとしてのJalapeño
JalapeñoはOpenAIがBroadcomと組んでつくった初の自社設計チップで、LLMの推論専用です。2026年6月24日の発表では性能が見込みのままでしたが、8月25日に実測が公開されました。
出た数字はワットあたりの処理量で1.5〜1.9倍、遅延で1/1.7〜1/3.6でした。ただしこの倍率はNVIDIAのGB200・GB300に対して、カタログに記された各チップの電力定格でそろえた値で、OpenAIが公称8k/1kの固定長で出したものであり、第三者が同じ数値を再現したという記載も発表2本に見つかりません。
配備は2026年末までに始まる予定で、Broadcom側のラック展開は2029年末の完了を目指しています。学習でも推論でもNVIDIA製を使い続けるとOpenAIは明言しており、JalapeñoはNVIDIAの置き換えではなく積み増しです。ChatGPTの料金やOpenAIの関連の動きは、次の3本の記事で確認できます。
- ChatGPTの料金と上限:ChatGPTの料金プランを比較、無料版の上限とPlus・Proの違い
- プランごとの提供状況:GPT-5.6は無料プランも対応、ChatGPTで使える最新モデル一覧
- 脆弱性対応の自動化:OpenAI Daybreakとは?脆弱性発見から修正までをAIで高速化
FAQ
- OpenAIのJalapeñoとは何ですか?
- OpenAIがBroadcomと共同で開発した、OpenAI初の自社設計AIチップです。学習済みのモデルを動作させて回答を出力する「推論」専用に、白紙から設計されています。OpenAIは2026年6月24日の発表で、JalapeñoをIntelligence Processorと呼んでいます。
- JalapeñoはNVIDIAのGPUを置き換えるのですか?
- 置き換えではありません。OpenAIは実測を公開した同じ発表の中で、学習と推論、両方のワークロード向けにNVIDIAと他のパートナーのアクセラレータを今後も広く導入していくとしています。自社で行う推論の一部を自社チップへ移す分だけ、特定メーカーへの集中が薄まるという意味合いです。
- Jalapeñoの実測はどこまで信頼できますか?
- 公開ベンチマークInferenceXを使った測定ですが、回したのはOpenAIです。倍率は各アクセラレータの公表電力定格でそろえて出しており、Jalapeñoの定格700ワットに対して実測の持続電力は550ワット以下でした。第三者が同じチップを独立に動作させて数値を再現したという記載は、発表2本にはありません。
- Jalapeñoはいつから使われますか?
- OpenAIは2026年末までに自社の計算基盤へ導入する予定です。Jalapeñoは複数世代ロードマップの第1世代で、開発が本格化している第2世代に続き、第3世代も具体化しつつあるとされています。Broadcom側のラック配備は2026年後半に始まり、2029年末の完了を目指す計画です。
関連する記事
 OpenAIがGPT-6 Cyberを防御側に限定提供、サイバー能力はCriticalOpenAIは2026年11月5日、脆弱性発見と攻撃コード作成に特化した「GPT-6 Cyber」を発表しました。OpenAIの安全評価ではGPT-6 Astraと同じ「Critical」に分類され、Linuxカーネルでは948件の攻撃コードを作ったといいます。まず一部の承認済みDaybreak Red顧客に、APIとCodexで提供します。
 OpenAIとServiceNowが提携拡大、ChatGPTからインシデント対応が可能にOpenAIとServiceNowは2026年10月28日、提携を拡大すると発表しました。ChatGPTと自社のServiceNowを連携するプラグインはすでに提供が始まり、AIとの会話で類似インシデントを検索したり、レコードを更新したりできます。Codexの組み込みやセキュリティ製品などの新機能は、2027年にかけて提供される予定です。
 AI学習の拒否をrobots.txtで一括指定、主要AI企業が対応へOpenAIは2026年10月30日、AI学習の拒否を複数企業へまとめて伝えるrobots.txtの共通シグナルに対応すると発表し、GoogleとMicrosoftも続きました。ただし日付を公表した中で最も早いMicrosoftでも開始は2027年2月1日で、現時点で有効なのはGPTBotやGoogle-Extendedなど各社ごとの指定です。
 ChatGPTとCodexの利用上限、12月からPlus・Pro・Businessで共有にOpenAIは、12月からPlus・Pro・BusinessでChatGPTとCodexの利用上限を共有すると発表しました。利用量はトークン単位で計算され、高度なモデルや複雑な作業ほど多くなります。Instantのチャットは対象外です。OpenAIは具体的な開始日とプラン別の上限を公表していません。上限に達した後もクレジット購入で使い続けられます。