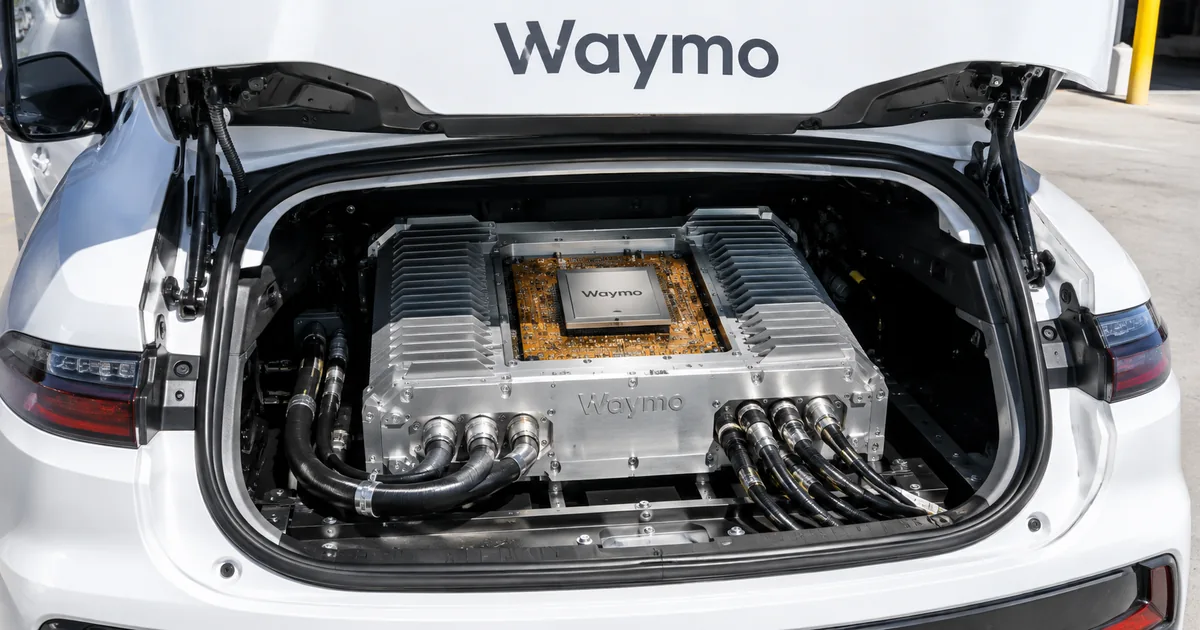
5nm ASICが処理するlidar・レーダー・カメラの生データ
このASICはコアML処理の手前で、lidar・レーダー・カメラの生データを処理します。コアのML頭脳(中心となる機械学習処理)に届く前の、大量の生データをさばくための専用チップとのこと。つまり、運転の判断そのものを置き換えるチップではなく、判断の手前で生データを使うことができる状態に整える工程を専用化したものです。
処理の対象はlidar・レーダー・カメラの生ストリームで、lidar(ライダー)は一般にレーザーで距離を計測するセンサー、レーダーは電波で距離と速度を計測するセンサーです。公開された内容を表にまとめると次のとおりです。
公開されたASICの要点
| 要点 | 内容 |
|---|---|
| 種別 | 自社設計の専用チップ(ASIC) |
| 製造プロセス | 5nm |
| 役割 | 生センサーデータの処理と融合およびMLモデルの実行 |
| ML性能 | ASICだけで1000TOPS超(前段処理とMLモデル向け) |
| 対象センサー | lidar・レーダー・カメラ |
| カメラ | 最新システムで13台の高解像度カメラを同時に処理 |
| 分類 | 開発中の複数のカスタム部品のうちの1つ |
Waymoはカスタム部品を複数開発しており、今回公式ブログで公開したのはこのASICです。残りの部品の中身は公式ブログで明らかにされていません。
"To handle the massive influx of raw data before it reaches our core ML brain, we are excited to introduce our purpose-built 5nm ASIC. While this chip is just one of several exciting custom components we’re developing, it is a specialized ML powerhouse engineered exclusively to process, fuse, and run advanced neural networks on raw sensor data in real time."(Waymo's purpose-built 5nm ASIC 節)— Waymo 公式ブログより公式情報を見る →
時間方向のノイズ除去で暗所の自動運転カメラ認識を高める
ASICが生のlidar・レーダー・カメラのデータから情報を取り出す処理には、暗所の認識精度がアップする時間方向のノイズ除去(temporal denoising)が含まれます。この処理は専用アクセラレータ(特定の計算に特化した回路)が処理するとのこと。時間方向のノイズ除去は、一般に連続して届くデータの前後を比較して雑音を除く処理を指します。
暗い場所ではカメラの映像に雑音が乗りやすくなります。最新システムは13台の高解像度カメラのデータを同時にリアルタイムで処理しており、Waymoは従来型のカメラが見落とす環境の細部まで認識できるとしています。
"The ASIC’s specialized accelerators instantly extract critical information from raw lidar, radar, and camera streams, including temporal denoising for superior low-light perception."/"Our latest system (right) processes high-fidelity data from 13 high-resolution cameras simultaneously and in real time, delivering exceptional low-light perception and revealing critical environmental details that traditional cameras (left) miss."(Waymo's purpose-built 5nm ASIC 節)— Waymo 公式ブログより公式情報を見る →
自動運転のセンサーフュージョンを実行する推論エンジン
複数センサーの情報を1つにまとめる処理を、センサーフュージョンと呼びます。抽出された情報は、専用設計の推論エンジン(学習済みのMLモデルを実際に実行する部分)へ渡るとのこと。この専用エンジンでセンサーフュージョンのMLモデルを実行することで、情報の細かさ(忠実度)を落とさずに効率を上げます。
Waymoは、シリコンとセンサーとアルゴリズムを並行して開発しているとしています。疎な畳み込みから密なトランスフォーマーまで、性質の異なるMLモデルを同じチップで実行できます。
"Developing silicon, sensors, and algorithms side-by-side allows us to push the boundaries of sensor fidelity, bandwidth efficiency, and quantization to execute a heterogeneity of models from sparse convolutions to dense transformers."/"This data feeds into our purpose-built inference engine to run sensor fusion ML models, enabling greater efficiency without sacrificing fidelity."(Waymo's purpose-built 5nm ASIC 節)— Waymo 公式ブログより公式情報を見る →
1000TOPS超はASICだけで、GPUとは役割が異なる
ASIC(専用チップ)は特定の用途向けに設計した集積回路で、さまざまな計算に使うことができるGPUとは用途の広さが異なります。TOPSは1秒あたりに何兆回の演算ができるかを表す一般的な単位で、1000TOPSは毎秒1,000兆回です(公式ブログに単位の説明はありません)。
1000TOPS超の対象はこのASICだけで、前段処理とMLモデルに充てた性能です。1000TOPS超の読み方は次の3点です。
- 対象はASICだけの性能(システム全体の総計は明らかにされていない)
- 用途は、前段処理とMLモデルに充てた分(走行判断全体の性能は明らかにされていない)
- 公式ブログの原文は、ASICを複数形(these ASICs)で書いている(搭載数は明らかにされていない)
計算基盤全体はML優先のアーキテクチャ(設計の基本方針)で組まれています。オーケストレーション(処理の段取り)・データ移動・ログ取得といったML以外の重要な仕事を管理するため、ML技術を最良のCPU・GPU・アクセラレータと組み合わせるとのこと。目的はML計算に充てる時間を最大にすることで、結果として性質の異なるプロセッサを組み合わせたヘテロジニアス(異種混合)なシステムになっています。
Waymoは1000TOPS超という数字とは別に、実際に出る性能を最大にするためスタック全体を最適化しているとしています。とくに重点を置いているのは、普段よく使う低バッチ(一度に処理する量が少ない状態)の領域です。
"While these ASICs alone deliver over 1,000 TOPS of ML performance dedicated to front-end processing and ML models, we optimize across the full stack to maximize achieved performance, especially in the low-batch regimes we often operate."(Waymo's purpose-built 5nm ASIC 節)/"We built an ML-primary architecture to run advanced neural networks at minimal latency. To manage critical non-ML tasks like orchestration, data movement, and logging while maximizing time for ML computation, we pair our ML technologies with the best CPUs, GPUs, and accelerators. The result is a balanced, heterogeneous system."(custom systems 節)— Waymo 公式ブログより公式情報を見る →
Waymo Driver搭載ロボタクシーのコンピュータ3条件
乗客を乗せて無人で走るWaymoの車両で、自動運転システムWaymo Driverの頭脳となるのが車載のコンピュート(計算基盤)です。計算基盤は、生のセンサーデータをリアルタイムの運転指令へ変換するとのこと。
人間のバックアップが無い分、Waymoの計算基盤には従来の運転支援向けよりはるかに高い性能が必要になります。Waymoは完全自動運転で2億マイル超の経験を積んでおり、その経験から計算基盤の条件を定めたとのこと。譲れない条件は応答性・耐環境性・冗長性の3つで、次のとおりです。
計算基盤の3つの設計条件
| 条件 | 内容 | 公式ブログに記載された数値や仕組み |
|---|---|---|
| 応答性(Responsive) | 判断を車載側だけで行いミリ秒以内で処理し続ける | 最初のピクセルから動作までの遅れを最小化。演算性能は8年で20倍 |
| 耐環境性(Ruggedized) | 振動・衝撃・極端な温度に常にさらされても動作する | 車両の液冷システムへ直接統合することで、中西部の凍える冬でもフェニックスの酷暑でもピーク性能を維持 |
| 冗長性(Redundant) | 独立した2基のエンジンのように設計する | 通常は1つの装置として完全な並列処理を実行し、片方に障害が出ればもう片方が途切れず引き継ぐ |
人が引き継ぐ前提が無いため冗長性は最初から組み込まれています。片方が止まっても処理が途切れないので故障がそのまま運転の中断にはなりません。
既製部品から自社設計のシステムへ切り替えるときは、物理設計とアーキテクチャの両方を再検討する必要がありました。公式ブログに記載された高集積化の成果は次のとおりです。
- 乗客の体験を損なわずに大きな処理能力を出す
- バッテリー効率を最大化する
- トランクの空間を十分に確保する
- 静かに動作する
"Drawing from more than 200 million miles of fully autonomous experience, we engineer our compute around three non-negotiable requirements:"/"We have engineered our stack for ultra-low latency, minimizing the delay from first pixel to action."/"Unlocking this requires impressive raw compute power—which we’ve scaled 20x in just eight years—paired with a deeply optimized software stack to harness it efficiently."/"By integrating directly with the vehicle's liquid cooling system, we sustain peak performance whether navigating freezing Midwest winters or the blistering heat of Phoenix."/"Our compute is designed like two independent engines. While they normally operate as one unit running full parallel workloads, if one experiences a fault, the other seamlessly takes over."(three non-negotiable requirements 節)/"Evolving from off-the-shelf components to custom systems required rethinking our physical and architectural design. Our highly integrated system delivers immense processing power without compromising the rider experience, maximizing battery efficiency while preserving ample trunk space and running silently."(custom systems 節)— Waymo 公式ブログより公式情報を見る →
NVIDIAなど半導体メーカー7社との協業は続いている
Waymoは2026年8月20日の公式ブログで、自社シリコンの取り組みと並行して業界のリーダーと密に協業していると発表しています。そして、協業先のうち名前が出ているのは次の7社です。
公式ブログに名前が出ている協業先(掲載順)
| 企業 |
|---|
| AMD |
| Micron |
| NVIDIA |
| Samsung |
| Sandisk |
| Socionext(ソシオネクスト) |
| TSMC |
公式ブログには社名が記載されているだけで、どの会社がどの部品を担当するかは公式ブログで明らかにされていません。TSMCが今回の5nm ASICを製造していると判断することもできません。
自社チップの発表は外部調達をやめる話として受け取られる場合がありますが、公式ブログにそうした趣旨の記述はありません。専用化したのは複数あるカスタム部品の中の1つです。
"Along with our custom silicon efforts, we partner closely with industry leaders whose world-class computing solutions provide the powerful foundation needed to scale our technology efficiently. We are proud to work alongside a number of partners like AMD, Micron, NVIDIA, Samsung, Sandisk, Socionext, and TSMC to deliver the most capable autonomous computing system."(partners 節)— Waymo 公式ブログより公式情報を見る →
TOPSの演算精度は未公表で詳細はHot Chipsの講演へ
Waymoは、TOPSをどの精度の演算で数えたかをまだ明らかにしていません。公表されていない事項は次のとおりです。
- TOPSの演算精度(どの桁数の数値で算出した性能か)
- 5nm ASICの製造委託先とプロセス名
- ASICの搭載数・単価・量産規模
- 7社それぞれの担当領域
- ASIC以外を含むWaymo Driver全体の総演算性能
- Hot Chips講演の日付・登壇者・内容
Waymoは、計算基盤の取り組みをさらに知りたい人へ、Hot Chipsの講演への参加を呼びかけています。講演で話される内容はまだ公式ブログに記載されていません。
"If you're interested in learning more about Waymo's approach to compute, join us at our talks at Hot Chips"(末尾の案内文)— Waymo 公式ブログより公式情報を見る →
WaymoのASICは生センサーデータの前段処理を担う
Waymo ASICはコアML処理の手前で、lidar・レーダー・カメラの生データをさばく専用チップです。要点は次の3つです。
- 担当はコアML処理の手前にある工程で、運転の判断そのものを置き換えるチップではない
- 1000TOPS超はこのASICだけで前段処理とMLモデルに充てた性能で、システム全体の総計は明らかにされていない
- AMD・NVIDIAなど7社との協業は続いており、外部調達の置き換えは明らかにされていない
公式ブログが明らかにしていないのは演算精度と製造委託先と搭載数です。1000TOPS超をシステム全体や走行判断の性能と読むのは、公式ブログの記載と合いません。
FAQ
- WaymoのASICは何nmプロセスですか?
- 5nmです。Waymoが自社専用に設計したASICで、製造委託先やプロセス名は公表されていません。
- 1000TOPS超はどの処理に使われる数字ですか?
- 前段処理とMLモデルに充てたML性能は、このASICだけで1000TOPSを超えると公式ブログは明らかにしています。公式ブログはシステム全体の総計を明らかにしていません。Waymoは低バッチ領域で実効性能を出すため、スタック全体を最適化しているとしています。
- NVIDIAなどのチップは使わなくなるのですか?
- 外部の部品を使わなくなるとは述べていません。Waymoは自社シリコンの取り組みと並行して、業界のリーダーと密に協業しているとしています。協業先は、AMD・Micron・NVIDIA・Samsung・Sandisk・Socionext・TSMCの7社です。公式ブログは各社の担当部品までは明らかにしていません。
- カメラは何台接続されているのですか?
- 最新システムでは13台の高解像度カメラを同時にリアルタイム処理しています。Waymoはこの構成によって暗所での認識精度が上がり、従来型のカメラが見落とす環境の細部も認識できるとのことです。
関連する記事
 Waymoの自動運転タクシーにトヨタbZ4X、2027年に日本で初期運行トヨタとWaymoは2026年10月30日、Waymoの自動運転タクシーに使うトヨタbZ4Xを、2027年に日本で初期運行すると発表しました。車両は愛知県の高岡工場で、組み立てから自動運転機器の搭載まで一貫して生産します。2027年は試験・検証を含む段階で、両社は運行地域や料金をまだ公表していません。
 マレーシアの空港でAIチップ搭載サーバー30台を押収、今年5件目マレーシア・クアラルンプール国際空港の税関は2026年10月28日、約4,950万リンギ(約1,210万ドル・約19.03億円)相当の先端AIチップ搭載サーバー30台を押収したと発表しました。サーバーは電子部品と申告され、マレーシアを中継してアジアの別の国へ再輸出される予定でした。同じ組織が関わる押収としては今年5件目です。
 WaymoとUberの独占が2028年初めに終了し、自社アプリでも配車Waymoは2028年1月に、アトランタとオースティンで自社アプリでの配車を開始します。終わるのは提携ではなく独占であり、Uberで呼べる数百台は少なくとも2028年5月まで残ります。提携解消の社内議論はFinancial Timesの報道にとどまります。
 AI需要でメモリ価格が5倍、Appleとメモリメーカーの力関係が逆転2026年10月28日付のWSJによると、AIデータセンター向けの需要でフラッシュメモリの価格がこの1年で5倍になり、Appleとメモリメーカーの力関係が入れ替わったとのこと。クラウド大手の購入量はいまやAppleの2倍で、iPhone 17 Proの容量を256GBから2倍に増やす分の原価は15ドル(約2,360円)から66ドル(約1万380円)に上昇しています。